DPDK 把网卡收包、协议解析和发送调度交给了应用,DNS 的 UDP 查询因此可以绕开内核路径。TCP 请求却会立刻把设计拉回现实。它需要三次握手、连接状态、重传和按长度读取消息,应用不能只拿到一个完整报文就结束工作。
先把问题放回 DPDK
我把 2021 年的一篇部署记录和 dudns 当前代码对了一遍。两份材料面对的是同一个问题,做法却分成两条路。
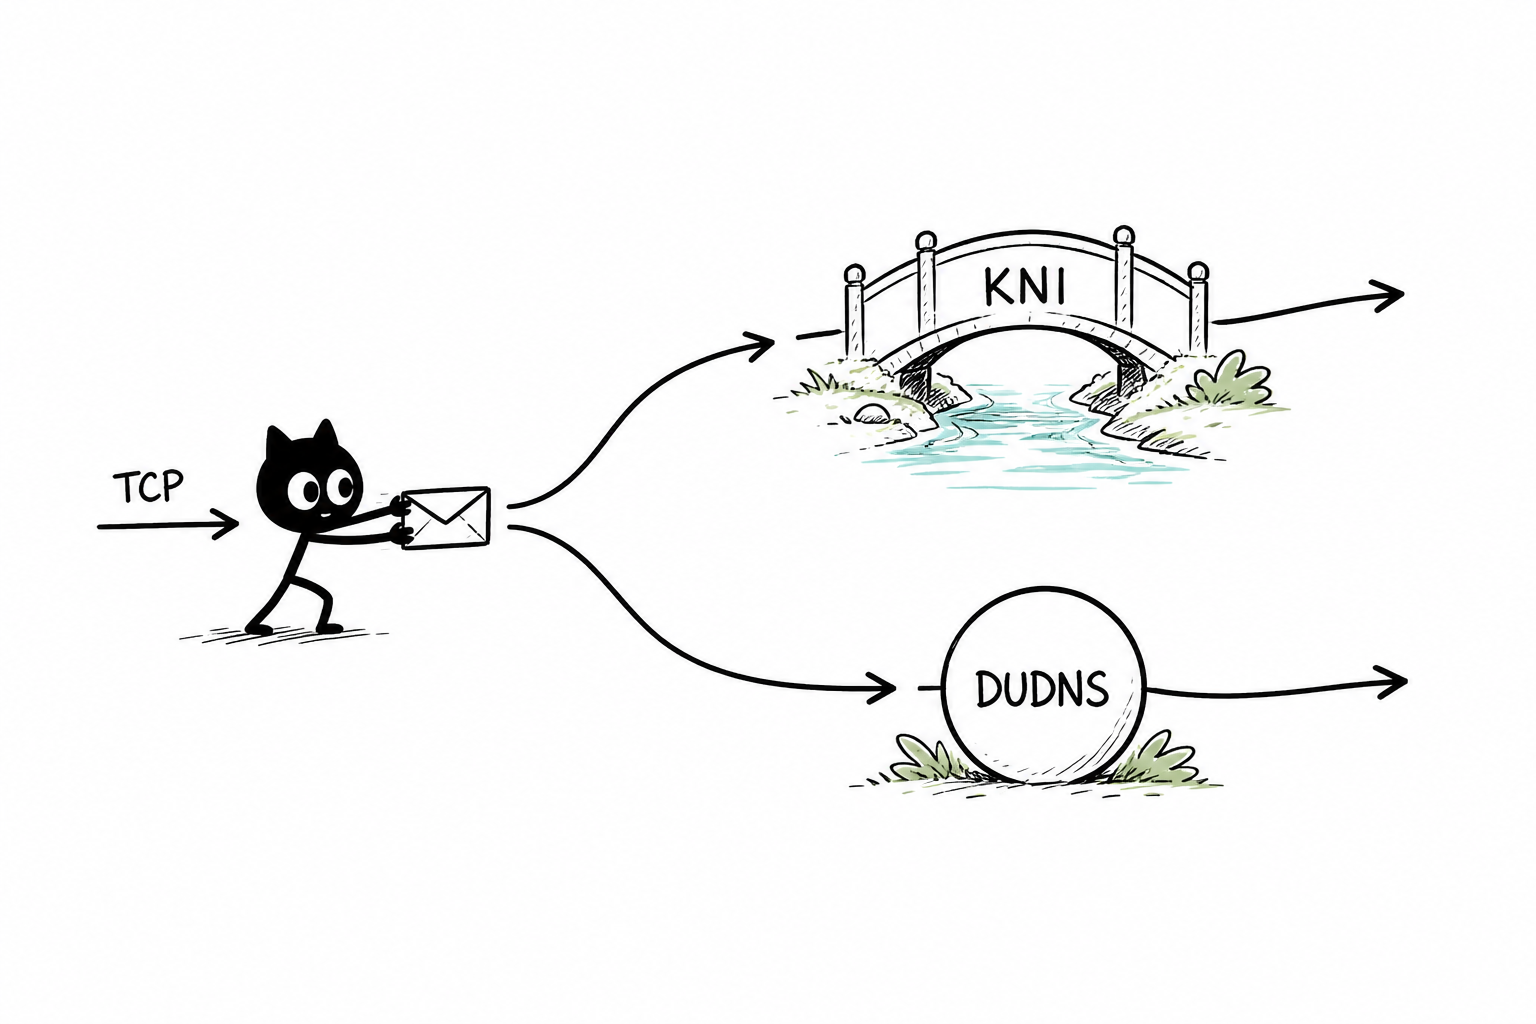
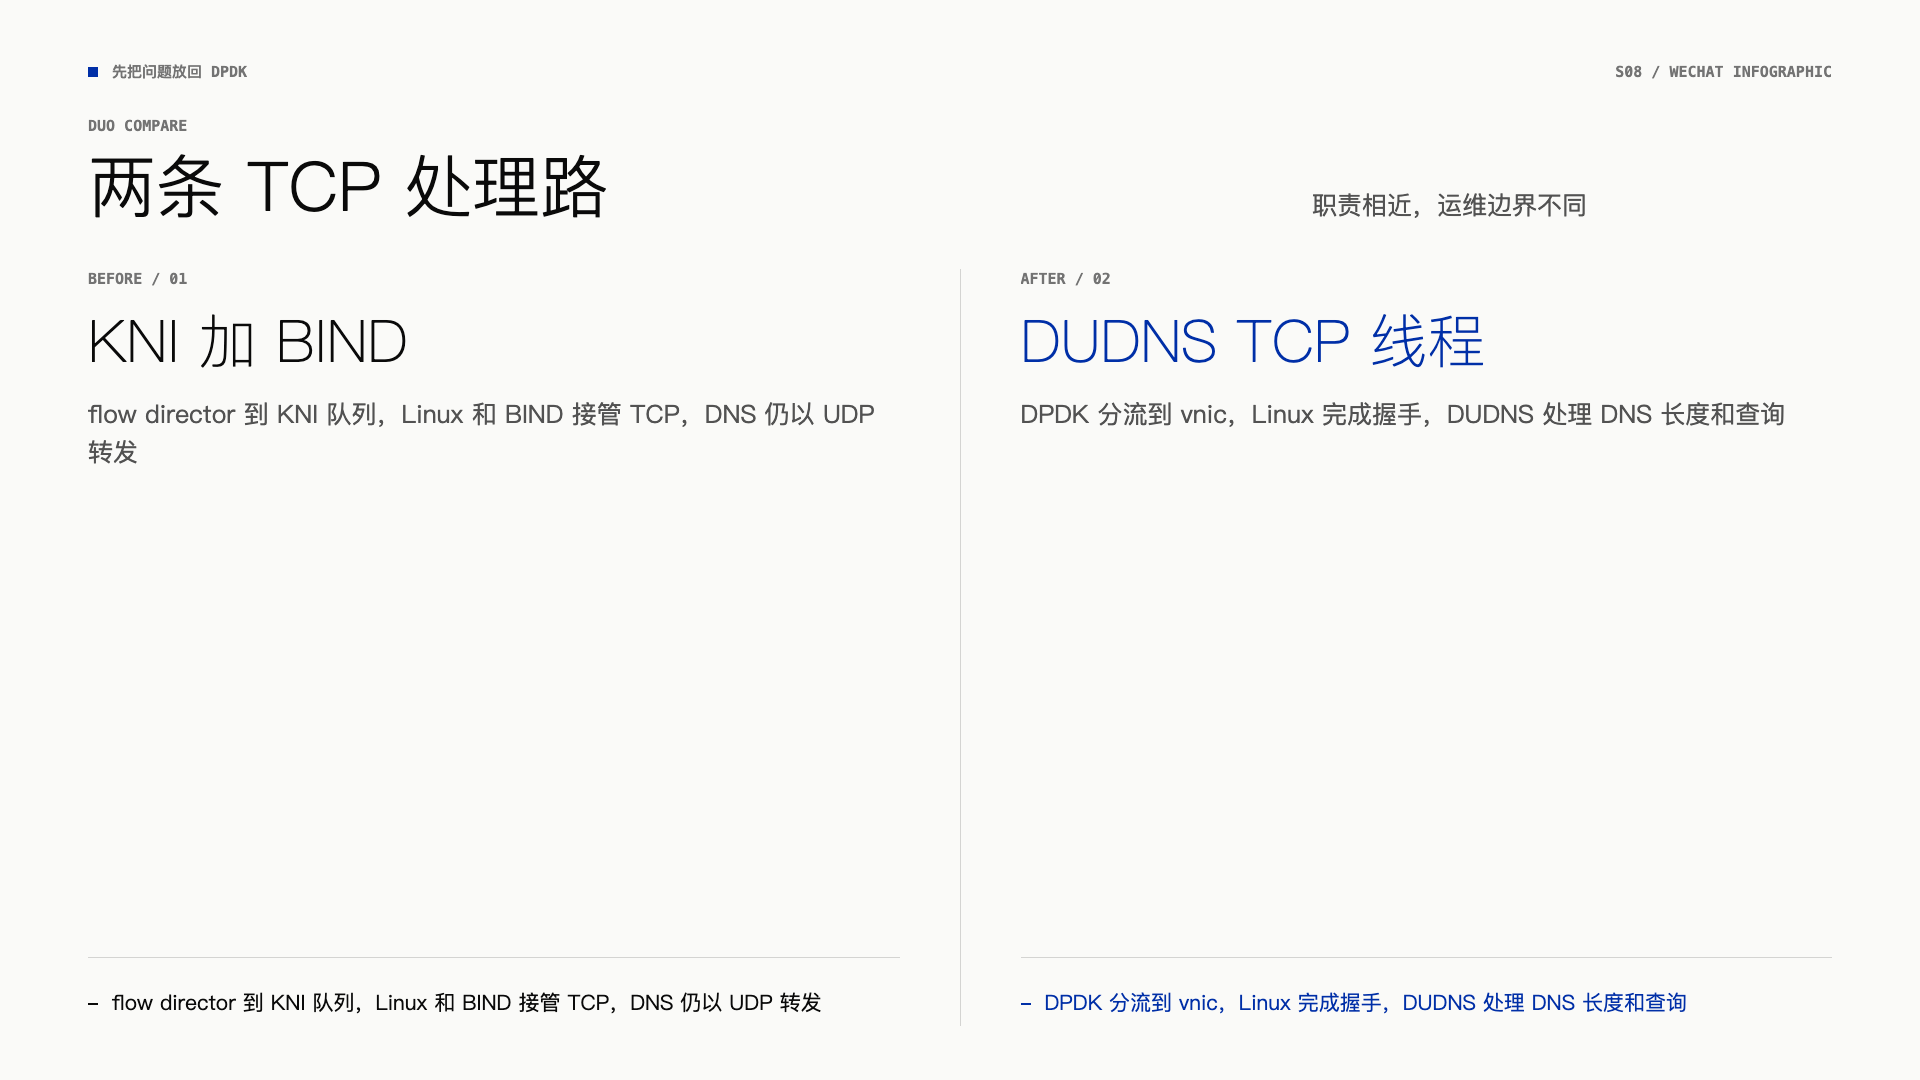
DPDK 本身不提供 TCP 协议栈。DNS 的大多数请求仍走 UDP,TCP 主要在响应过大或进行主辅同步时出现。旧文章因此把 TCP 看成低比例流量,选择 KNI 让 Linux 接管连接。当前 DUDNS 则保留 DPDK 的收包和分流,另起一个 TCP 服务线程,用系统 socket 接收连接,再把 DNS 消息交给自己的查询代码。
这里要先分清一个容易混淆的词。DUDNS 这条路没有在用户态重写 TCP 三次握手,也没有实现一套新的 TCP 协议栈。握手、重传和拥塞控制仍由 Linux 内核完成。应用自己掌握的是监听位置、DNS over TCP 的消息边界、查询处理和响应发送。
第一条路由 KNI 交给 BIND
旧文章的做法很直接。网卡用 flow director 把目的为 VIP 的 TCP 报文送到 KNI 队列,KNI 再把报文放进 Linux 的 vEth0。BIND 监听 53 端口,接住完整的 TCP 会话,把查询转成 UDP 发给另一台 DNS 实例。对端返回 UDP 响应后,BIND 再封装成 TCP 响应,经 vEth0 或外网网卡发回客户端。
这条路的动作可以压缩成三段。第一段是 DPDK 到内核,报文从 mbuf 变成内核 skb,进入 BIND 的 socket。第二段是 BIND 到 DPDK DNS,转发请求走内核路由,返回包重新进入 KNI 的发送队列。第三段是 DPDK 发包,flow director 根据目的端口或目的地址把 UDP 响应交给负责 DNS 的 worker。
部署时有几个条件不能省。BIND 的 forward 地址决定请求从 vEth0 还是其他网卡出去。所有 VIP 要加到 Linux 的 lo 设备,BIND 才会接受目的地址是 VIP 的连接。响应出口还要有访问公网的路由,否则 TCP 三次握手可能成功,响应却回不到客户端。文章给出的验证命令是 dig +tcp @vip jiankong.jdgslb.com。
KNI 方案的优点在于少写协议代码。BIND 已经处理了连接、消息长度和异常关闭,DPDK 侧只需维护流量分类和 UDP DNS。它的代价也很明确。每个 TCP 报文都要经过 KNI 和内核网络设备,路由、VIP、BIND 配置以及出口权限要一起维护。故障排查时,网卡规则、KNI 队列、vEth0、内核路由和 BIND 日志缺一处都可能让请求停住。
第二条路由 DUDNS 自己接住请求
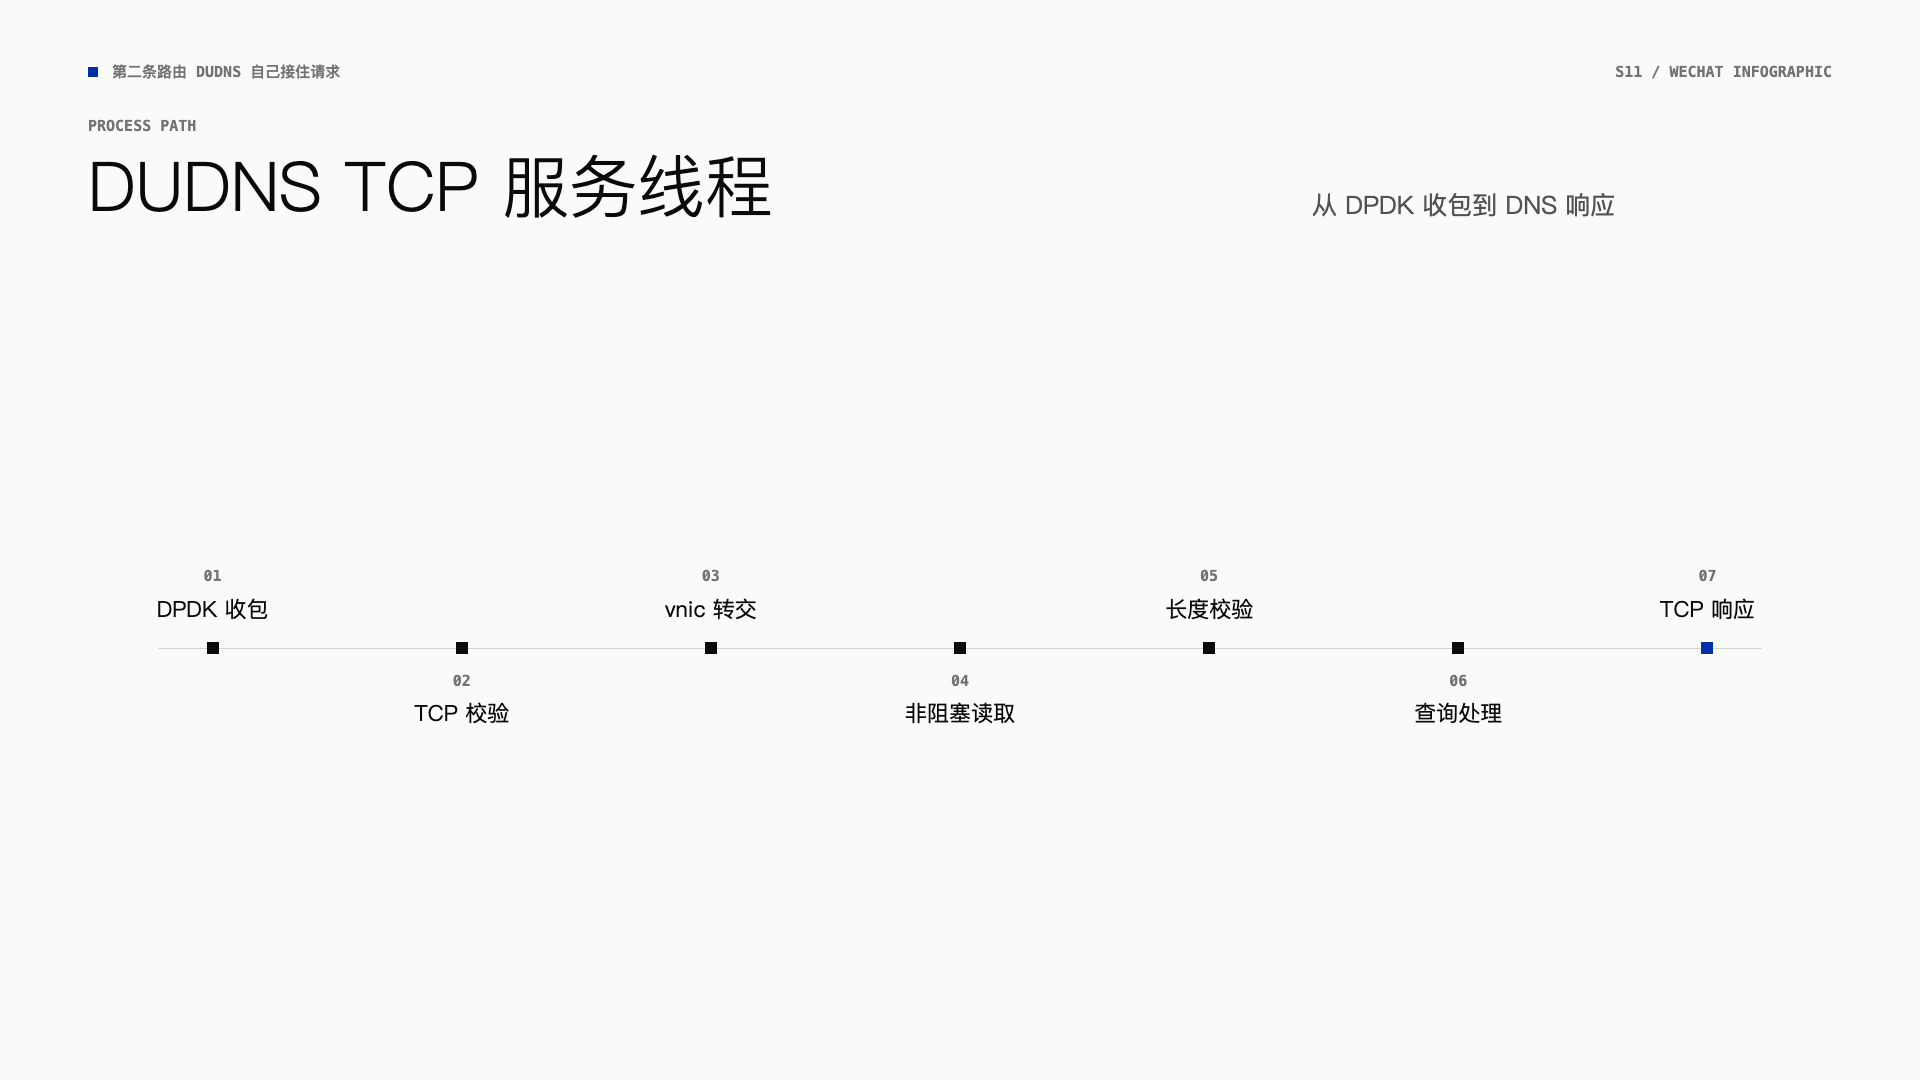
dudns 的当前实现把 TCP 服务线程作为 DPDK 进程的一部分启动。main.c 在 TCP 开关开启后调用 pal_tcp_server_threads_init,把线程放在 NUMA 1 的一个 CPU 上。线程初始化查询上下文,创建 libev 事件循环,然后为配置中的每个 IPv4 或 IPv6 VIP 建立监听 socket。
收包路径仍从 DPDK 开始。pal/ip.c 会检查 TCP 校验和、首部长度和标志位。开启限速时,SYN 还要通过每秒计数限制。通过检查的报文由 pal_send_to_vnic 复制到 vnic 的 KNI 队列,Linux 协议栈完成握手后,DUDNS 的 TCP 服务线程从非阻塞 socket 读到连接。
连接建立后,dudns_tcp_server.c 先读两个字节的网络序消息长度,再按长度补齐 DNS 查询。代码拒绝小于 DNS 首部、根域名、类型和类别字段总和的消息,也拒绝超过 TCP_MAX_MESSAGE_LEN 的消息。当前配置头把这个上限设为 65535 字节。
消息完整后,服务线程用 getsockname 找到目标 VIP,在 VIP 哈希表中定位服务和视图,再调用 dudns_query_process。本地权威数据可以直接生成响应。需要转发时,send_pkt_to_forward 把查询上下文放进转发队列,队列由查询名和类型计算出的哈希选择。转发线程既能走 UDP,也能为 TCP 查询建立上游 TCP 连接,收到结果后回到原连接。
响应阶段仍要遵守 DNS over TCP 的两字节长度前缀。代码先写长度,再用 writev 或 write 发送消息,遇到 EAGAIN 或 EINTR 就等待下一次可写事件。连接拥有独立的 region,读写超时、读取失败、响应完成都会关闭 socket 并释放这块内存。当前实现还记录 VIP 和 worker 两级的 TCP 收发、丢弃以及转发统计。
这条路把 DNS 查询逻辑留在同一个进程里,视图、ACL、缓存、限速和日志可以复用 UDP 查询使用的对象。代价是维护面变大。连接数上限、超时、非阻塞读写、短读、半包、异常关闭和上游转发都要有明确处理。runtime/conf/dudns.conf 里的示例给出了 10240 个连接和 5000 毫秒超时,TCP 开关与 SYN 限速仍由配置决定,实际值需要按机器资源和业务流量调整。
两条路怎样摆在一起
如果 TCP 只占很小比例,需求主要是大响应和少量同步,KNI 加 BIND 更容易先跑起来。团队可以把精力放在 flow director、vEth0、路由和 BIND 的可观测性上,减少自研连接处理代码。
如果 TCP 查询需要和 DUDNS 的视图、ACL、缓存、转发和统计保持同一套判断,服务线程方案更顺手。它省掉了独立 BIND 实例和跨进程配置,但要把连接资源和异常路径纳入容量评估。仓库没有提供两种方案的压测数据,所以延迟和吞吐不能从代码推断,应该用真实的 TCP 查询长度、并发连接和转发比例做测试。
还有一个边界需要单独记下。普通 DNS over TCP 查询走 dudns_tcp_server.c,AXFR 和 IXFR 使用 xfr_tcp.c 的传输流程,配置项里的 xfr-max-tcp 也单独限制同步连接数。把这两类流量混在一个连接上限里,会让容量判断失真。
落地时先看四件事
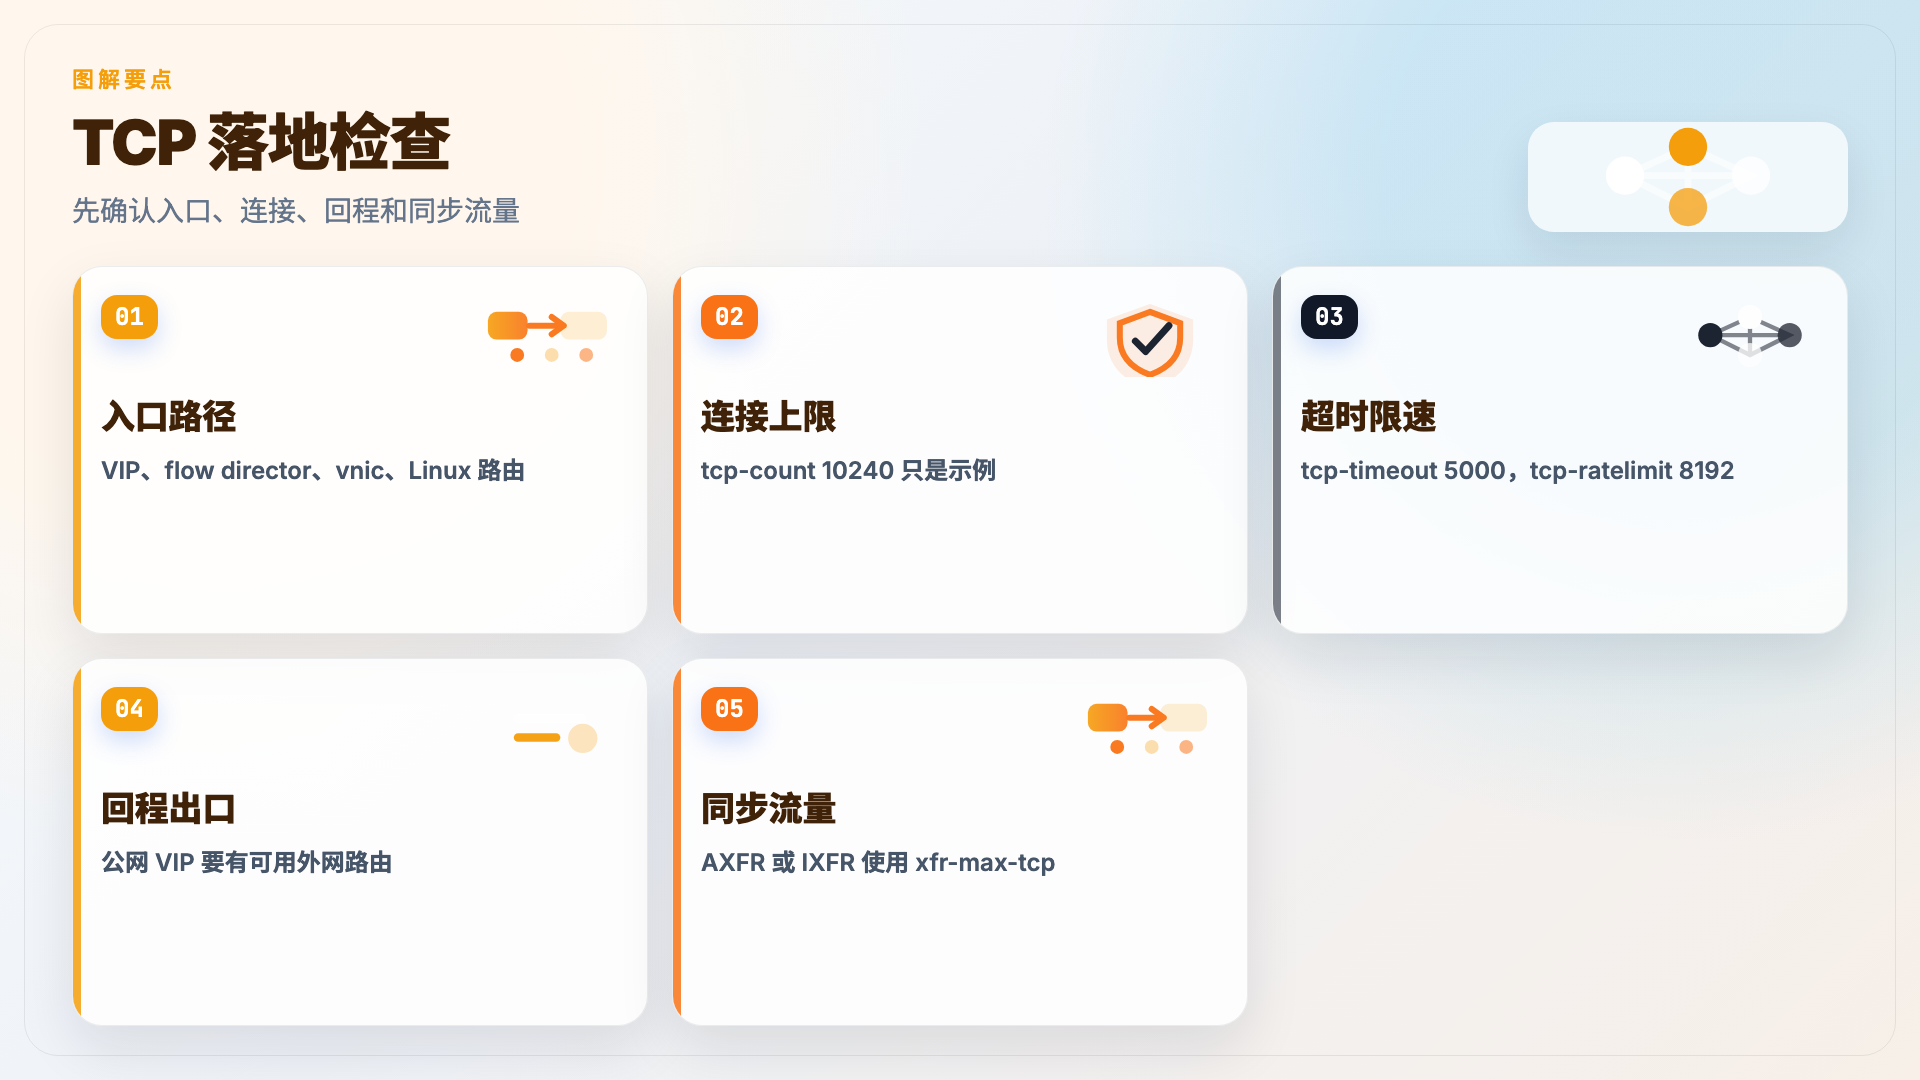
第一件是报文从哪儿进入。确认 TCP 的目的 VIP、flow director 规则、vnic 名称和 Linux 路由都指向同一条路径。KNI 方案要检查 BIND 监听和 forward,DUDNS 方案要检查 TCP 服务线程是否在配置的 VIP 和端口上启动。
第二件是连接怎样退出。给出最大连接数、读写超时和 SYN 限速的数值,观察达到一半连接上限后的超时策略。DUDNS 当前代码在连接数较高时把新连接的初始等待时间缩短到 1 秒,这会直接影响慢客户端的成功率。
第三件是响应从哪儿返回。公网 VIP 的 TCP 响应必须经过有外网权限的出口。转发场景还要核对 forward IP 选择的网卡,避免请求从 vEth0 出去,响应却从另一张没有回程路由的网卡离开。
第四件是把普通查询和区域同步分开看。普通查询关注大报文、半包和客户端连接,AXFR 或 IXFR 关注长连接、文件大小、并发数和超时。两种方案都能解决 TCP,适用条件却不一样。
参考资料
- 2021 年部署记录 基于 dpdk 实现的 dns tcp 解决方案