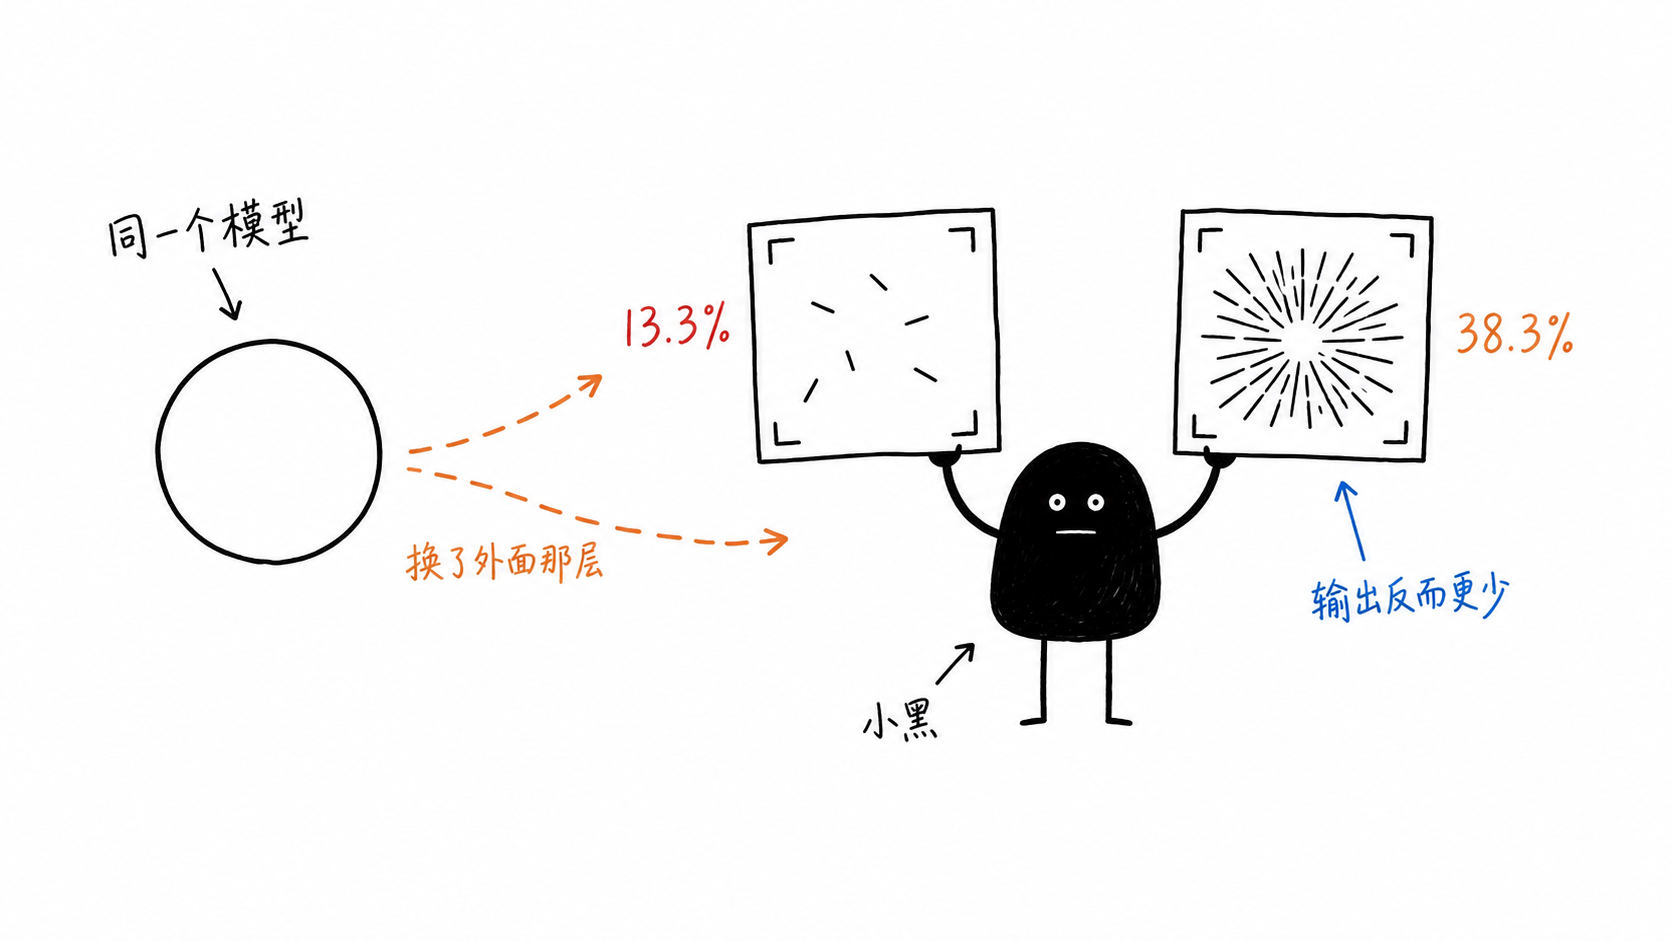
8 月 20 日 OpenAI 把驱动 Codex 的 harness 开源了,仓库是 openai/codex,Apache-2.0,两天冲到十万多 Star。这件事本身讨论得很多,但官方博客里最值得琢磨的不是开源这个动作,而是顺手放出的一组数据。
在 ARC-AGI-3 上,GPT-5.6 Sol 跑基准官方 harness 得 13.3%。OpenAI 只改了两处 harness 行为,同一个未做任何改动的模型跑到 38.3%,同时输出 token 降到原来的六分之一。
分数涨三倍、token 降六倍同时发生,这个组合很反直觉。想更准通常要多想,多想就要多花 token。两者一起往好的方向走,只有一种解释成立,就是原先那些 token 大量花在了重复劳动上。
那两处改动是保留推理链和上下文压缩。这篇想把它们的原理、作用,以及和其他 harness 的差别讲清楚。
先纠正一个容易读错的地方
很多转述把这事写成「OpenAI 给 harness 加了两个新功能」。实际是反过来的。
这两项在 Codex 和 ChatGPT 里本来就默认开着。13.3% 那一次是跑 ARC-AGI-3 的官方 harness 得到的,那个 harness 的做法是丢弃推理链,并且对超过 17.5 万 token 的历史做滚动截断。OpenAI 做的事情,只是把这两项换成自己 harness 的既有行为。
所以这组数字的正确读法是,任何 agent 类基准分数本质上是一份 harness 报告,不是模型报告。
两个机制补的是两个不同的漏
保留推理链管的是一次任务内、跨工具调用的短程连续性。上下文压缩管的是几十轮之后、历史超窗的长程连续性。它们能叠加出这么大的收益,正因为攻的位置不重合。
分开看。
保留推理链
推理模型每轮会产生内部 reasoning token。传统 Chat Completions 的语义是一轮结束推理即丢弃,只留下可见的 message。这在纯对话场景没什么问题,模型本来就被训练成不依赖上一轮推理也能答好。
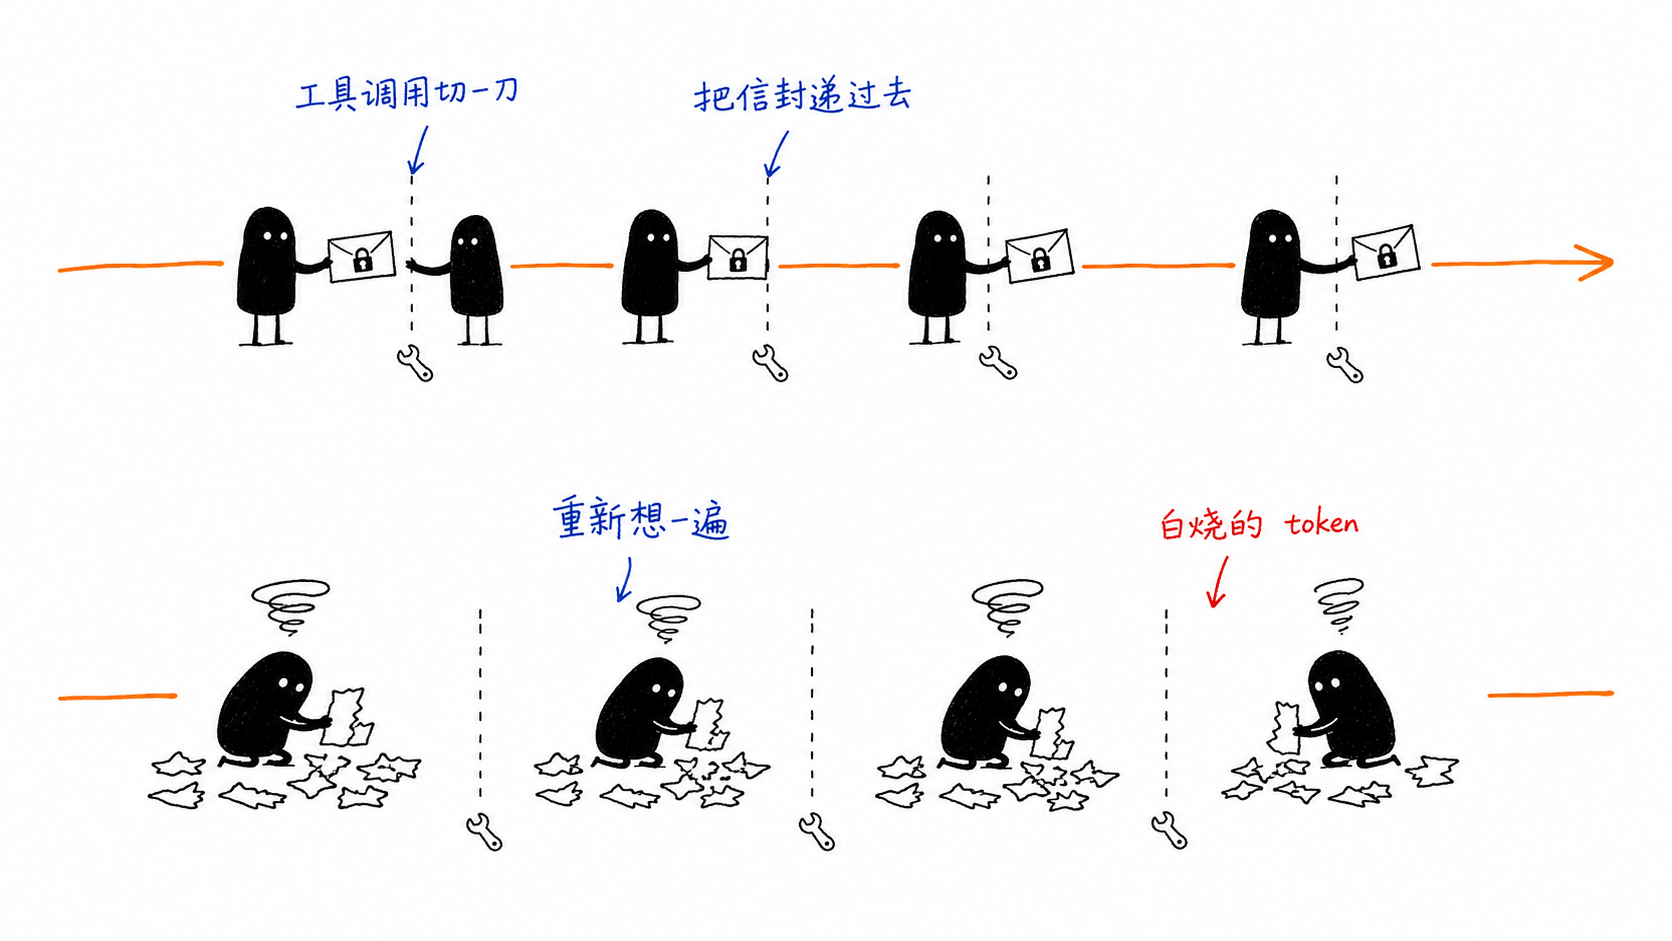
但 agent loop 的结构不是对话。它是模型思考、发起 tool call、harness 执行、把结果塞回去、模型再思考。一次「任务」被工具调用切成了很多次独立的 API 请求。 如果每次请求都丢掉推理,模型每收到一个工具结果,都得从可见痕迹里重新推导自己刚才在干什么、为什么这么干。
Responses API 是目前唯一能跨请求携带 CoT 的端点,两条路走得通。
一条是有状态,store: true 配 previous_response_id,推理状态留在服务端,harness 什么都不用管,下一轮引用上一次的 response id 即可。
另一条是无状态,store: false 配 include: ["reasoning.encrypted_content"]。服务端不留任何东西,harness 自己把加密后的推理块在下一轮请求里回传。
Codex 走的是第二条。这个选择是为 ZDR 和合规场景服务的,推理内容对 harness 自己也是密文。代价在后面会看到,它直接决定了 Codex 的压缩产物为什么是一个你看不懂的东西。
工程上有几个硬约束值得记住。回传的 reasoning item 必须带上 encrypted_content,只回传一个裸的 rs_ id 会拿到 400,报 not found or has expired。id 必须唯一。function_call 和 function_call_output 必须严格成对,会话结构不能破。这些正是 harness 该替你干的脏活。
为什么效果这么大
关键证据是那个六倍的输出 token 下降。
如果收益来自「模型变聪明了」,token 应该涨而不是跌。跌了六倍说明之前大量输出是在反复交同一份作业。丢弃推理不只让模型显得笨,还让它把算力烧在重新想通已经想通的事情上。
再叠一层。重新推导每次的结论未必一致,多轮之后表现出来的就是方向漂移和绕圈。这类失败很难归因,因为每一步单独看都合理。
为什么 ARC-AGI-3 上差距特别夸张
这是个多步交互式基准,进展只存在于模型的推理里,没有文件、没有 diff 可以回头重读。丢掉推理等于每一步都失忆重来。
编程任务其实没这么惨。计划的一部分物化成了代码、文件和 git 状态,模型重读工作区能捞回一些。所以别把 13.3% 到 38.3% 直接外推成自己日常编码的收益预期,那是最坏情况下的放大倍数。但方向是对的,工具调用越密集、单步产物越不落盘,收益越接近这个量级。
上下文压缩
历史超窗时有两种处理方式,选哪种决定了你丢掉什么。
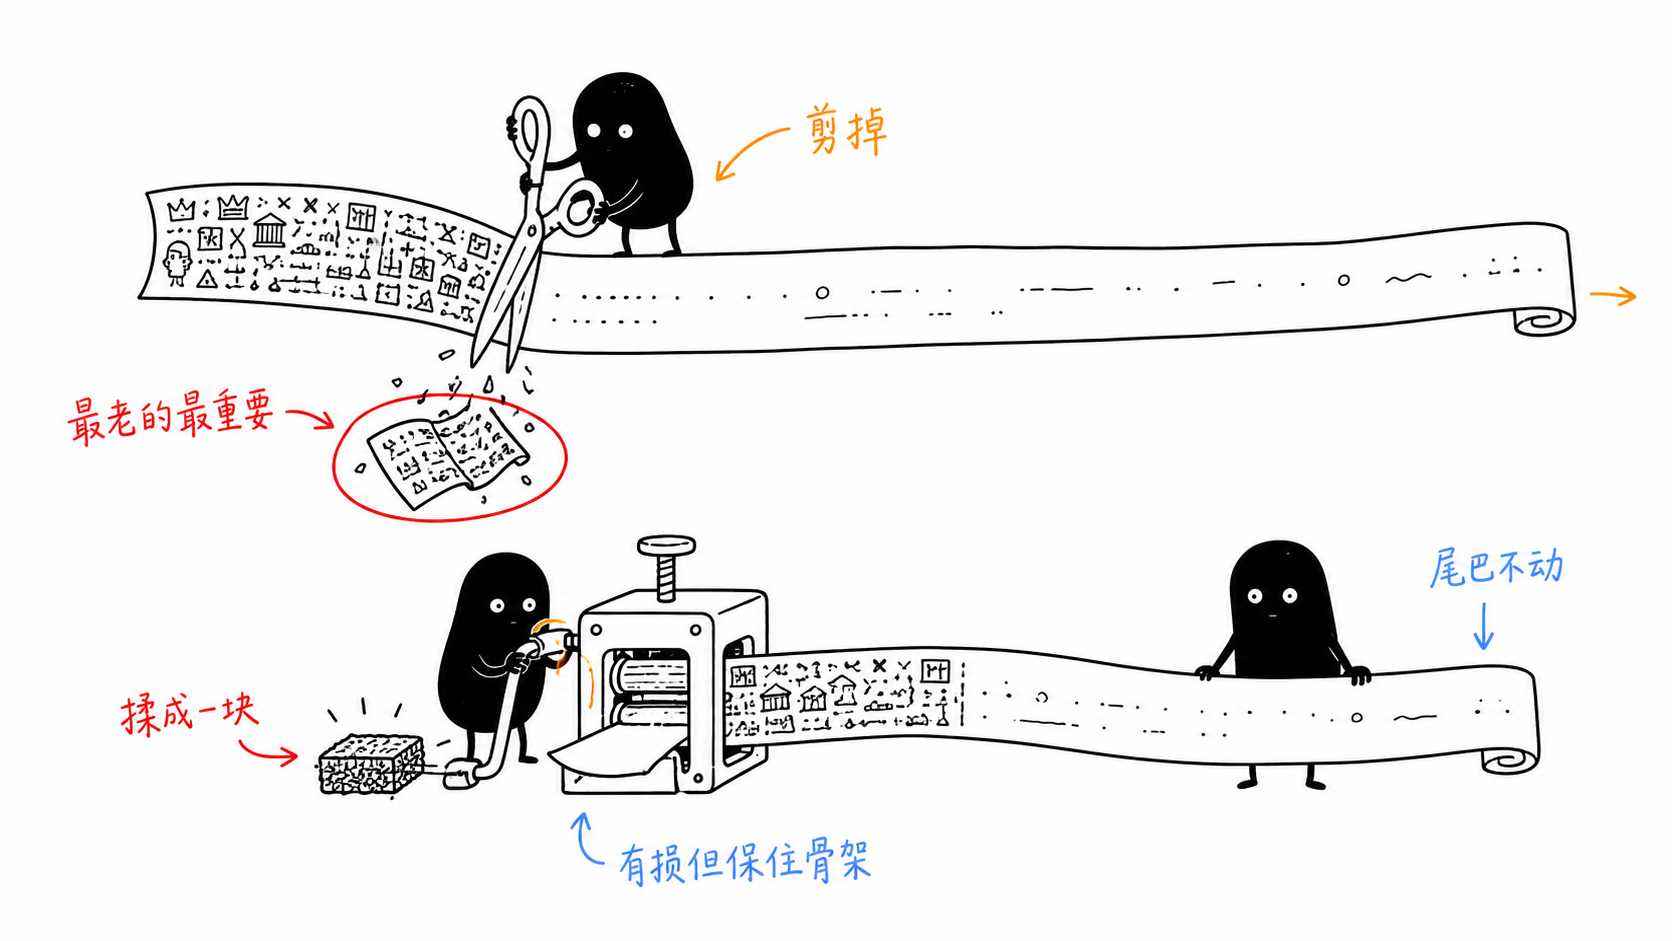
滚动截断。超过 N token 就从最老的开始丢。ARC-AGI-3 官方 harness 就是这么干的,阈值 17.5 万。成本几乎为零,实现几行代码。问题是它丢的是头部,而头部通常装着任务陈述、约束条件、最早那批架构决策。那是整段历史里单位 token 价值最高的部分。
压缩。花一次额外的模型调用,把旧历史摘要成一个可携带的产物,再接着往下跑。有损,但损的是细节而不是骨架。
一句话概括这个取舍。截断是无损地丢掉最重要的部分,压缩是有损地保住全局。
Codex 的具体做法
Codex 保留一段未压缩的尾部,第三方测出来大约两万 token 不参与压缩。这条设计的作用是压缩后的第一轮不掉状态。手上正在做的事完整保留,压缩只作用于已经结案的历史。实测反馈说 Codex 压缩后的对话延续比较顺,多半就是这个尾部在起作用。
阈值可调,~/.codex/config.toml 里有 model_auto_compact_token_limit 和 model_context_window,也可以手动 /compact。压缩 prompt 能用文件覆盖,标注是 experimental。
一个反面细节。社区报过一个 bug,把 model_context_window 设得过大之后,首次溢出触发 fill_to_context_window,token 计数被永久污染读成接近零,自动压缩此后再也不触发。这个坑说明压缩阈值必须留足头寸。压缩本身要生成摘要、要接新指令和工具输出,卡在窗口极限才触发就来不及了。
与其他 harness 的区别
对比 ARC-AGI-3 官方 harness
丢弃推理加滚动截断。这不是设计失误。基准 harness 追求的是可比性和中立,它必须对所有模型一视同仁,所以只能选最朴素的策略。
理解这一点之后,看 agent 类榜单的姿势应该变一变。先问它用的什么 harness,再看分数。
对比 Claude Code
两边的架构其实收敛得很像。一个决定何时再调模型的 loop、一个管压缩和记忆的 context manager、一个带描述和 schema 的工具注册表、一个拦截工具调用的审批系统。真正拉开差距的是更细的地方。
- 压缩产物形态。Codex 是加密的不透明块,Claude Code 是人类可读的 compaction block。
- 可定制性。Codex 只能改阈值、覆盖压缩 prompt,Claude Code 可以通过
instructions或者往 CLAUDE.md 里写压缩指令来干预。 - 压缩前是否剪枝。Codex 原样压缩整段对话,Claude Code 会先走多步流程清冗余再压。
- 压缩后的尾部。Codex 留两万 token 不压,Claude Code 没有同等机制。
- 压缩后项目指令。Claude Code 会重新加载 CLAUDE.md,Codex 只发增量。
- 大工具输出。Codex 头尾截断、中段直接丢,Claude Code 溢写到文件,后续还能检索。
- 同等任务 token 量。Claude Code 大约是 Codex 的三到四倍。
这张清单里最值得注意的不是谁赢,而是两种哲学的代价对称。
Codex 的加密块换来了合规友好和 KV cache 效率,代价是你无法检查也无法干预它压缩掉了什么。Claude Code 的可读块换来了透明和可调,代价是 token 开销高得多。harness 做的事更多,context 预载、子 agent 派生、自动验证轮次,这些都要你付钱。
信息损失这件事两边都没解决。上下文窗口有限,摘要必然有损,500K 或者 1M 窗口只是把问题推后,不是消掉。
实测口径上也有分歧。有测评说 Codex 压缩后状态延续更顺,也有长会话使用者反馈 Codex 中段消失、架构记忆随之丢失,而 Claude Code 能跨二十多小时的会话记住前一天解过的同类 bug。差异大概率来自任务形态。工具输出大、需要回捞中段细节的场景对 Codex 不利。
对比 OpenCode
这个例子适合当反面参照。
OpenCode 对所有 Responses API 路径硬编码 store: false,同时捕获了 response.id 却从不作为 previous_response_id 用。全代码库搜 previous_response_id 零匹配,目前还是个 open feature request。结果是每一轮都要把完整历史全量重新序列化。
它并没有丢掉推理连续性,加密回传那条路是走通的。但它放弃了服务端状态复用带来的成本优化。
这个例子最能说明问题的地方在于,retention 和 compaction 都是 harness 的实现选择,不是模型自带的能力。同一个模型接不同 harness,行为和账单完全是两回事。
落到自己手上
如果你要基于开源 harness 做集成,三条可操作的。
工具调用密集的 loop,务必回传 reasoning item。这是收益最大、改动最小的一处。别信「多轮对话不需要回传推理」那条建议,它只适用于无工具的纯对话,一旦这一轮里有 function call,推理项就必须带上。
压缩阈值留足头寸。别顶着窗口上限设。压缩自己要花 token,后续还要装新指令和工具输出。
别指望调大窗口替代压缩。1M 窗口只是延后问题,而且噪声、过期、重复的上下文会主动伤害表现,不是中性的。
最后回到开头那组数字。它真正说明的事情是,agent 工程不等于 prompt 工程。一个设计糟糕的 harness 能让很强的模型表现得很差,而 harness 这一层现在是开源可读的。codex-rs 摆在那儿,你能看见 Codex 到底怎么决定给模型看什么。这比多开源一个模型权重有用得多。
数据来源。ARC-AGI-3 的 13.3% 到 38.3% 和六倍 token 出自 OpenAI 官方博客 Codex as a platform;Responses API 的机制与约束出自 OpenAI 官方文档和 cookbook;Codex 与 Claude Code 的压缩细节对比大量来自第三方实测和逆向分析,非官方口径,「两万 token 尾部」「三到四倍 token」这类数字应当只当量级参考。config key 名称随版本变动,以本机 codex --help 和仓库当前文档为准。