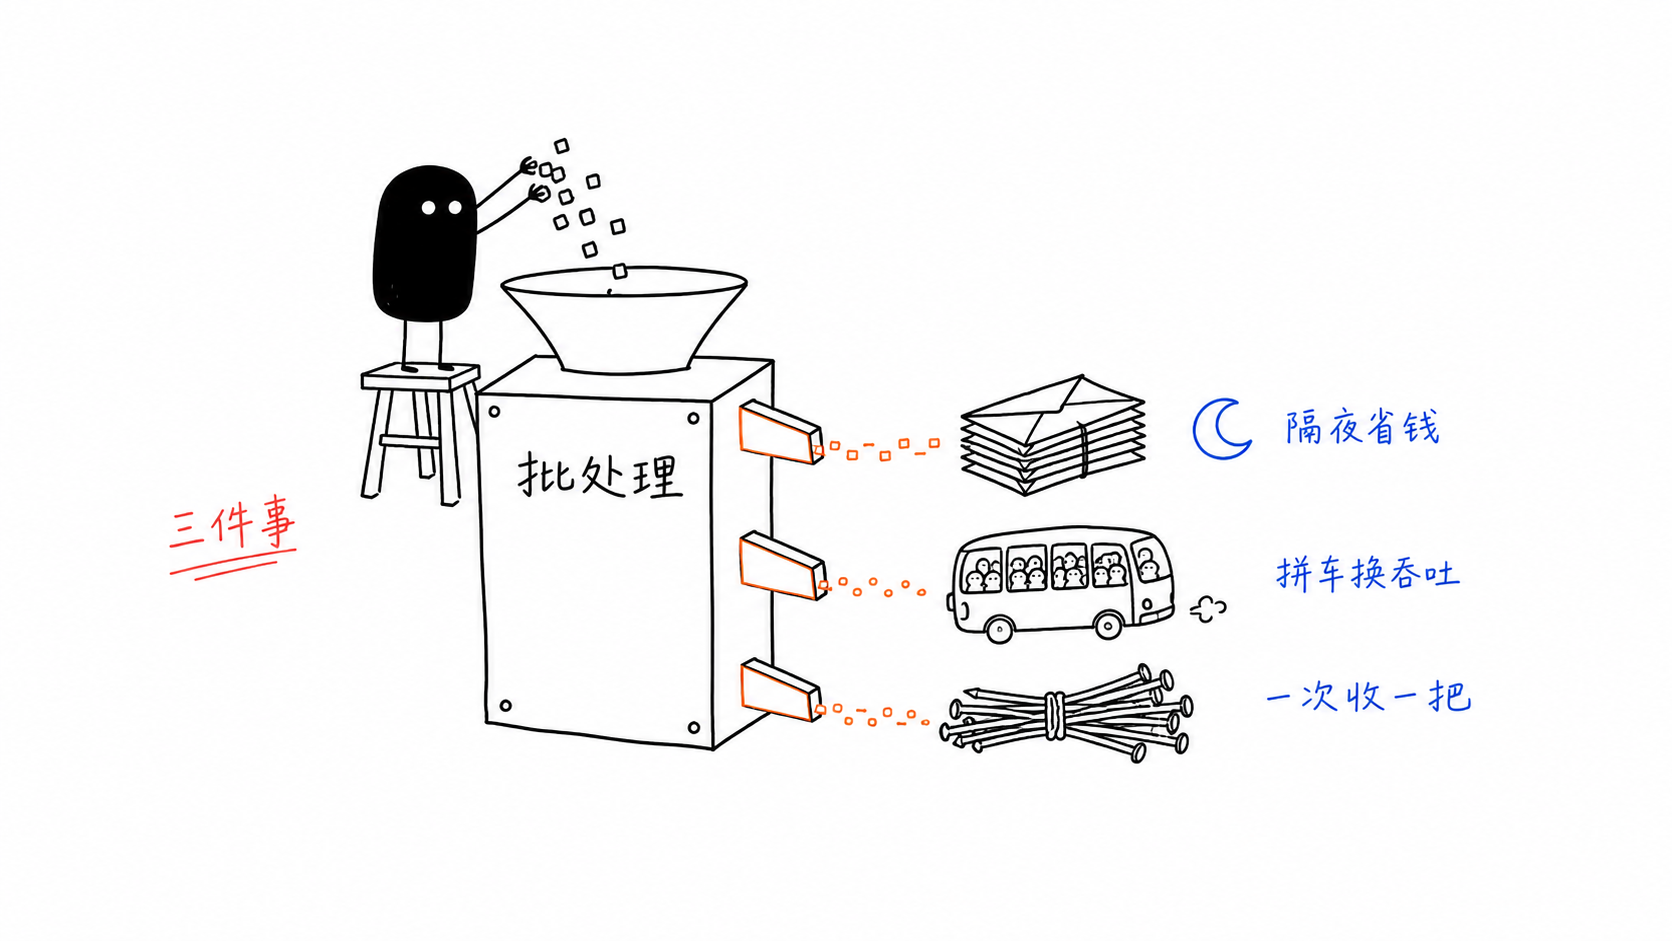
聊 AI 网关时,「批处理」这个词出现的频率很高,但它几乎从来不指同一件事。有人说的是给模型厂商提交一个隔夜跑完的 JSONL 文件,有人说的是 vLLM 里把多个请求拼进同一次前向传播,还有人说的是网关把一百个 embedding 请求合成一次调用。三件事的层次、收益和代价完全不同,混在一起谈必然得不出结论。
先把它们拆开。
一、离线 Batch API:用延迟换成本
OpenAI、Anthropic、Gemini 都提供 Batch 端点。使用方式是把成千上万条请求打成一个 JSONL 文件提交上去,供方在一个较宽的窗口(通常承诺 24 小时内)异步完成,价格约为同步接口的五折,而且不占用同步接口的 TPM/RPM 配额。
网关在这条路径上做的是路由与托管,不是加速:
- 策略判定。按 tag、模型、租户判断某条流量「是否允许慢」,可以慢的降级走 Batch。
- 攒批。把零散的单条请求缓冲到一定条数或时间窗,再打包提交。
- 状态托管。Batch 是异步作业,网关要代管 job id、轮询状态、重投失败条目、把结果通过 webhook 或回调吐回业务方。
- 计费归属。批量作业跑完是一笔总账,网关需要按条把 token 成本拆回发起方。
这是纯粹的成本优化。适合离线评测、数据清洗、批量打标、日志摘要这类没有人在屏幕前等结果的活。
二、连续批处理:用调度换吞吐
这是 vLLM、TGI、SGLang 这些推理引擎的核心机制,发生在网关下游,但网关的行为会直接决定它跑得好不好。
原理来自一个硬件事实:GPU 做矩阵乘的时候,一次算 1 个序列和一次算 64 个序列,耗时差别远小于 64 倍。decode 阶段每生成一个 token 都要把整个模型权重从显存搬进计算单元,这部分开销与批大小无关,算力其实大量空转在等显存带宽。把多个请求的 token 拼到同一次前向传播里,权重只搬一次,摊薄给整批。
「连续」的关键在于不等整批做完。传统静态批处理要等批内最长的那条序列生成结束才能换批,短请求被长请求拖着一起等。连续批处理在每个 decode step 结束后就调度一次:完成的序列踢出,新到的请求插进来。这个思路由 Orca 论文提出(也叫 iteration-level scheduling),vLLM 把它和 PagedAttention 结合后成为事实标准,吞吐提升可以到一个数量级。
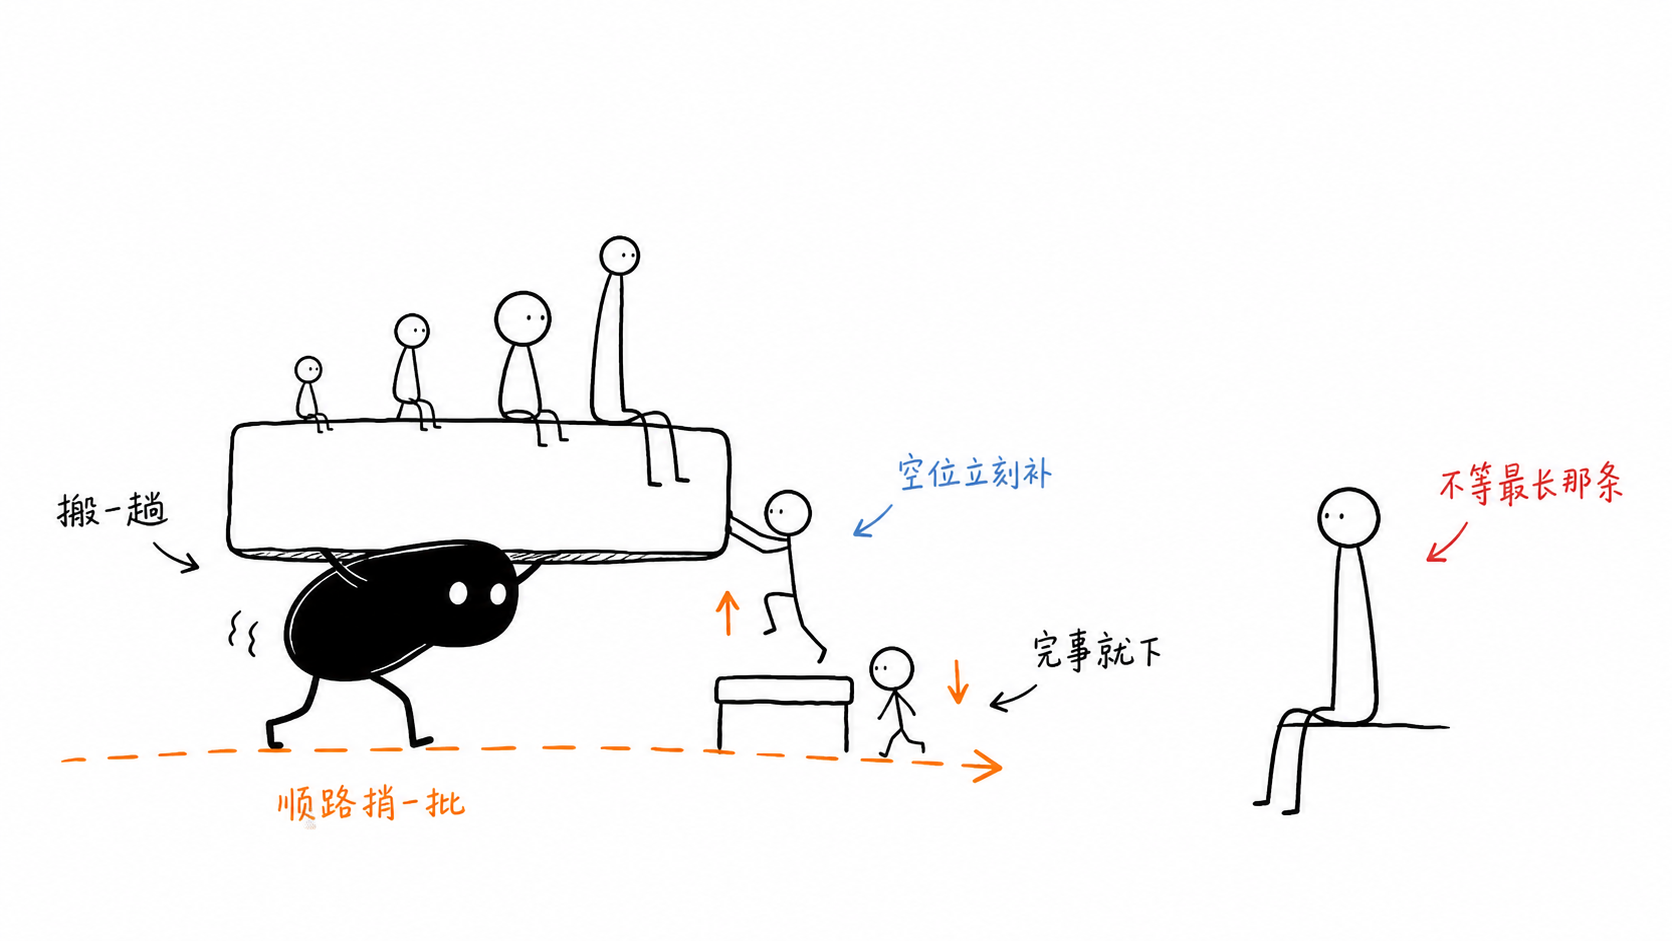
网关在这里的职责是不要破坏它:
- 保持流式透传,不要缓冲整个响应。缓冲会让 TTFT 指标失真,也白白吃掉引擎的流水线优势。
- 负载均衡不能按连接数或轮询。要按「排队中的 token 数」或「KV cache 占用率」来选实例,否则一个热点实例的批被塞爆,邻居还在空转。
- 前缀感知路由。把共享同一段 system prompt 的请求打到同一实例,命中 KV cache 前缀复用。这一条在 Agent 场景下收益极大,因为同一个 Agent 的 system prompt 往往长达几千 token 且完全一致。
- 长短请求分池。一条 32K 输入的 prefill 会拖慢同批里所有短请求,也就是队头阻塞。按输入长度分流到不同实例组,比在引擎里调参有效得多。
这是吞吐与延迟优化,主要出现在自建推理集群,也就是通常说的 inference gateway 场景。
三、网关侧请求合并:用几毫秒换连接开销
网关自己把 N 个同质请求聚成一个后端调用,通常叫 micro-batching。
最实用的场景是 embedding 和 rerank。这两类接口天然接受数组输入,把 100 个单条 embedding 请求合成 1 次调用,TLS 往返、连接数、HTTP 头部开销全都摊薄了。
代价是给每条请求引入了一个等待窗口。所以窗口必须小到毫秒级,并且带条数上限,一般只对能容忍几毫秒抖动的内部调用开启。对话类的 completion 请求不能这么合,语义上没有合并的余地。
用网络转发的语言说,这一层跟 DPDK 的 rte_eth_rx_burst 是同一个思想:一次收 32 个包而不是一次一个,摊薄每包的固定开销(PCIe 事务、cache miss、函数调用),代价是最早那个包多等了几微秒。第二种批处理则更像网卡的 TSO/GSO,真正的合并发生在下游硬件里,上游的责任是不做多余拆包、别把大段切碎。第一种在数据面上没有对应物,它纯粹是控制面的成本调度。
四、怎么选
判断依据只有一条:这份流量的延迟预算是多少。
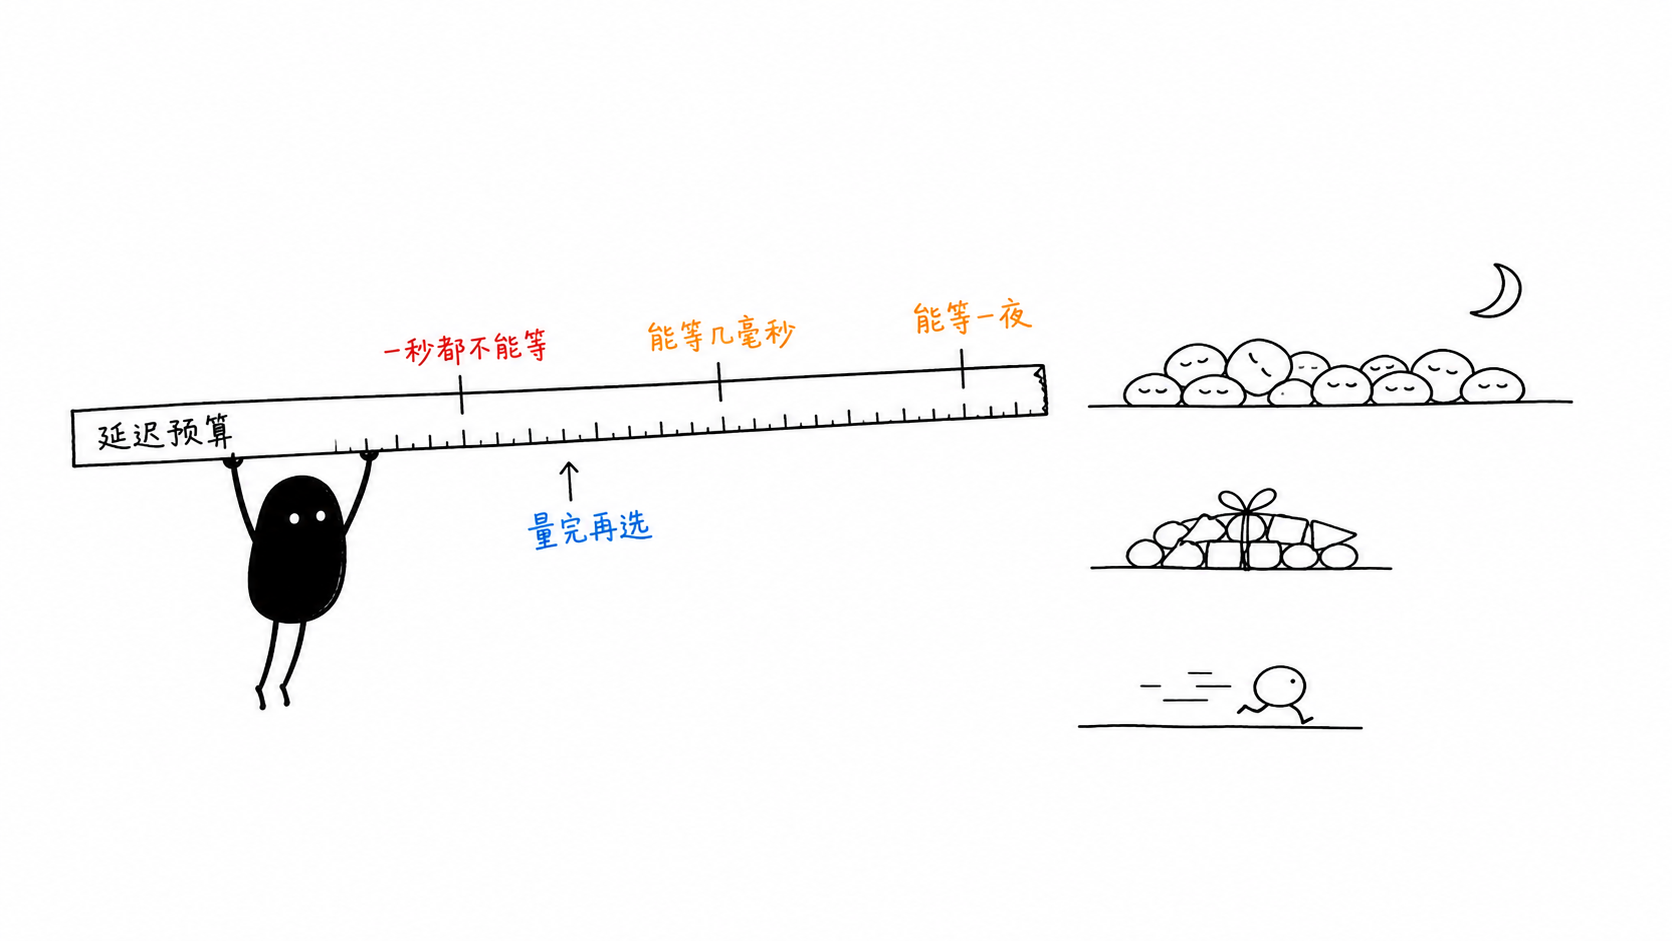
- 有 SLA 的在线对话流量。只碰第二和第三种,绝不进 Batch API。
- 离线跑批、可接受隔夜出结果。走 Batch API,省一半钱。这里最容易被忽略的收益不是折扣,而是不占同步配额,等于给在线流量腾出了额度。
- 自建 GPU 集群、要压吞吐。重点在第二种的路由策略。网关选型时直接看它是否支持 KV cache 感知的负载均衡,这是当前 inference gateway(Envoy AI Gateway、Gateway API Inference Extension 这一路)与传统 API 网关的主要分水岭。
- 内部批量 embedding / rerank。开第三种,窗口不超过 10ms,条数上限按后端单次最大输入算。
几个容易踩的坑:
- Batch 的 24 小时是承诺窗口而非保证,业务侧必须能接受更长的等待,且要设计好部分条目失败后的重投与幂等。
- 攒批逻辑放在网关会让网关变成有状态服务,这跟网关自身水平扩展的假设冲突。job 状态应该外置到存储,而不是留在实例内存里。
- micro-batching 的窗口会推高 P99。上线前要看的是尾延迟曲线,不是平均值。
- 队头阻塞的锅经常被误判成引擎性能问题,实际是网关没做长短分池。
五、趋势
推理网关与 API 网关继续分化。传统 API 网关的负载均衡对后端是无状态假设,而推理后端带着 KV cache 这份重状态,请求落到哪个实例直接决定要不要重算 prefill。这个差异无法通过加插件弥合,只能在数据面重写调度逻辑。KV cache 感知路由正在从「高级特性」变成「入门门槛」。
PD 分离让批处理策略裂成两套。prefill 和 decode 的计算特征完全相反,前者算力密集、后者带宽密集。把两个阶段拆到不同实例(DistServe、Mooncake 这一路思路,vLLM 新架构也在往这个方向走)之后,prefill 侧要按 token 总量攒批,decode 侧要按序列数攒批,网关面对的不再是一个池子而是两个,还要负责在两者之间传递 KV cache 的位置信息。批处理策略从一个参数变成一组耦合参数。
推测解码与批处理相互挤压。推测解码在小批量下收益明显,因为空闲算力多;批一大,算力本来就被填满,投机失败的重算反而成了净损失。所以未来的调度会是动态的:低负载时开推测解码压延迟,高负载时关掉它换吞吐。这个开关落在哪一层还没有定论,但网关掌握全局负载视图,是天然的候选。
Agent 流量把批的边界从请求推向 step。一次 Agent 任务是几十轮模型调用加工具调用,轮次之间有明确的依赖。计费、限流、批处理的单位如果还停在单次 HTTP 请求,就无法表达「这个任务总共花了多少」。批的语义正在从「一批请求」演化成「一个任务的一批 step」,网关需要有会话与任务的概念,这跟无状态转发的传统形态是有张力的。
成本调度会平台化。Batch API 现在还是业务方主动选择的接口,但它本质上是 LLM 世界的 spot 实例。可以预见网关会把它做成调度器的一个档位,业务只声明「这份流量可以延迟 6 小时」,由网关决定走同步、走 Batch、还是走某个更便宜的供方,并在超时前自动升级到同步通道兜底。
一句话
批处理在 AI 网关不是一个功能开关,而是在成本、吞吐、延迟这个三角里的调节手段。第一种换成本,第二种换吞吐,第三种换连接开销,三者都以牺牲一部分延迟为代价。搞清楚手里这份流量的延迟预算,选择自然就定了。