很多人第一次接触 AI 网关,会把它想成一个带模型下拉框的转发器。客户端发一份 OpenAI JSON,网关换个地址,把请求送到 Claude、Gemini 或 DeepSeek。这个理解能解释最简单的场景,却解释不了为什么现在的网关开始同时出现 /v1/chat/completions、/v1/responses 和 /v1/messages。
真正需要拆开的,是三层问题。谁负责接收请求,网关内部用什么对象表达请求,最后一家模型服务需要什么格式。把这三层混成一句“OpenAI 兼容”,后面一定会遇到工具调用、流式事件和多轮状态的坑。
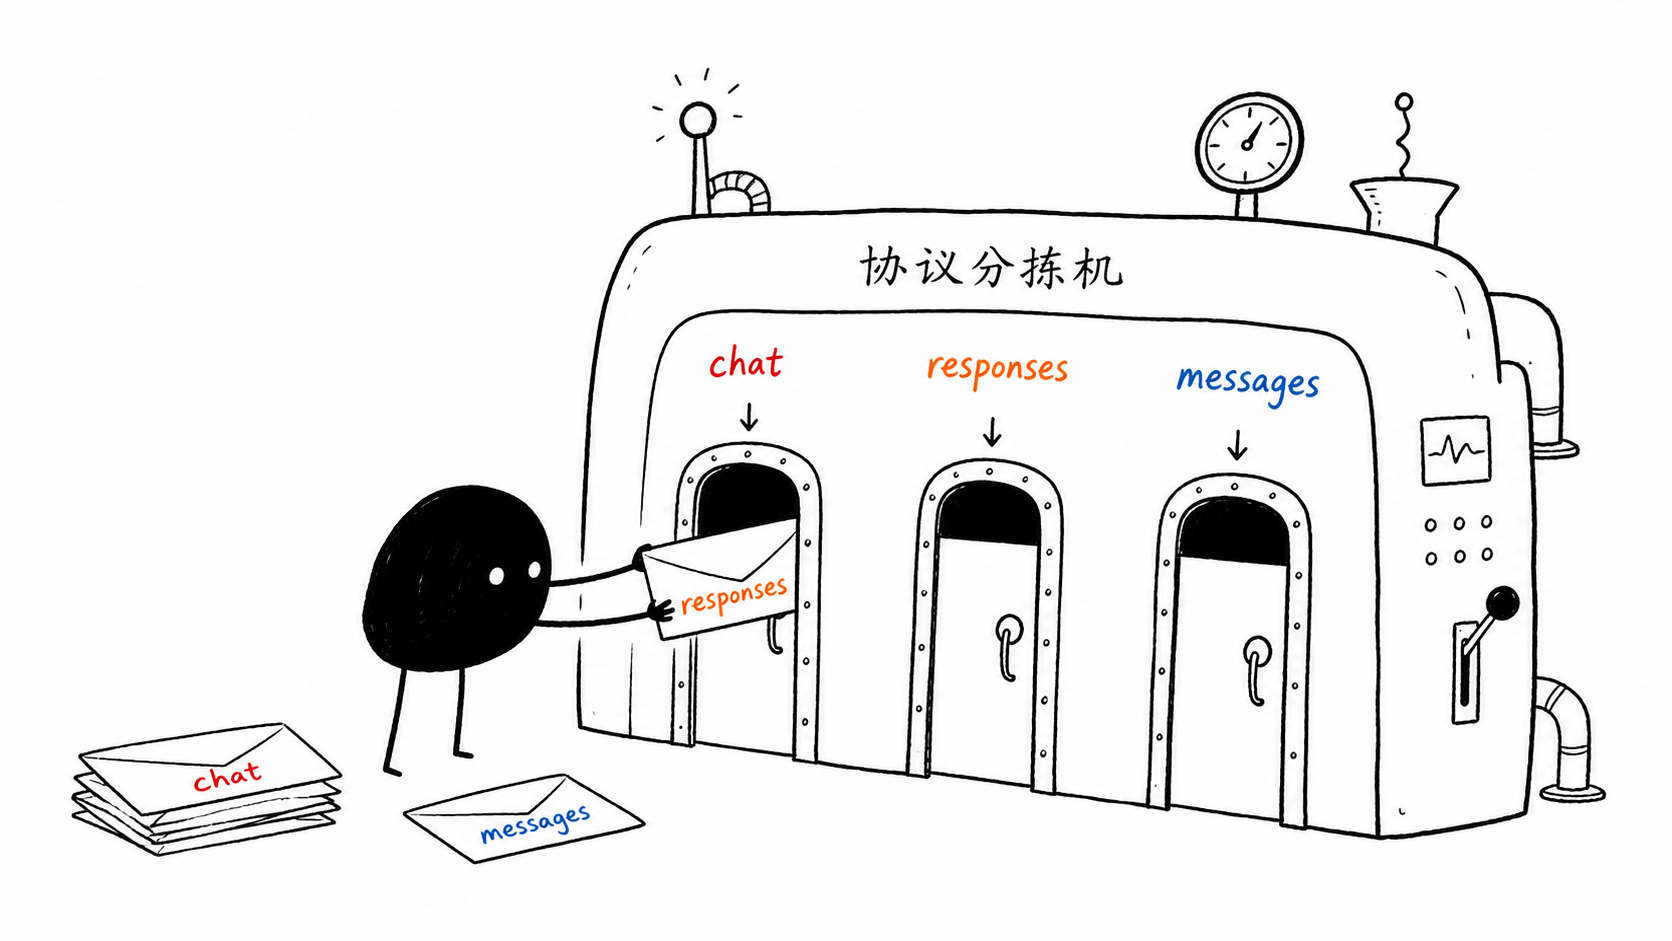
开源网关主要有三种入口路线
开源项目的差异在于客户端从哪条 API 进入。大致有三种路线。统一暴露 OpenAI 入口,按协议路径分流,或者两者并存。
- LiteLLM以 OpenAI 兼容的
/chat/completions和/responses作为统一入口,同时提供 Anthropic/v1/messages原生入口。前者把 Anthropic、Gemini 等供应商收敛成一套 SDK,后者给 Claude Code 保留原协议。它还能把/responses桥接到只支持 Chat Completions 的模型。 - 原始 One API选择单一 OpenAI 风格入口。请求被解析成通用对象,再按渠道适配 Anthropic、Gemini、OpenAI 和 Ollama。它没有把
/v1/messages和/v1/responses做成同等级的入口。 - New API采用多协议入口并存。项目说明同时支持 OpenAI Compatible、Responses、Claude Messages 和 Gemini 格式,并提供跨协议转换。
- Portkey的默认思路是 Universal API,把请求收敛到 OpenAI 格式,同时也支持
/messages和/responses。 - Higress采用按路径识别入口。
/v1/chat/completions对应 OpenAI,/v1/messages对应 Claude,再根据后端能力决定透传或转换。客户端使用标准 SDK 和标准路径,不需要增加自定义协议字段。 - Kong AI Gateway偏配置驱动。AI Proxy默认接收 OpenAI-compatible 格式,管理员在路由里指定 provider。需要 Anthropic 专属能力时,再把
llm_format设为 native,使用/v1/messages。 - Envoy AI Gateway以 OpenAI-compatible API 为主要前门,同时提供 Anthropic-compatible API,再由 Kubernetes 路由资源选择后端。
- AI Proxy走更彻底的多协议路线。它暴露 OpenAI Chat、Claude Messages、Gemini 和 Responses 入口,并允许 Chat、Claude、Gemini 请求访问只支持 Responses 的模型,转换全部留在网关内部。
因此,“一个入口还是分协议入口”没有统一答案。单一 OpenAI 入口成本最低,适合固定应用。多协议入口更容易保留各家 API 的工具、状态、流式和多模态能力,适合开发者平台。常见折中是统一域名、分协议路径,再把鉴权、路由、配额、审计和观测放进同一层。
网关和 Agent 怎样配合
Codex、Claude Code 和 Comate 都能调用模型网关,配置权却不在同一个地方。宿主管理型 Agent 由承载它的平台或企业管理员决定 provider、网关和认证,用户未必能编辑 base_url。Comate 更接近这种形态,Codex CLI 和 Claude Code 更接近自行配置模型出口的客户端。
comate这类 Agent 通常合并三层配置。软件内置协议解析器、工具循环和 MCP Client,新协议能力往往随升级获得。远程平台下发模型列表、网关、权限和配额。本地项目保存 Rules、Skills、MCP Server 和工具权限。平台既可以让客户端直连企业网关,也可以转发模型请求。前者少一跳,后者便于集中认证和审计。企业策略还能禁止个人覆盖 endpoint。
Codex 走 Responses
Codex 的自定义 provider 可以使用类似下面的配置。
1 | |
wire_api = "responses" 是关键。网关需要提供 /v1/responses,或完成 Responses 到 Chat Completions 的双向转换,并保留 reasoning、function call、call_id 和流式事件。model 也要与网关的模型映射一致。
Claude Code 走 Anthropic Messages
Claude Code 通常通过环境变量指定网关和模型。
1 | |
它走 Anthropic Messages API,常见路径是 /v1/messages。网关要保留顶层 system、content blocks、tool_use、tool_result、thinking 和流式事件。认证可按入口改用 ANTHROPIC_API_KEY。非官方域名下的 MCP tool search 还要按当前版本单独确认。
Comate 由宿主决定具体入口
Comate 用户通常操作 Agent、Ask、Plan、Goal、模型选择、Skills、Rules、Subagents 和 MCP,provider、企业网关、认证及模型路由可能由宿主控制。一个模型名称背后可以对应 OpenAI-compatible、Responses 或 Messages 入口。公开文档没有证明所有版本都开放自定义 endpoint,因此不能假定 Comate 固定使用某一种协议。企业接入要按当前版本确认管理员配置范围。
模型 API 和 MCP 是两条配置线
Agent 使用网关时,模型调用和工具调用要分别看。
1 | |
模型 API 负责消息、推理、工具事件、流式返回和状态。MCP 负责工具发现、schema、权限和执行。两者可以共用企业域名,却不能共用一份协议配置。网关要分别记录模型入口、模型映射、工具权限和调用审计。
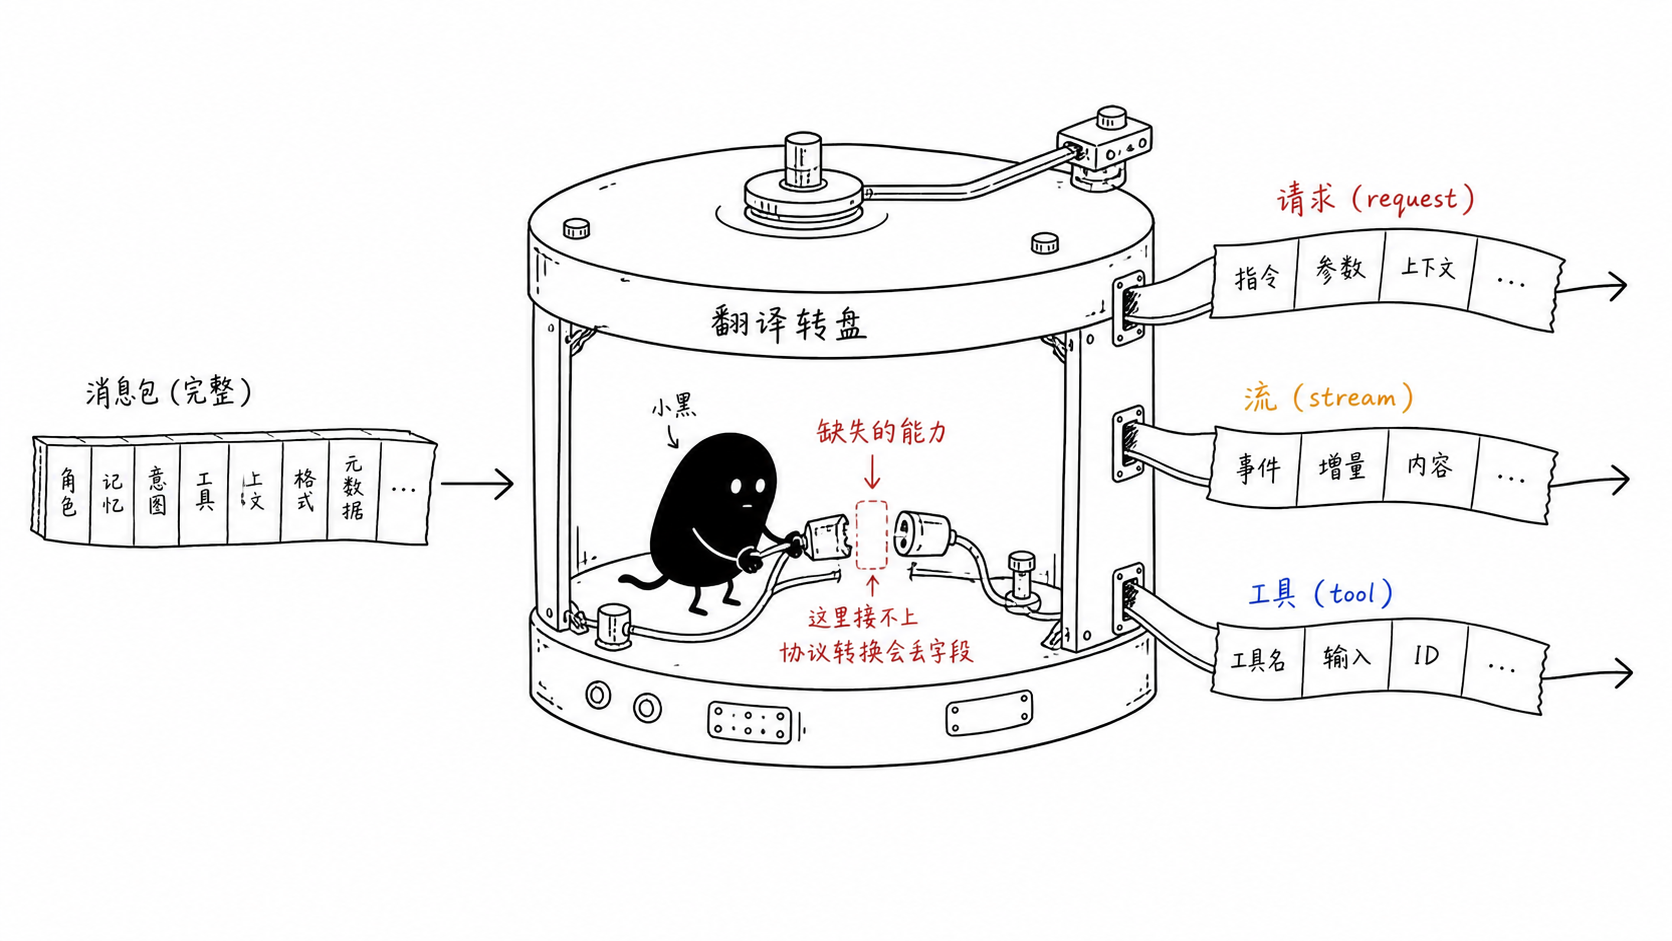
参数差异先看形状,再看能力
几套 API 的字段差异可以分成两类。第一类是同一个动作换了数据结构,网关可以稳定转换。第二类是目标服务根本没有这个能力,网关只能降级、拒绝,或者把责任交回调用方。
Chat Completions
请求的核心是 messages 数组。每条消息有 role 和 content,工具通过 tools、tool_choice 表达,生成结果放在 choices,文本通常位于 choices[].message.content。流式响应把增量文本放在 choices[].delta,调用方需要自己把碎片拼成完整消息。
它的优势是入口简单、生态最大。接口本身不保存多轮状态,工具循环需要应用自己保存 assistant 的工具调用,再把工具结果作为下一轮消息传回。response_format、n、logprobs 等参数也不能假定所有上游都支持。
Responses
Responses把请求核心换成 input,返回值换成有类型的 output items。一个输出可以是普通 message,也可以是 reasoning、function call 或其他 item,所以不能把 output[0] 永远当成文本。结构化输出从 Chat Completions 的 response_format 移到 text.format,函数结果要用对应的 call_id 关联。
Responses可以用 previous_response_id 或 Conversations API 保存状态,也可以在一次请求中使用 web search、file search、code interpreter、image generation 和远程 MCP 等内置工具。流式返回从 delta 变成 typed server-sent events,例如 response.output_text.delta 和 response.function_call_arguments.delta。网关若只把字段名改成 input,却没有处理这些 item、状态和事件,得到的只是外形兼容。
Anthropic Messages
Anthropic把 system 放在顶层,把 messages[].content 设计成 content blocks。文本、图片、工具调用和工具结果各自有 block type,模型发出的工具调用是 tool_use,调用方返回的是 tool_result。这和 Chat Completions 把工具调用放在 assistant message 的字段里,结构位置不同。
Messages API是无状态的,每一轮仍由调用方携带历史。max_tokens 是核心参数,思考能力使用 thinking。流式响应按 message 和 content block 事件组织,工具参数和思考内容也会以不同的 delta 类型出现,网关必须维护 block 顺序和工具 JSON 累积。
Gemini
Gemini的请求以 contents 和 parts 为中心。文本、图片或音频可以成为不同的 Part,系统指令放在 systemInstruction,生成参数放在 generationConfig。工具定义使用 function declarations,模型返回 functionCall,调用方再返回 functionResponse。这套结构和 OpenAI 的 message content、Anthropic 的 content block 都有对应关系,但没有一一同名的字段。
Gemini的能力差异尤其容易被低估。多模态媒体可以是 inlineData 或 URI,不能只改名为 image_url。思考模型还可能返回 thoughtSignature,后续工具轮次需要原样带回,流式 generateContent 的函数参数也可能分段到达。网关若丢掉签名,第二轮工具调用可能失败。
兼容实现为什么会出现“200 但行为不对”
DeepSeek的 Responses 文档是一个很好的例子。它支持基础输入、函数和 Web Search,却不支持 previous_response_id、conversation、store、后台任务、file search、code interpreter、computer use 和 MCP 等能力。部分不支持参数会被静默忽略,响应仍然返回成功。
这说明兼容性至少要有三张表。第一张是字段映射表,例如 messages 对 input、response_format 对 text.format。第二张是事件映射表,例如 choices[].delta 对 Responses 的 typed events、Anthropic 的 content block events 和 Gemini 的 Part chunks。第三张是能力矩阵,记录每个模型是否支持状态、工具、结构化输出、多模态、思考上下文、缓存和后台执行。只有第一张表的网关,最容易出现请求成功、业务结果却不符合预期的情况。
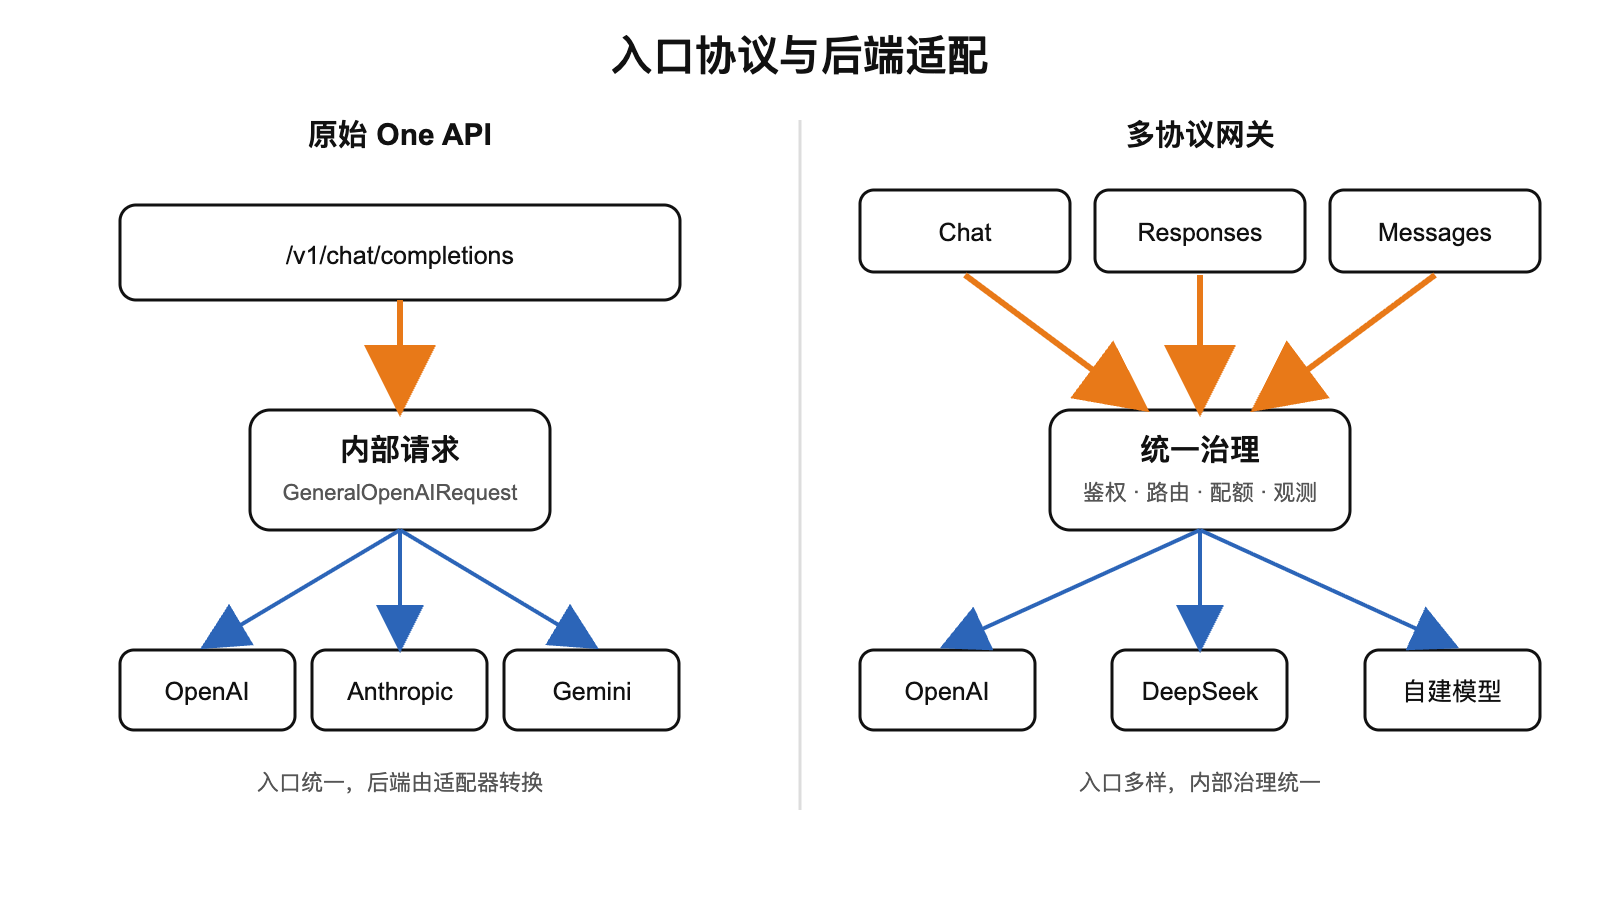
我的判断是先统一治理,再保留协议差异
如果业务只有普通文本和少量函数调用,OpenAI 单入口仍然是性价比最高的方案。它降低了客户端接入成本,网关也容易做路由、额度、日志和故障切换。对内只做一套规范化请求,也能减少测试和排障工作。
如果网关要承接不同 Agent 客户端,就应该提供多协议路径,并在内部建立统一的治理层。统一的应当是鉴权、路由、配额、审计和观测,不应当强迫所有协议共享一套贫血的响应模型。能透传就透传,必须转换时再转换,无法映射的能力要明确报错或降级。选择单入口还是多入口,取决于网关服务的是一批固定应用,还是一个需要兼容多种客户端的开发者平台。
我把各项目官方文档和 One API 源码对了一遍,证据能支持这个入口设计判断。对使用者来说,最有用的检查也很具体。不要只问网关是否 OpenAI-compatible,要继续问它支持哪个端点、哪些流式事件、哪些工具、是否保留多轮状态,以及不支持的参数会报错还是被忽略。接入前可以先做四个小测试,普通文本、结构化输出、一次工具调用和一次流式中断恢复。四项都通过,才有理由把“兼容”写进生产方案。
参考来源
- OpenAI Responses API 迁移指南
- DeepSeek Responses API 兼容性说明
- One API 中继路由源码
- One API 适配器注册源码
- AI Proxy 多协议与转换说明
- LiteLLM 参数转换文档
- LiteLLM 支持的端点
- New API 项目说明
- Portkey Universal API
- Higress AI Proxy 协议适配
- Kong Anthropic provider
- Envoy AI Gateway 支持的 API 端点
- Codex 基础配置
- Codex 自定义模型 provider
- Claude Code LLM Gateway 配置
- Comate Agent 模式与扩展能力