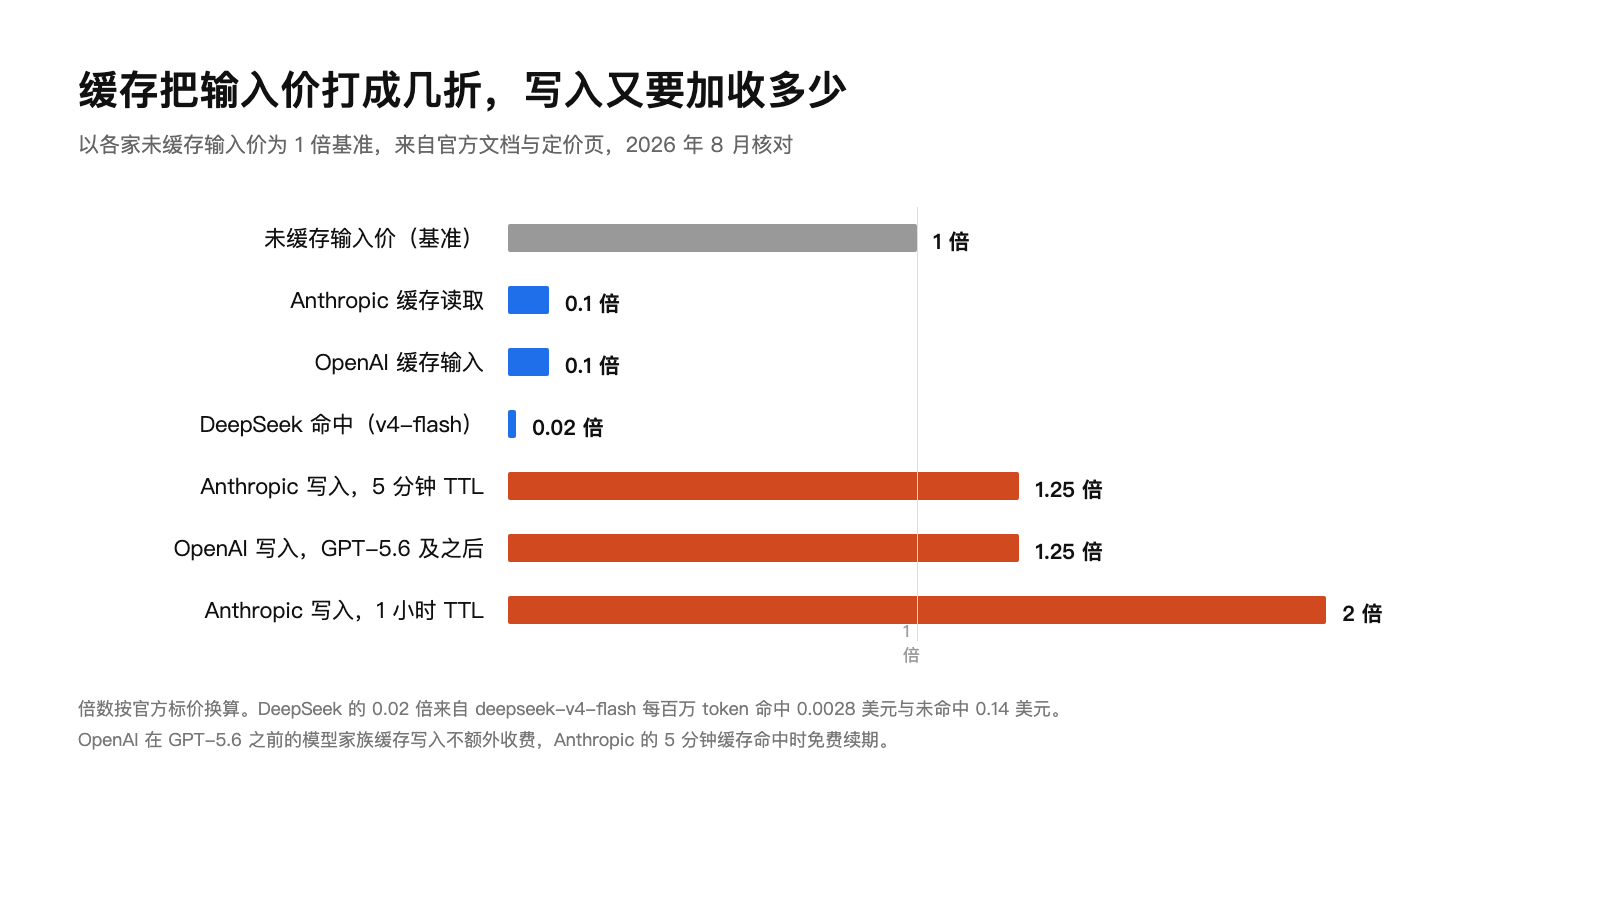
DeepSeek 的定价页上有一组很扎眼的数字。deepseek-v4-flash 的输入价,缓存未命中每百万 token 0.14 美元,命中 0.0028 美元,差 50 倍。它的硬盘缓存文档还写明这个功能对所有用户默认开启,不用改一行代码。
我把四家 API 的计价页和三层开源组件的文档对了一遍,想搞清楚这 50 倍能落到账单上多少。结论是,能落到多少几乎与缓存实现无关,取决于你的提示词长什么样。
三层缓存缓存的根本不是同一样东西
先把最底下那样东西说清楚。模型每蹦出一个字,都要回头看前面所有的字,回头看之前还得先把每个字加工成两样中间产物,一个 Key 一个 Value。把它当成一份读到一半的笔记就行,Key 是检索标签,Value 是内容摘要。前面那些字的笔记算完就不再变,留着别扔,下一个字就不用把全文重读一遍。这份笔记叫 KV cache,是必需品,谈不上优化。
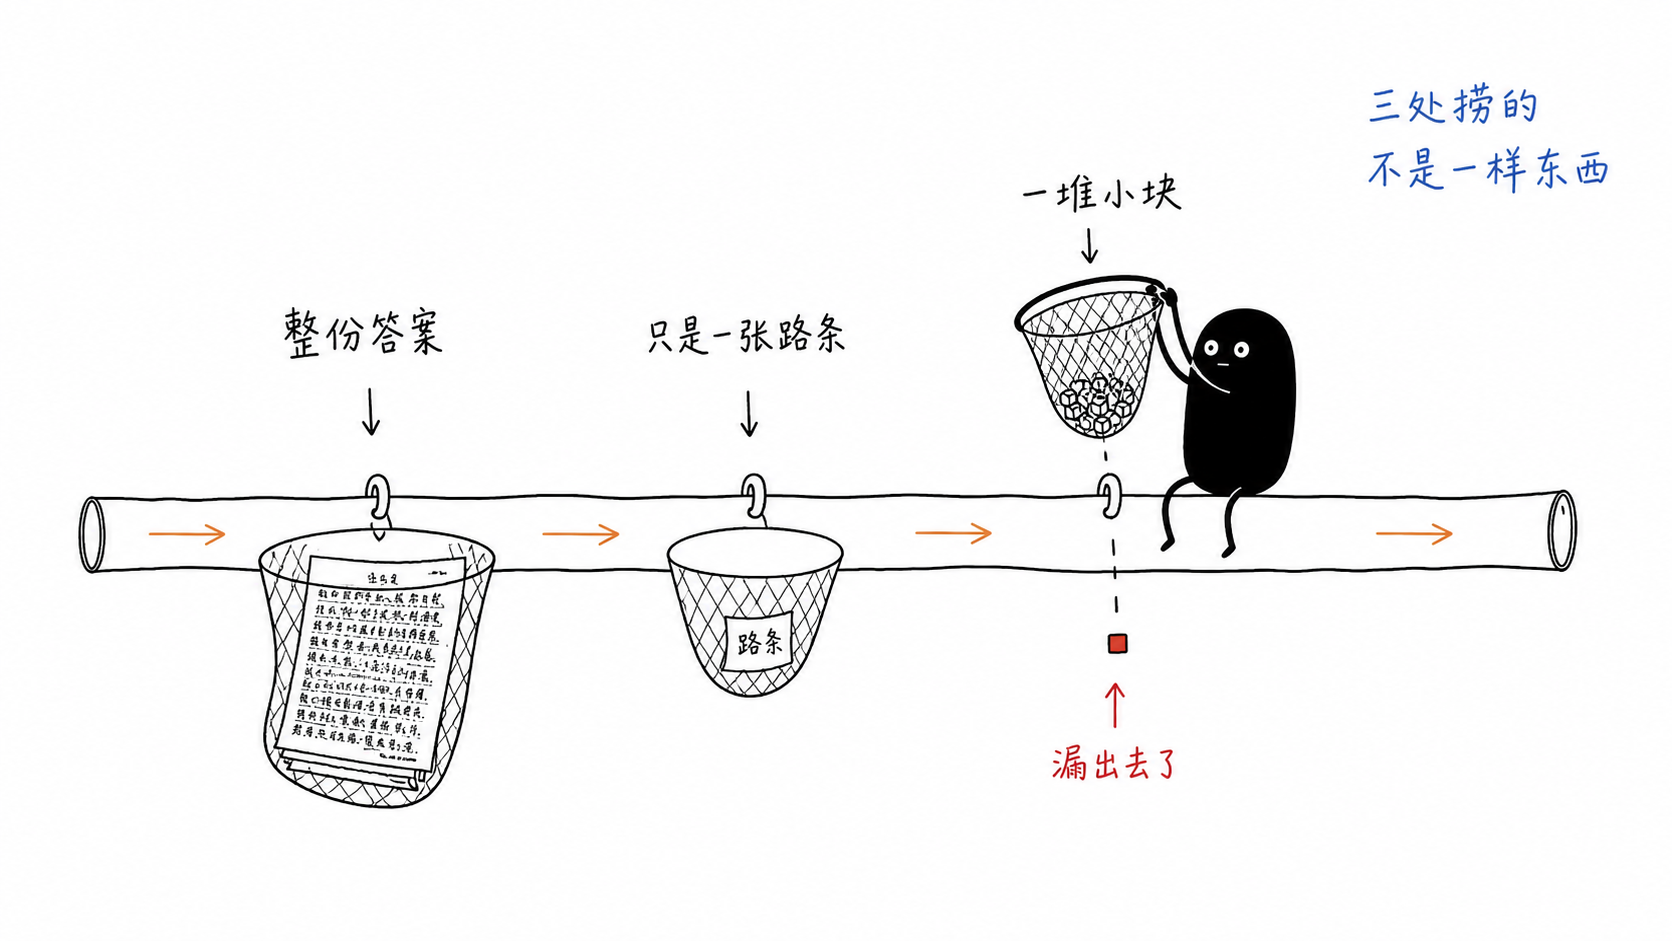
请求从网关进来,经过路由,落到引擎。这条路上三个地方都在存东西,存的却不是同一样。
AI 网关存完整答案。命中条件是请求指纹一致,或者向量相似度超过阈值。命中一次省掉整次推理,模型根本不被调用。
推理网关存一张账本,记着哪段开头上次去了哪台机器。它自己什么都不省,作用是让引擎那层更容易命中。
引擎存的就是那份 KV 笔记。命中条件是新请求的开头和旧请求完全一样,省下来的是这段开头的重算。
从上往下省得越来越多,风险也越来越大。把三者统称”缓存”来讨论降本,多半会算错。
引擎层的省,只省在 prefill
vLLM 的前缀缓存设计文档讲得很直接。它按 KV block 做哈希,哈希输入包含这个 block 里的 token,以及它前面的全部前缀 token。所以前缀中间改一个字,后面所有 block 的哈希全变。V1 把淘汰做成了常数时间操作,V1 alpha 的发布说明给了一个我认为最有说服力的数字,命中率为 0 时吞吐下降小于 1%,因此 V1 默认开启前缀缓存。开销低到可以白送。
它的边界也写在官方功能文档里。前缀缓存只缩短 prefill,不缩短 decode。换成人话,借来的笔记只帮你跳过”读题”,”答题”还得自己一个字一个字写。
MLSys 2024 的 Prompt Cache 把这件事量化过。Llama 7B 跑在 RTX 4090 上,3K 上下文,TTFT 从 900 毫秒降到 90 毫秒,而后续每个 token 的时间没变,仍然是 32 毫秒左右。一个输出 500 token 的请求,省下的 810 毫秒摊到十几秒的总时长里,比例立刻小得多。作者自己也写明了这一点,输出越长,端到端收益越小。
笔记放哪儿也影响结果。2025 年一份第三方测量在 100% 命中率下比较过,磁盘卸载的前缀缓存在短前缀时比显存常驻慢 2 倍,129K token 时慢 6.5 倍。同一份测量也给出了这生意为什么还划算,从 8K token 起,读磁盘比从头重算快 5 到 7 倍。显存、内存、磁盘、重算,这是一道越往后越慢但每一档都强过下一档的阶梯。
推理网关那层缓存的是猜测
Kubernetes 的 Gateway API Inference Extension 走了一条我没想到的路。它的 EPP 不去问模型服务器”你缓存了什么”。设计提案明确否掉了让模型服务器上报 KV 索引这个方案,理由是要改模型服务器接口。
它改成在网关本地维护一份近似账本。把输入切成固定大小的块,串成包含模型名的滚动哈希链,为每个 pod 维护一份 LRU,用它模仿服务端的淘汰行为。请求进来时按预计能命中多少块给端点打分。这个 `prefix-cache-scorer` 在 v1.5.0 的默认配置里是开着的。
账本毕竟只是猜测,官方文档把代价写清了。账本比显存实际缓存小,会出现假的未命中;比它大,会出现假的命中。
这个项目没有公布任何 TTFT 改善数字,只提供了跑基准的配置。想知道自己集群能省多少,得自己跑。
语义缓存是唯一会答错的一层
Kong 的 ai-semantic-cache 文档里有一句话,准备上线语义缓存的人最好先读一遍。即使启用了精确缓存,插件仍然可能对相似但不相同的查询返回缓存结果,官方称这是预期行为。
Apache APISIX 的 `ai-cache` 把两层分开了。L1 用有效 prompt 的 SHA-256 指纹做 Redis key,始终启用;L2 语义层只在 L1 未命中时查询,默认关闭,需要 Redis Stack 的 RediSearch。默认相似度阈值 0.95,top_k 为 1,只对最相似的那一条做阈值判断。这份文档目前只在 master 分支,3.17.0 和 3.16.0 的标签里都没有,官网页面 404,算未随版本发布的特性。
语义缓存的诱惑在于命中时省掉 100% 的推理成本,代价是可能给出一个针对别人问题的答案。”我的订单能退款吗”和”我的订单能改地址吗”在向量空间里挨得很近,答案却完全不同。阈值就是这么一个旋钮,从 0.95 调到 0.90,命中率上去了,返回错答案的概率也上去了。这层缓存适合客服常见问题这类答案本来就趋同的场景,放在需要精确回答的路径上,省下的钱不够赔。
商业 API 的账单口径全都藏在写入费和门槛里
OpenAI 的 prompt caching 文档和定价页配起来看,缓存输入按未缓存输入价的 10% 计费。但 GPT-5.6 及之后的模型家族,缓存写入按未缓存输入的 1.25 倍计费,此前的家族写入不额外收费。可缓存的前缀至少要 1024 token,不足这个数的请求 `cached_tokens` 直接是 0。
Anthropic 的价格表把这套账算得更露骨。缓存读取 0.1 倍基础输入价,5 分钟 TTL 的写入 1.25 倍,1 小时 TTL 的写入 2 倍。缓存范围是 tools、system、messages 构成的前缀,直到你标记 `cache_control` 的那个块。
Gemini 把隐式缓存对 2.5 及更新模型默认开启,不用配置,但有最小输入门槛,2.5 系列是 2048 token。
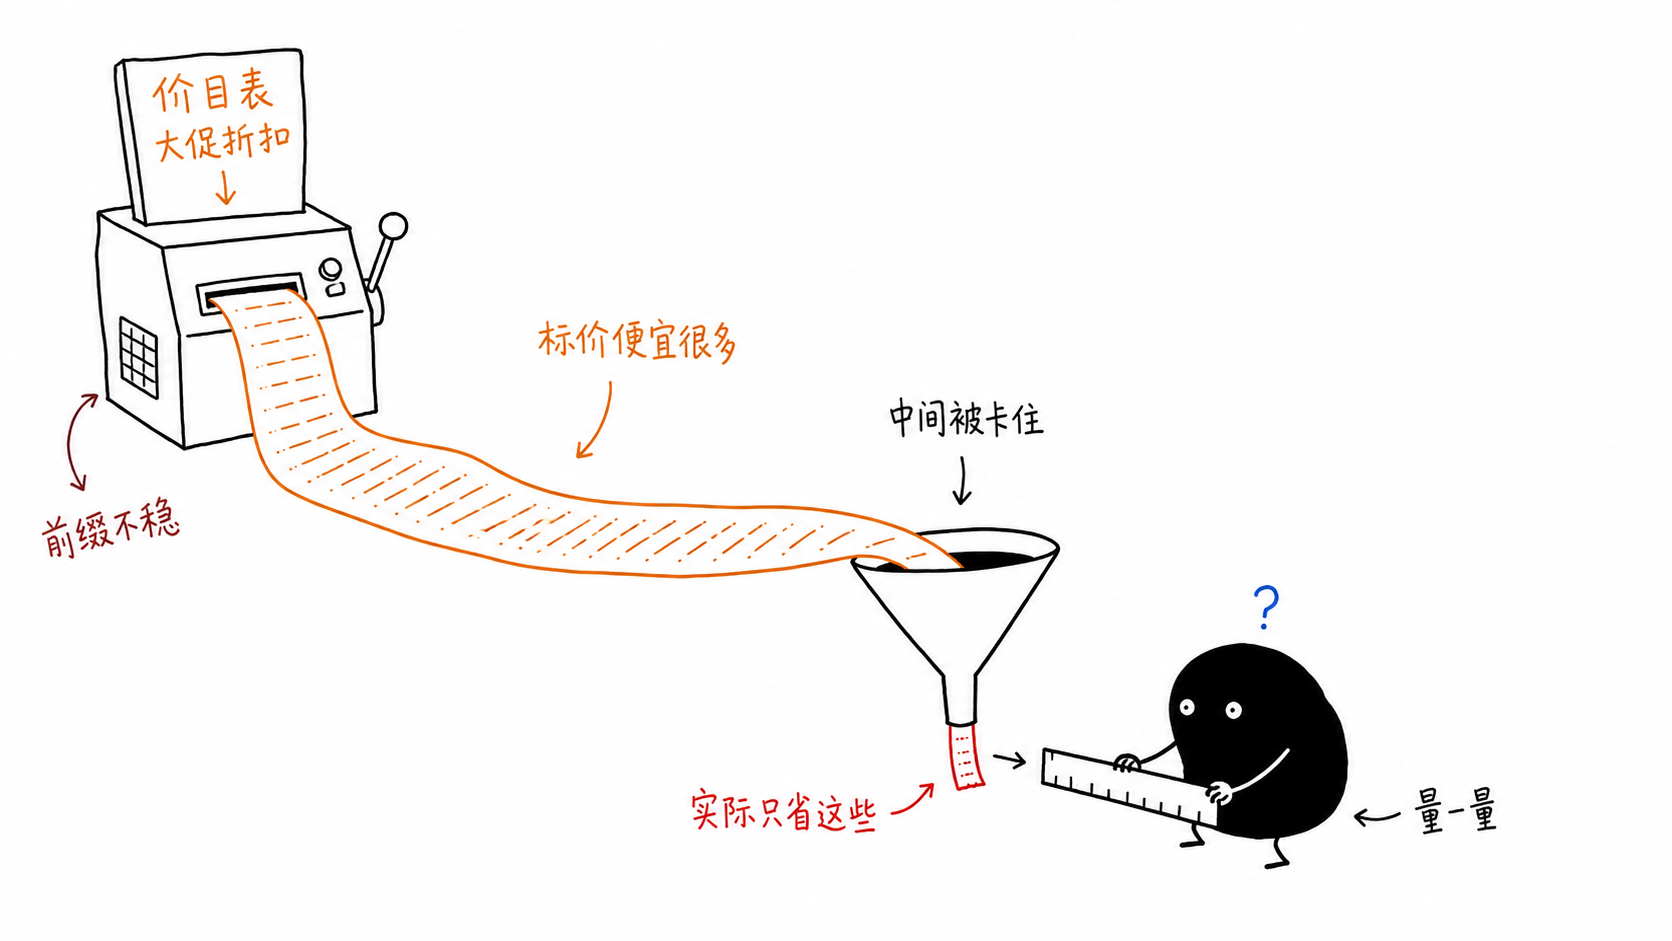
写入要钱、有长度门槛、还带 TTL,这三条凑在一起意味着一个高频改动前缀的短请求负载,缓存写入费可能吃掉全部节省。DeepSeek 那 50 倍是命中时的单价比,不是账单降幅。
命中率是提示词结构的函数
ProjectDiscovery 在 2026 年发过一篇自家智能体的降本复盘,命中率从 7% 提到 84%,按真实账单反推的有效单价对比全额输入价,整体成本降 59%,最近十天 70%,累计 98 亿 token 由缓存提供。他们特意说明这是从实际支出反推的,不是按价目表估的。
更有用的是那张按步数拆的表。单步会话平均命中 35.5%,11 到 20 步 63.9%,20 步以上 74.0%。命中率随会话变深而升高。
同一篇里还有一个反例。一个输入 6680 万 token 的任务,命中率只有 3.2%。原因是会变的工作记忆放在了前缀中段,它一改,后面所有前缀全部作废。这跟 vLLM 哈希包含前置 token 是同一个道理,只是发生在商业 API 上,账单上看不出来是哪一段坏了事。
基准数字和生产数字之间那道差
SGLang 的论文标题数字是吞吐最高 6.4 倍,测试硬件多是 A10G 24GB,基线是没开前缀缓存的 vLLM 0.2.5,论文脚注承认刻意用了较早版本比较。同一篇论文里还有一组生产数据,部署在 Chatbot Arena 一个月后,LLaVA-Next-34B 的前缀缓存命中率 52.4%,Vicuna-33B 74.1%,而 Vicuna-33B 的首 token 延迟平均改善 1.7 倍。
74% 的命中率换来 1.7 倍。这两个数字在同一篇论文里,中间差着一个数量级。
Preble 的论文把话说得更白。它报告平均延迟改善 1.5 到 14.5 倍,同时写明在没有共享前缀的负载上其性能等同 vLLM,在 decode 占主导的程序生成负载上只有 1.56 到 1.8 倍。EuroSys 25 的 CacheBlend 干脆是为了绕开前缀限制才存在的,因为 RAG 检索回来的文档块出现在中段,从来不构成共享前缀。
规模最大的一手证据来自 Mooncake。FAST 25 正式版报告,在满足 SLO 的前提下有效请求容量提升 59% 到 498%,生产部署里让 Kimi 在 A800 和 H800 集群上分别多处理 115% 和 107% 的请求。这是把 KV 缓存做成跨节点池化以后的结果,工程量远超打开一个开关。
我的判断,以及它到哪里为止
缓存在推理路径上是少数不需要论证就该开的东西,vLLM 那个”命中率为 0 时吞吐下降小于 1%”已经说明引擎层前缀缓存的下限风险接近零。真正需要论证的是往上走多远。分层卸载、跨实例池化、网关近似账本,每一步都在加运维复杂度,收益却被提示词结构锁死。
最该先做的一件事跟缓存组件无关。把系统提示、工具定义和长文档挪到前缀最前面,把每步都在变的状态挪到最后。前面那个 3.2% 的例子说明,中段一段动态内容就能把命中率打到接近零,而这在监控里看不见。做完这一步再决定要不要引入 LMCache 这类分层方案。
这些结论全部来自公开文档、论文和厂商计价页,我没在本机跑过任何一组对比。语义缓存的错误命中率也没找到公开测量,只有 Kong 文档那句定性警告。谁手上有生产环境的语义缓存错误率数据,那比本文引用的所有数字都更值得看。
主要来源