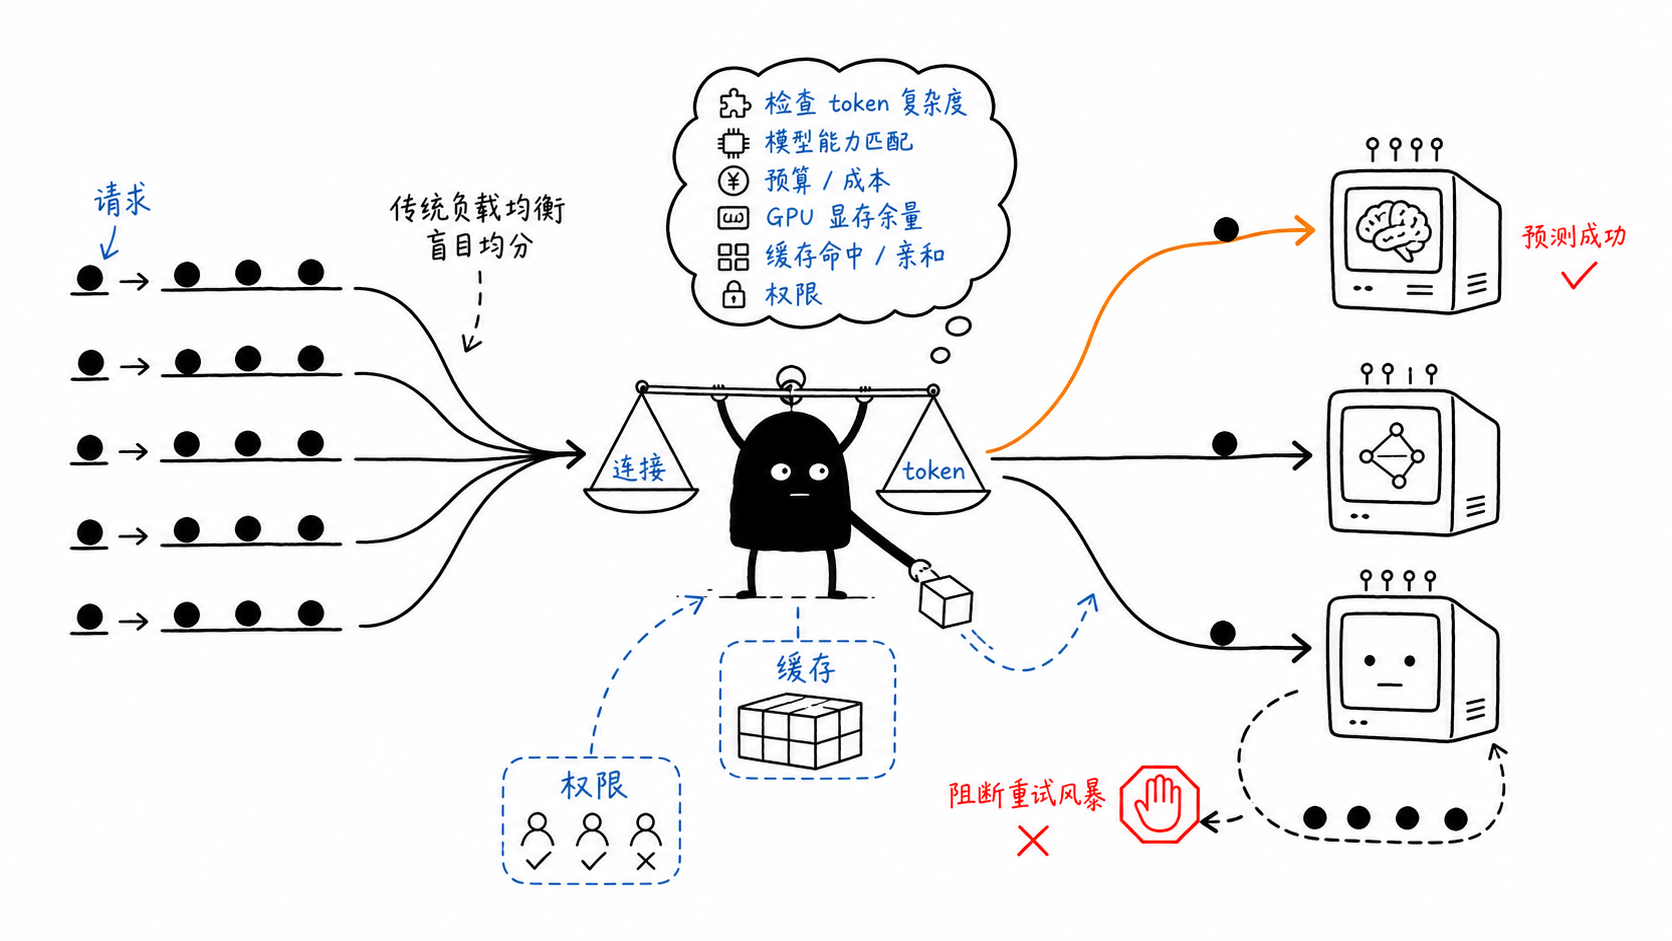
传统负载均衡器经常把请求当成大小接近的小球。Round Robin 依次投放,Weighted Round Robin 按静态容量分配,Least Connections 选择活跃连接最少的实例,Power of Two Choices 随机抽两台再选较轻的一台。后端成本相近时,这些算法简单、快速、够用。
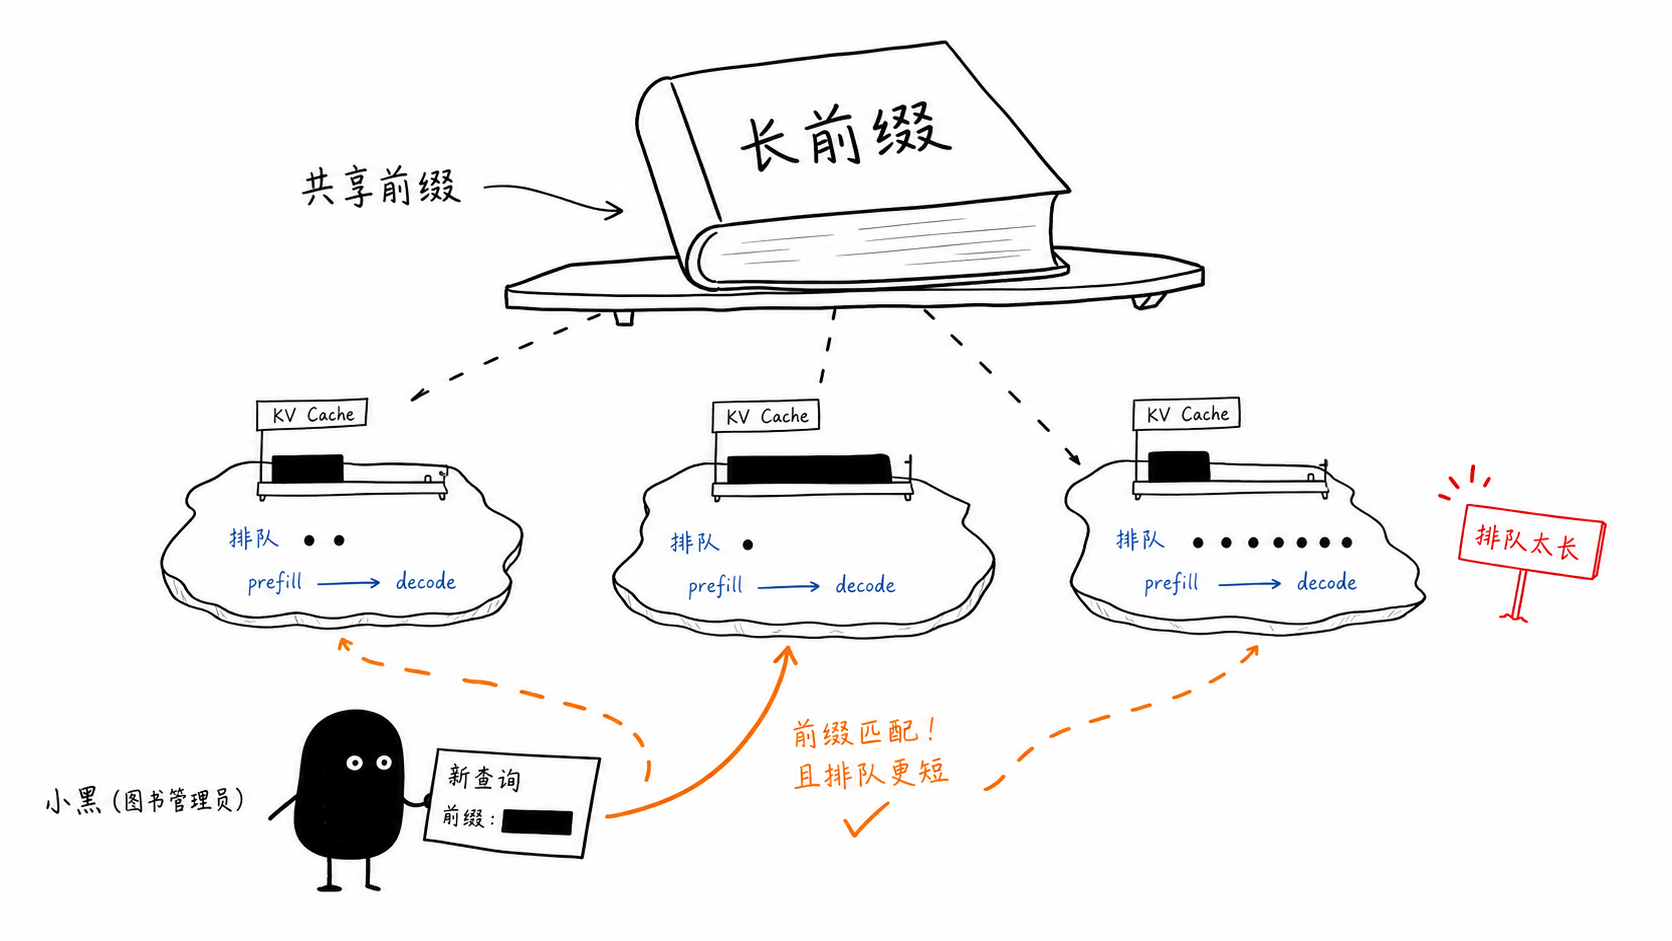
LLM 请求把这个前提打破了。同样是一条 HTTP 请求,短问答可能很快结束,长上下文加长输出却会持续占用 GPU 和 KV Cache。两条请求还可能共享几千个 token 的前缀。把它们平均分散,会让每台 GPU 重复计算同一段 prefill。
我重新对照了 KubeAI、Google CHWBL、Ray、vLLM 和 llm-d 的材料。算法的变化可以说得更具体。调度器先从“数请求”走到“数 token”,随后又要判断“哪台机器已经算过这段输入”。
传统算法的负载变量太粗
L4 调度常用五元组哈希、连接数和静态权重。L7 可以再看活跃请求、延迟、错误率、熔断状态和重试预算。Envoy 的 Least Request 会偏向活跃请求较少的主机,P2C 则用很低的选择开销近似全局最小负载。
这些算法默认一个连接或请求能代表一份相对稳定的工作。LLM 推理里,请求数相同不等于剩余工作相同。一台实例可能有四个即将结束的短请求,另一台只有一个正在处理十万 token 上下文的请求。Least Request 会把新请求送给后一台。
改进的第一步是 Least Outstanding Tokens。调度器估算每台实例尚未处理的输入与输出 token,选择剩余 token 最少的实例。相关排队模型研究把 Random、Join Lowest Request 和 Least Outstanding Tokens 明确区分开。它仍然不利用缓存,但负载度量已经从“有几个请求”变成“还有多少计算”。
一致性哈希保住缓存,也会制造热点
Automatic Prefix Caching 会复用共享前缀对应的 KV Cache。多轮对话每次都带着此前聊天记录,固定 system prompt 和长文档问答也有大量重复前缀。普通 Consistent Hash 可以对前缀做哈希,让相似请求稳定落到同一实例,提高缓存命中。
问题也很直接。哈希环保证节点变化时少搬请求,却不保证每个节点负载完全均匀。热门前缀可能持续命中同一实例。它的队列越来越长,缓存亲和反而变成热点亲和。
CHWBL 给一致性哈希加一条负载上界
Consistent Hashing with Bounded Loads 把服务器看作哈希环上的桶,把请求看作球。若集群有 n 个在途请求和 k 个副本,平均负载为 n 除以 k。算法给每个副本设置约为平均负载乘以一加 ε 的容量上界。请求沿哈希环找到目标副本;目标已满时,继续顺时针寻找第一个未满副本。
ε 控制两种目标的取舍。ε 较小,实例负载更整齐,更多请求会离开原哈希目标,缓存亲和下降。ε 较大,请求更容易留在原目标,缓存更稳定,热点空间也更大。
KubeAI 把它实现成 `PrefixHash`。代理先解析 OpenAI 格式请求,提取前缀和 LoRA adapter 名称,再对两者组合使用 xxHash,最后由 CHWBL 选择 vLLM 副本。当前文档把上界描述为目标副本的在途请求不能超过集群平均值的可配置比例。示例中的 `meanLoadFactor` 为 125,表示容许目标负载达到平均值的 125%。
举个简化例子。四个副本共有 20 个在途请求,平均值是 5。上界设为 125% 时,每台大约允许 6 个。一个新请求的前缀本应命中 A,A 已有 6 个请求,算法就沿环检查 B、C,直到找到未到上界的副本。它牺牲这一次缓存命中,换来对热点队列的硬约束。
KubeAI 的实验比较了 Kubernetes Service 的随机分配、LeastLoad 和 PrefixHash。其特定 Kubernetes 模拟负载中,PrefixHash 相对基线报告了 TTFT 降低 95%、吞吐提高 127%。这组数字说明缓存亲和可能很有价值,不能外推到所有模型。实验作者也明确计划扩展工作负载覆盖。
四类算法在同一批请求上的选择不同
假设 A 已缓存公共 system prompt,队列里有 6 个短请求。B 没有缓存,只有 2 个长请求。C 没有缓存,也没有排队。新请求携带相同 system prompt。
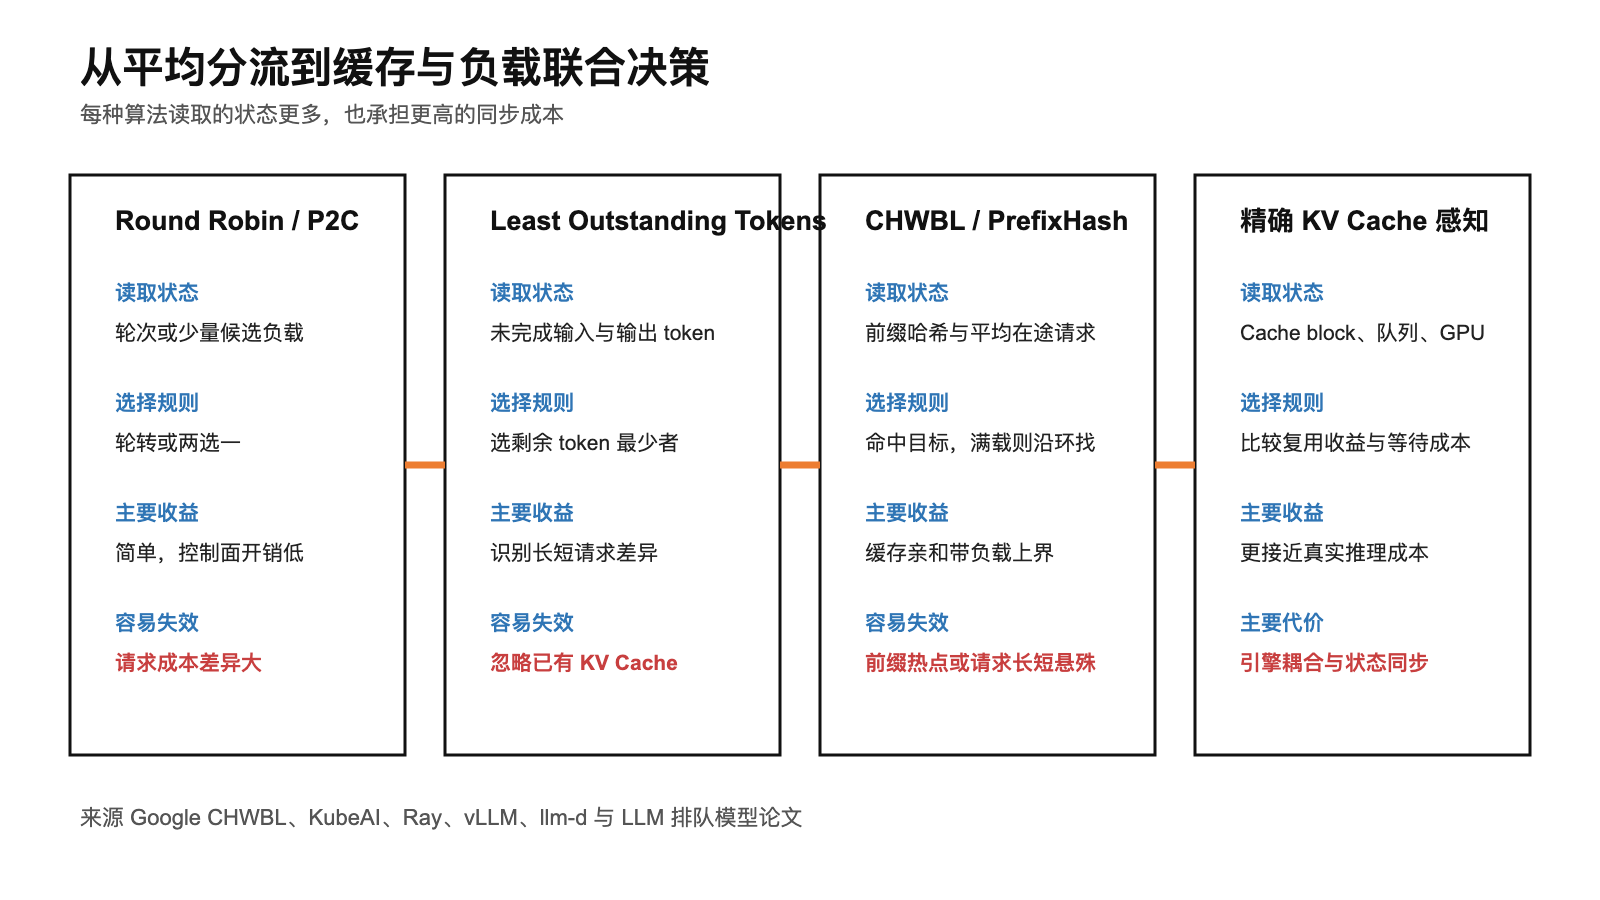
Round Robin 不读取这些状态,轮到谁就选谁。它的优势是控制面几乎没有同步成本,扩容以后也能立刻分流;代价是缓存被均匀打散。
LeastLoad 若只数在途请求,会在 B 和 C 之间选 C。若 C 随后接到一批超长输入,旧的计数很快失真。Least Outstanding Tokens 会把每台机器未完成的 token 相加,更可能避开长请求堆积的实例,但它仍会让 C 重新计算公共前缀。
普通前缀哈希会坚定选择 A。只要前缀稳定,A 的 APC 命中率就高;突发流量连续带着同一个热门前缀时,A 的队列可能远高于 B 和 C。
CHWBL 先选 A,再检查 A 是否超过负载上界。未超过就保住缓存命中,超过便沿环转给 B 或 C。它把“缓存命中优先”改成了一个有条件的规则。精确 KV Cache 感知调度还会比较 A 实际命中了多少 cache block、三台实例各自的等待 token 和可用显存,再计算哪条路径节省的总时间更多。
异构 GPU 会再增加一个修正。若 A 的处理能力是 C 的两倍,所有副本使用相同容量上界并不合理。工程实现需要按可服务 token 吞吐设置权重,或者把负载归一化为预计完成时间。静态 WRR 能表达硬件容量差,动态 token 负载则能反映这一刻的排队,两者需要一起进入上界计算。
CHWBL 仍然看不到真实 KV Cache
CHWBL 根据请求前缀预测缓存位置。它不一定知道缓存块是否已被引擎淘汰,也不衡量匹配了多少 token。`prefixCharLength` 过短会把并不相似的请求聚到一起,过长又会降低重复率。用在途请求数作为上界,同样会忽略长短请求的计算差异。
精确 prefix-aware scheduling 会接收 vLLM 的 KV Cache 事件,维护每台实例真实持有的 prefix block,再结合队列或 token 负载选点。它能提高判断精度,代价是引擎耦合、状态同步和元数据开销。llm-d 将策略分成随机、load-aware、近似 prefix-cache-aware 和精确 prefix-cache-aware,正好对应这条演进路径。
Ray 的做法提供了另一种折中。队列差低于阈值时,路由器用 prefix tree 选择匹配率最高的副本;匹配率低于阈值时选择缓存利用较低的副本;队列差超过阈值后,退回 P2C,优先恢复负载均衡。算法没有把缓存亲和写成绝对规则。
不同组件要改的是状态,不是名字
L4 继续使用哈希、WRR 和连接表做高速转发。L7 用 Least Request、P2C、延迟、熔断和异常点剔除处理普通 API。AI Gateway 在模型之间计算能力、价格、token 配额和 fallback。推理网关再使用 Least Outstanding Tokens、CHWBL 或精确 KV Cache 感知算法选择 GPU 实例。Agent Gateway 还要把工具权限和长任务状态放进路由条件。
我的判断是,CHWBL 很适合“前缀重复明显、缓存事件拿不到、实例大致同构”的阶段。请求长度差异很大时,应把上界从在途请求数升级为 outstanding tokens 或预计服务时间。能够可靠获得 KV Cache 事件以后,精确缓存感知调度会比前缀哈希更接近真实成本。
上线前至少同时观察 TTFT、端到端延迟、输出吞吐、排队 token、prefix cache 命中率和负载偏斜。只看 GPU 利用率,无法判断调度器是在复用计算,还是把热门前缀压在一台机器上。
关键来源