一个全局开关换掉了整条请求路径
翻 BFE 的 CHANGELOG,v1.8.0 那一行写着 “Support basic functions of an AI gateway”,日期 2025-09-03。往后不到一年,v1.8.2 改进 SSE,v1.8.3 加 `mod_ai_rate_limit` 和 `EnableAiGateway`,v1.8.4 加 `mod_ai_route`,落在 2026-08-05。
我原以为这是几个模块挂上去的事。把 develop 分支拉下来读才发现,`EnableAiGateway` 定义在 `bfe_config/bfe_conf/conf_basic.go`,起作用的地方在 `bfe_server/http_conn.go`,它决定的是走 `ServeHTTPForAI` 还是走 `ServeHTTP`。整条请求路径在这里分叉。
于是一个 BFE 实例要么全是 AI 流量,要么全不是,没有按 product 混跑的口子。开关打开之后,每个请求在连接处理阶段就要读一次请求体取 `model` 字段,普通流量也躲不开这份开销。BFE 一向把 module 加 callback 的可扩展性当卖点,AI 网关这次没有走那条路。
三个模块各管一段
`mod_ai_route` 管选后端。它先从 Authorization 头取 API key,按 key 找到绑定的路由表,表分 apikey、entity、global 三类,规则的匹配条件可以直接取请求体里的 JSON 字段。命中之后在 targets 里加权随机选一个,后面跟一串 fallbacks 顺序备用。选中集群以后还做两件事,把客户端传来的模型名按 `cluster.AIConf.ModelMapping` 改写进请求体,再把 `cluster.AIConf.Key` 注入上游认证。所以调用方拿到的是网关自己的 key 和一套统一模型名,真实 provider 的凭据不出网关。
`mod_ai_token_auth` 管配额。一个 Token 记录带 `Models` 白名单、`BlockModels` 黑名单、`Subnet` 来源限制,下面挂若干 QuotaPlan,每个 plan 有独立的 Redis key 和重置方式。扣减用 Lua 脚本对那个 key 做 `DECRBY`,发生在请求结束阶段,并且只对状态码 200 的请求计。后付费这个口径要留意,高并发下同一把 key 可以扣穿。
`mod_ai_rate_limit` 管速率,三个维度。TPM 配 `MaxTokens` 加窗口分钟数加 `Burst`,RPM 配 `MaxRequests` 加窗口加 `Burst`,另外一个 `MaxConcurrency` 限并发。规则能按模型名匹配,支持 `*` 通配。状态也在 Redis,TPM 先按估算预扣,请求结束拿实际用量回填。
我在 token 计量上判断错了一次
先读的是 `mod_ai_token_auth`。它的响应处理入口要求状态码 200 并且 `res.ContentLength >= 0`,我在模块里搜了 `IsSse`、`stream`、`[DONE]`,一处都没有,于是下了个结论,流式请求的配额扣减会落空。
这个结论是错的。计量不在那个模块里。
干这件事的是 `mod_body_process`。`DoResponseProcess` 默认给 AI 的 200 响应挂一个 `QuotaUsageProcessor`,用 `NewSSEEventDecoder` 把响应体拆成一个个 SSE 事件,每个事件调 `GetQuotaUsage`,从 chunk 里抽 `usage.total_tokens`、`usage.prompt_tokens`、`usage.completion_tokens`。抽不到就退到 `EstimateContentToken`,按事件内容累加估算。挂载不需要配规则,响应是 200 就行。
同一个模块还算出 TTFT 和 TPOT,连同 `AiApikey`、`AiRequestedModel`、`AiMappedModel`、`AiPromptTokens`、`AiOutputTokens`、`AiAuthRejectReason` 一起写进 `mod_access_pb3` 的访问日志。做部门用量分析,这些字段够用。
顺手记一个瑕疵。`TFirstToken` 的时间戳打在 `readResponseHandler` 里,而这个回调在响应头到达时就触发,不在第一个带生成内容的 chunk 到达时。注释写的是后者。流式场景下响应头通常先于首 token,所以 BFE 记的 TTFT 会偏小。这一条我只读了代码,没有实机测量。
健康检查只在后端已经挂了以后才主动探
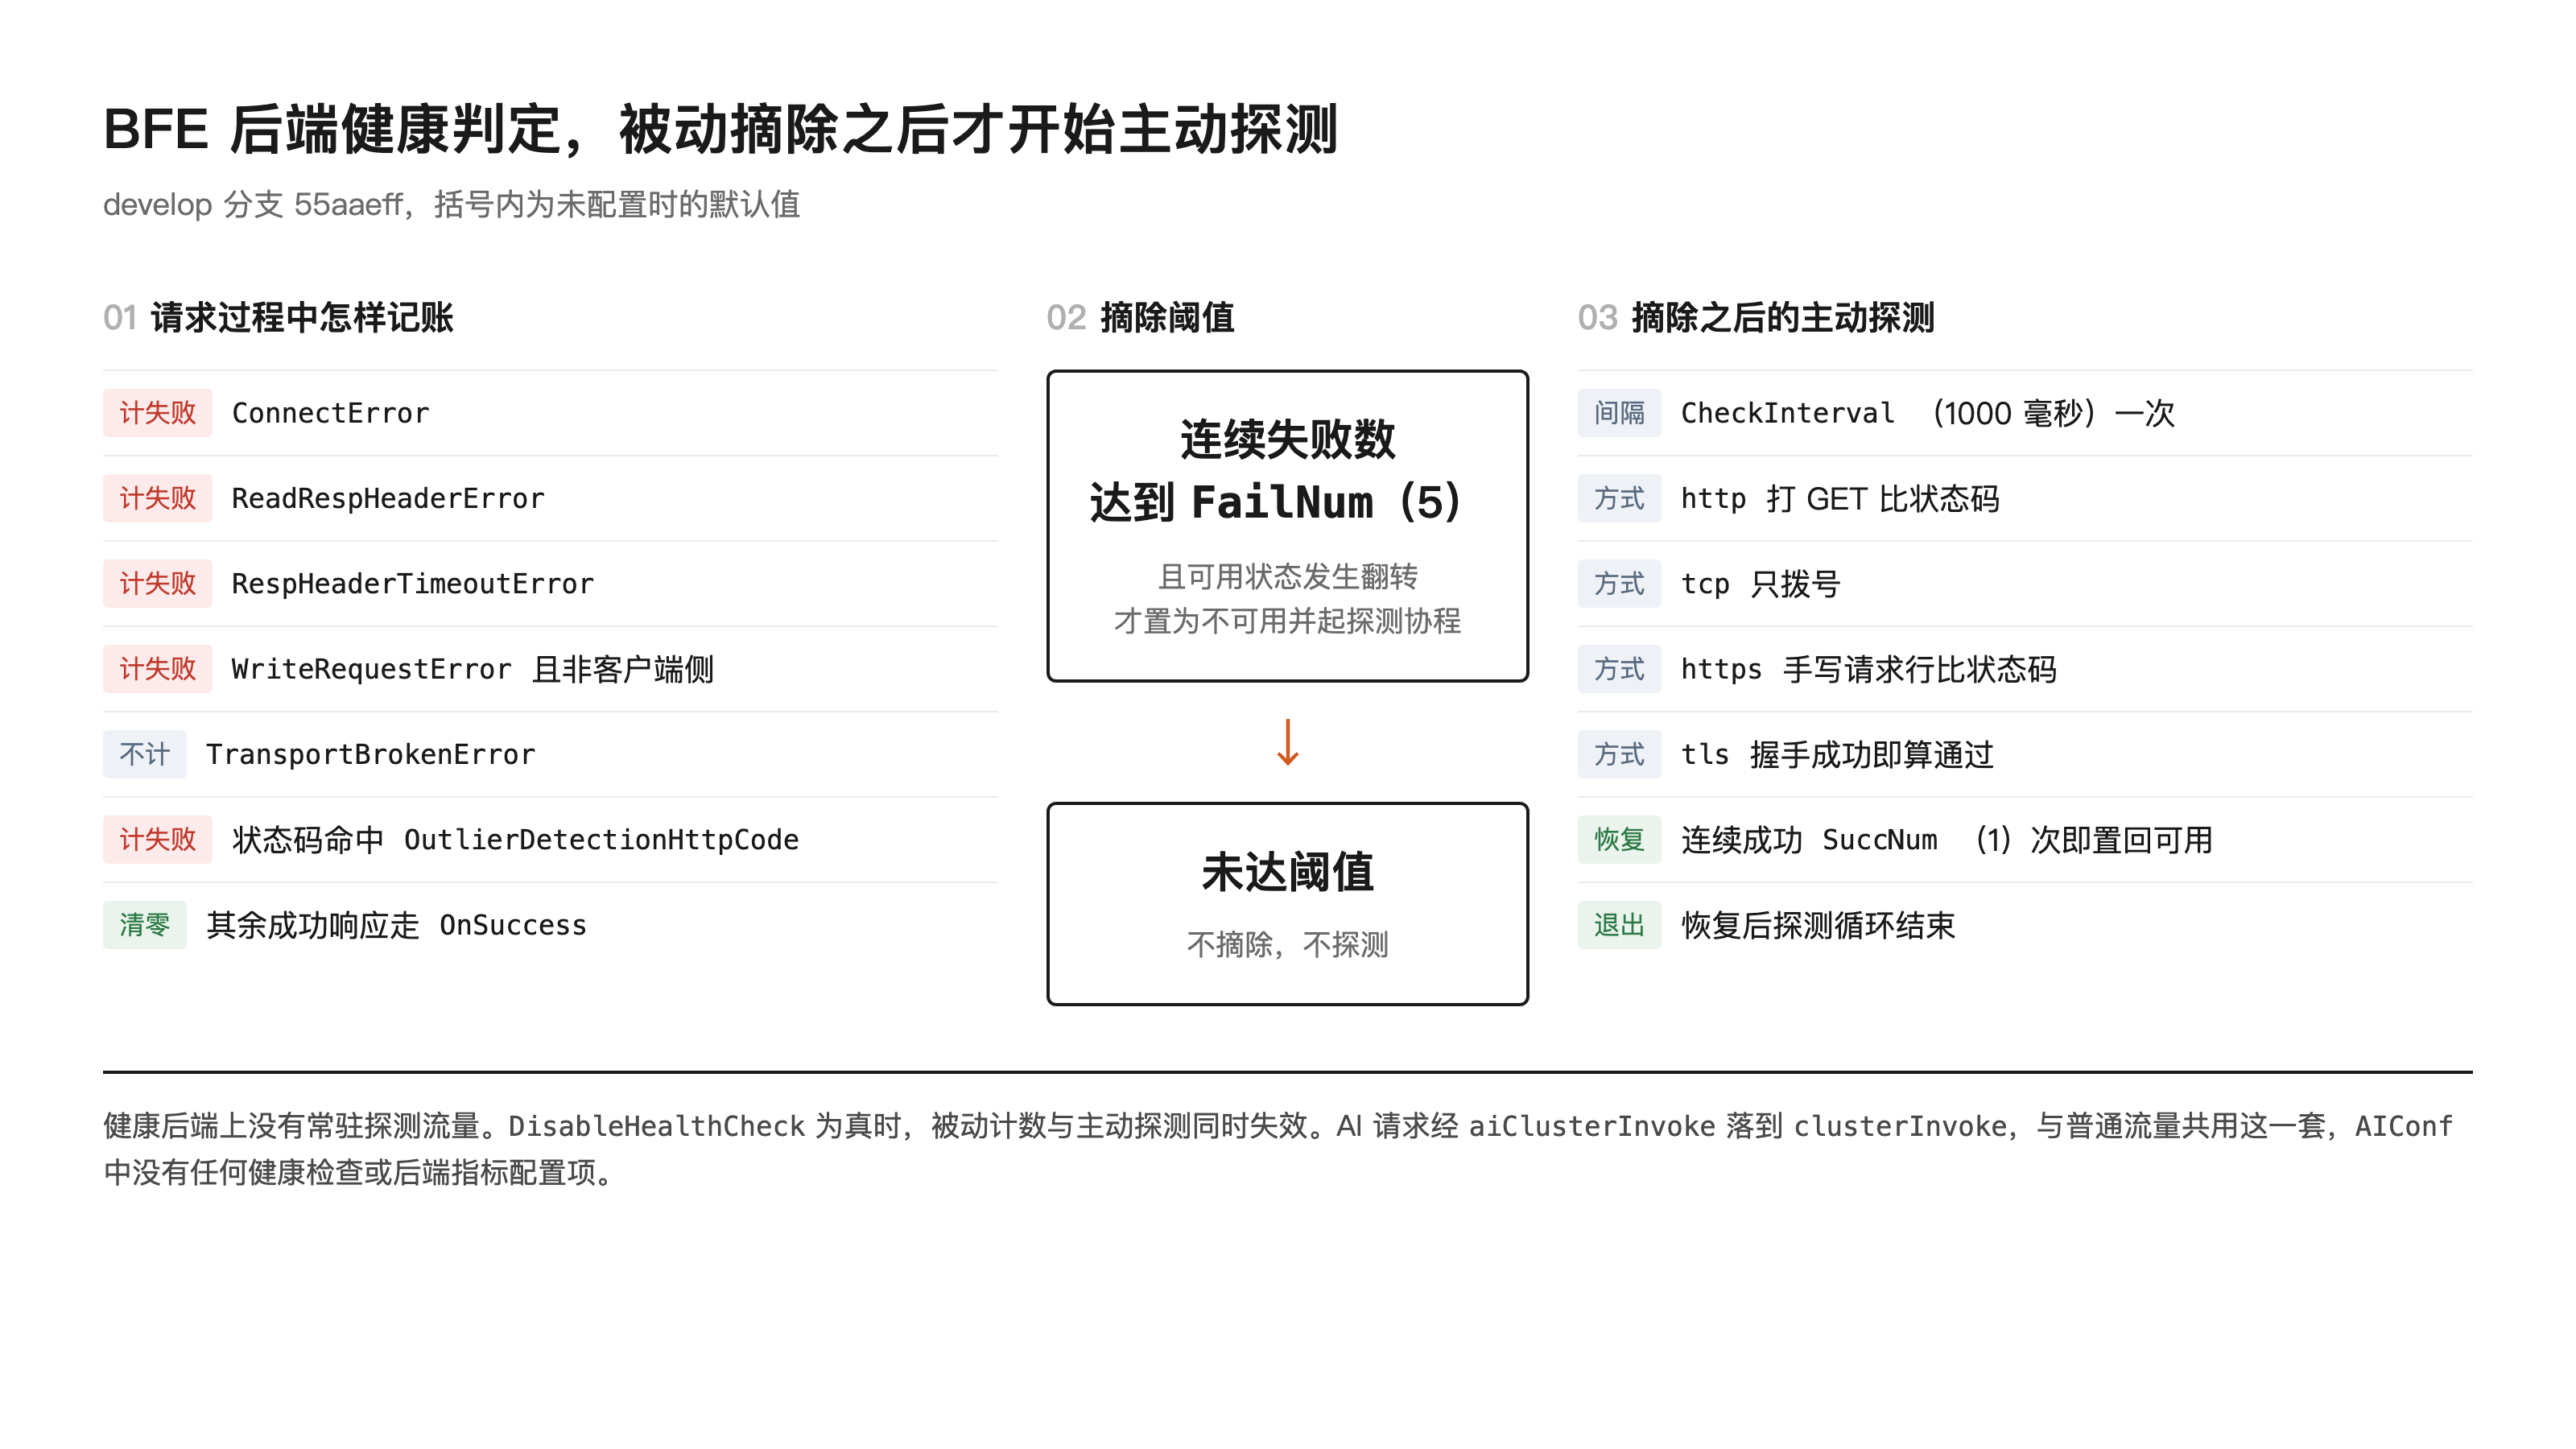
AI 请求经 `aiClusterInvoke` 落到 `clusterInvoke`,失败记账全在后者里,跟普通流量共用一套。
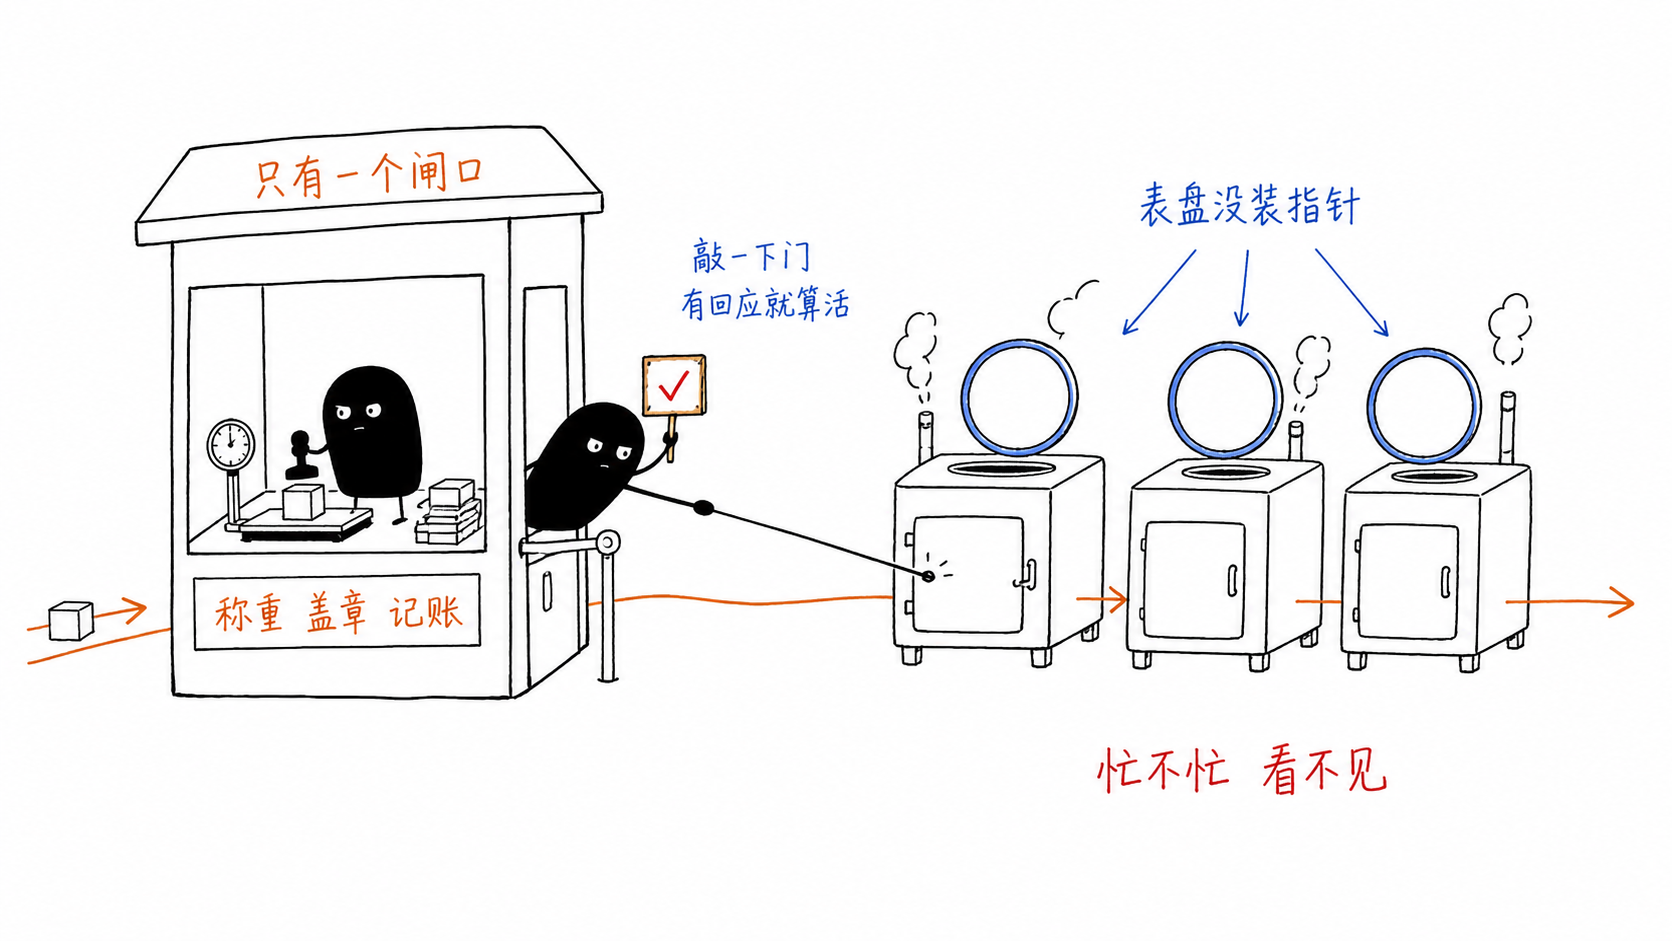
被动那半边是这样。拿到响应后,状态码命中 `OutlierDetectionHttpCode` 就记一次失败,否则 `OnSuccess` 把计数清零。`ConnectError`、`ReadRespHeaderError`、`RespHeaderTimeoutError` 各自记后端失败,`TransportBrokenError` 明确不记。
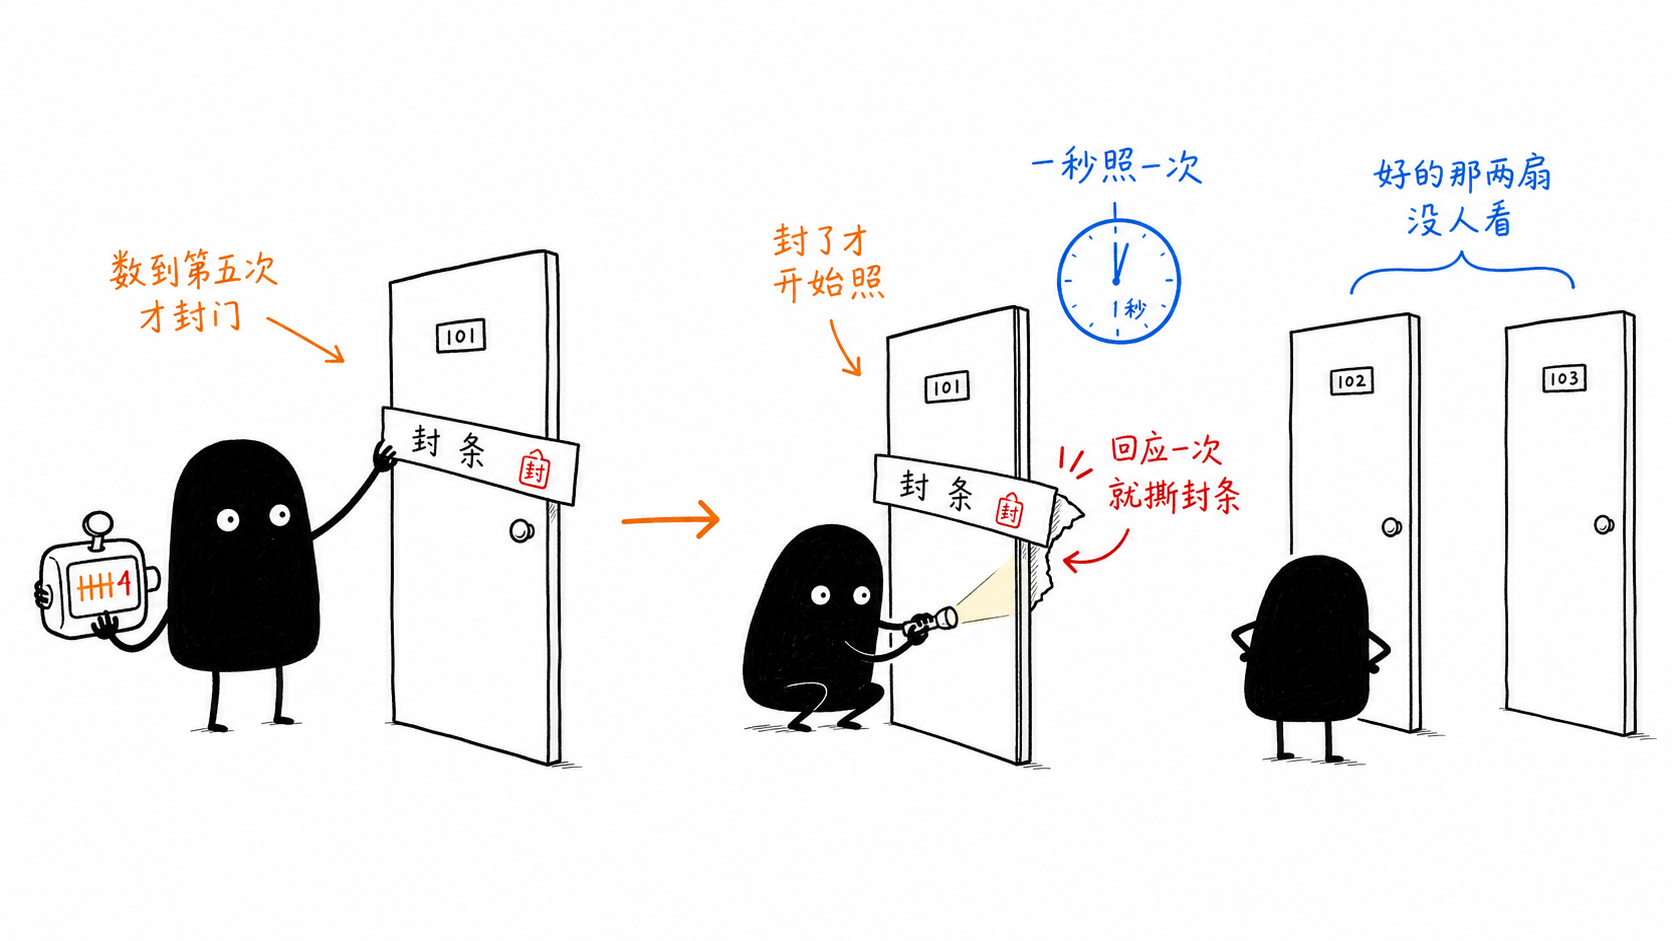
主动那半边的启动条件容易看漏。`OnFail` 走到 `UpdateStatus`,只有连续失败数达到 `FailNum`、并且状态从可用翻成不可用的那一刻,才 `go check(…)` 起一个探测循环。探测连续成功 `SuccNum` 次后置回可用,随即退出循环。健康后端上没有常驻探测流量。默认值是 `FailNum` 5、`SuccNum` 1、`CheckInterval` 1000 毫秒。探测方式四种,`http` 打一个 GET 比状态码,`tcp` 只拨号,`https` 手写请求行,`tls` 握手成功就算过。
AIConf 里只有三个字段
1 | |
集群级的 AI 配置就这些。没有任何位置能放后端指标来源,所以对一台 LLM 实例的探活仍然是打个 URI 比状态码,不会去看模型加载完没有,也不会问它排了多少请求。
由此长出来的几处错配都能对上。LLM 后端过载的典型表现是 429 和排队变慢,`shouldTriggerFallback` 只认 `err != nil` 或者状态码大于等于 500,`OutlierDetectionHttpCode` 默认也不含 429。上游返回 429,fallback 不换集群,后端也不扣分。想接住它,得手工把 429 写进摘除码表,写成 `4xx` 又会把正常的参数错误算成后端故障。
生成到一半断掉的情况也漏在外面。首字节之后的中断属于响应体传输阶段,不在那组错误分类里。这是我按错误类型推的,没有实机验证。
按缺失项核对了一遍
在 `55aaeff` 这个快照里,语义缓存和 prompt 缓存没有。对高重复率的问答场景,这是成本上最大的一块钱,Kong AI Gateway 和 LiteLLM 都做了。KV cache 感知或前缀感知路由没有,`mod_session_sticky` 按会话粘住实例,跟命中前缀缓存不是同一件事。读推理引擎队列指标的调度没有。Kubernetes Gateway API Inference Extension 那套 Endpoint Picker 协议没有实现,接不进社区正在成形的推理调度标准。MCP 与 A2A 协议没有,Agent 侧的工具权限和 workload identity 也没有。
内容安全这块要说清楚。`mod_unified_waf` 是把请求转给外部 WAF 服务,计数器只有放行、拦截、超时、网络错误这几类,里面没有 prompt 注入或 LLM 语义规则。`mod_body_process` 的处理器链上确实挂得下一个 `textfilter` 做内容审核,能对流式输出逐帧过一遍,能力在,规则要自己接。
成本口径也缺。日志里记的是 token 数,配额扣的也是 token,没有按模型单价折算金额的地方。要出部门账单,得在外面再接一层。
判断
这套东西作为 AI 网关是可用的,我不同意说它两头都不合适。API key 认证、Redis 配额扣减、模型白黑名单、TPM 与 RPM 与并发三维限流、模型名映射、多 provider fallback、流式 token 计量、TTFT 与 TPOT 日志,把「公司内部统一 LLM 出口」这个场景的刚需覆盖住了。它是个 Go 单体,除 Redis 之外不吃外部控制面,运维上比 Envoy 那一套轻。
作为推理网关不行,缺的不是功能,是一层抽象。它没有任何数据结构承载「这台后端现在有多忙」。路由靠加权随机,健康是布尔值,恢复判定给一次成功就放行。而 LLM 后端的可路由性本来是个连续量,队列深度和 KV cache 占用才是它的真实状态。前缀感知路由、负载感知调度、饱和时的排队与优先级,这三件事之所以都做不了,同一个原因。
材料只到公开代码这里。我读的是 develop 分支 `55aaeff`,2026-08-06 那次提交刚把版本号推到 1.8.5。没有跑过压测,也没有 BFE 团队公开的 AI 网关设计文档,仓库里没有 ROADMAP 文件,所以下面这段是外部判断,不是官方计划。
要补的话,第一步不该是加功能,该是给 `AIConf` 开一个读后端指标的口子,并把目标选择从纯权重改成可插拔。这一步做完,负载感知、前缀感知、排队都有地方落。第二步是 429 这条链路,让它同时能触发 fallback 和后端降权,改动小、收益直接。语义缓存、真 tokenizer、MCP 支持排在后面,它们是能力扩展。`EnableAiGateway` 从进程级降到 product 级也该早做,那是工程债,不影响能力天花板。
来源
-
BFE CHANGELOG,v1.8.0 至 v1.8.4 的版本与日期
-
BFE develop 分支 55aaeff,本文全部代码事实的基线