我一开始把 Kubernetes Gateway API Inference Extension 里的 Endpoint Picker 当成一个更聪明的 least-request。真正让我改看法的是 Envoy 那份负载均衡文档,它把加权这条路能走到哪里写得很清楚,而 EPP 想要的东西刚好在那条路的外面。
权重是实例自己的属性
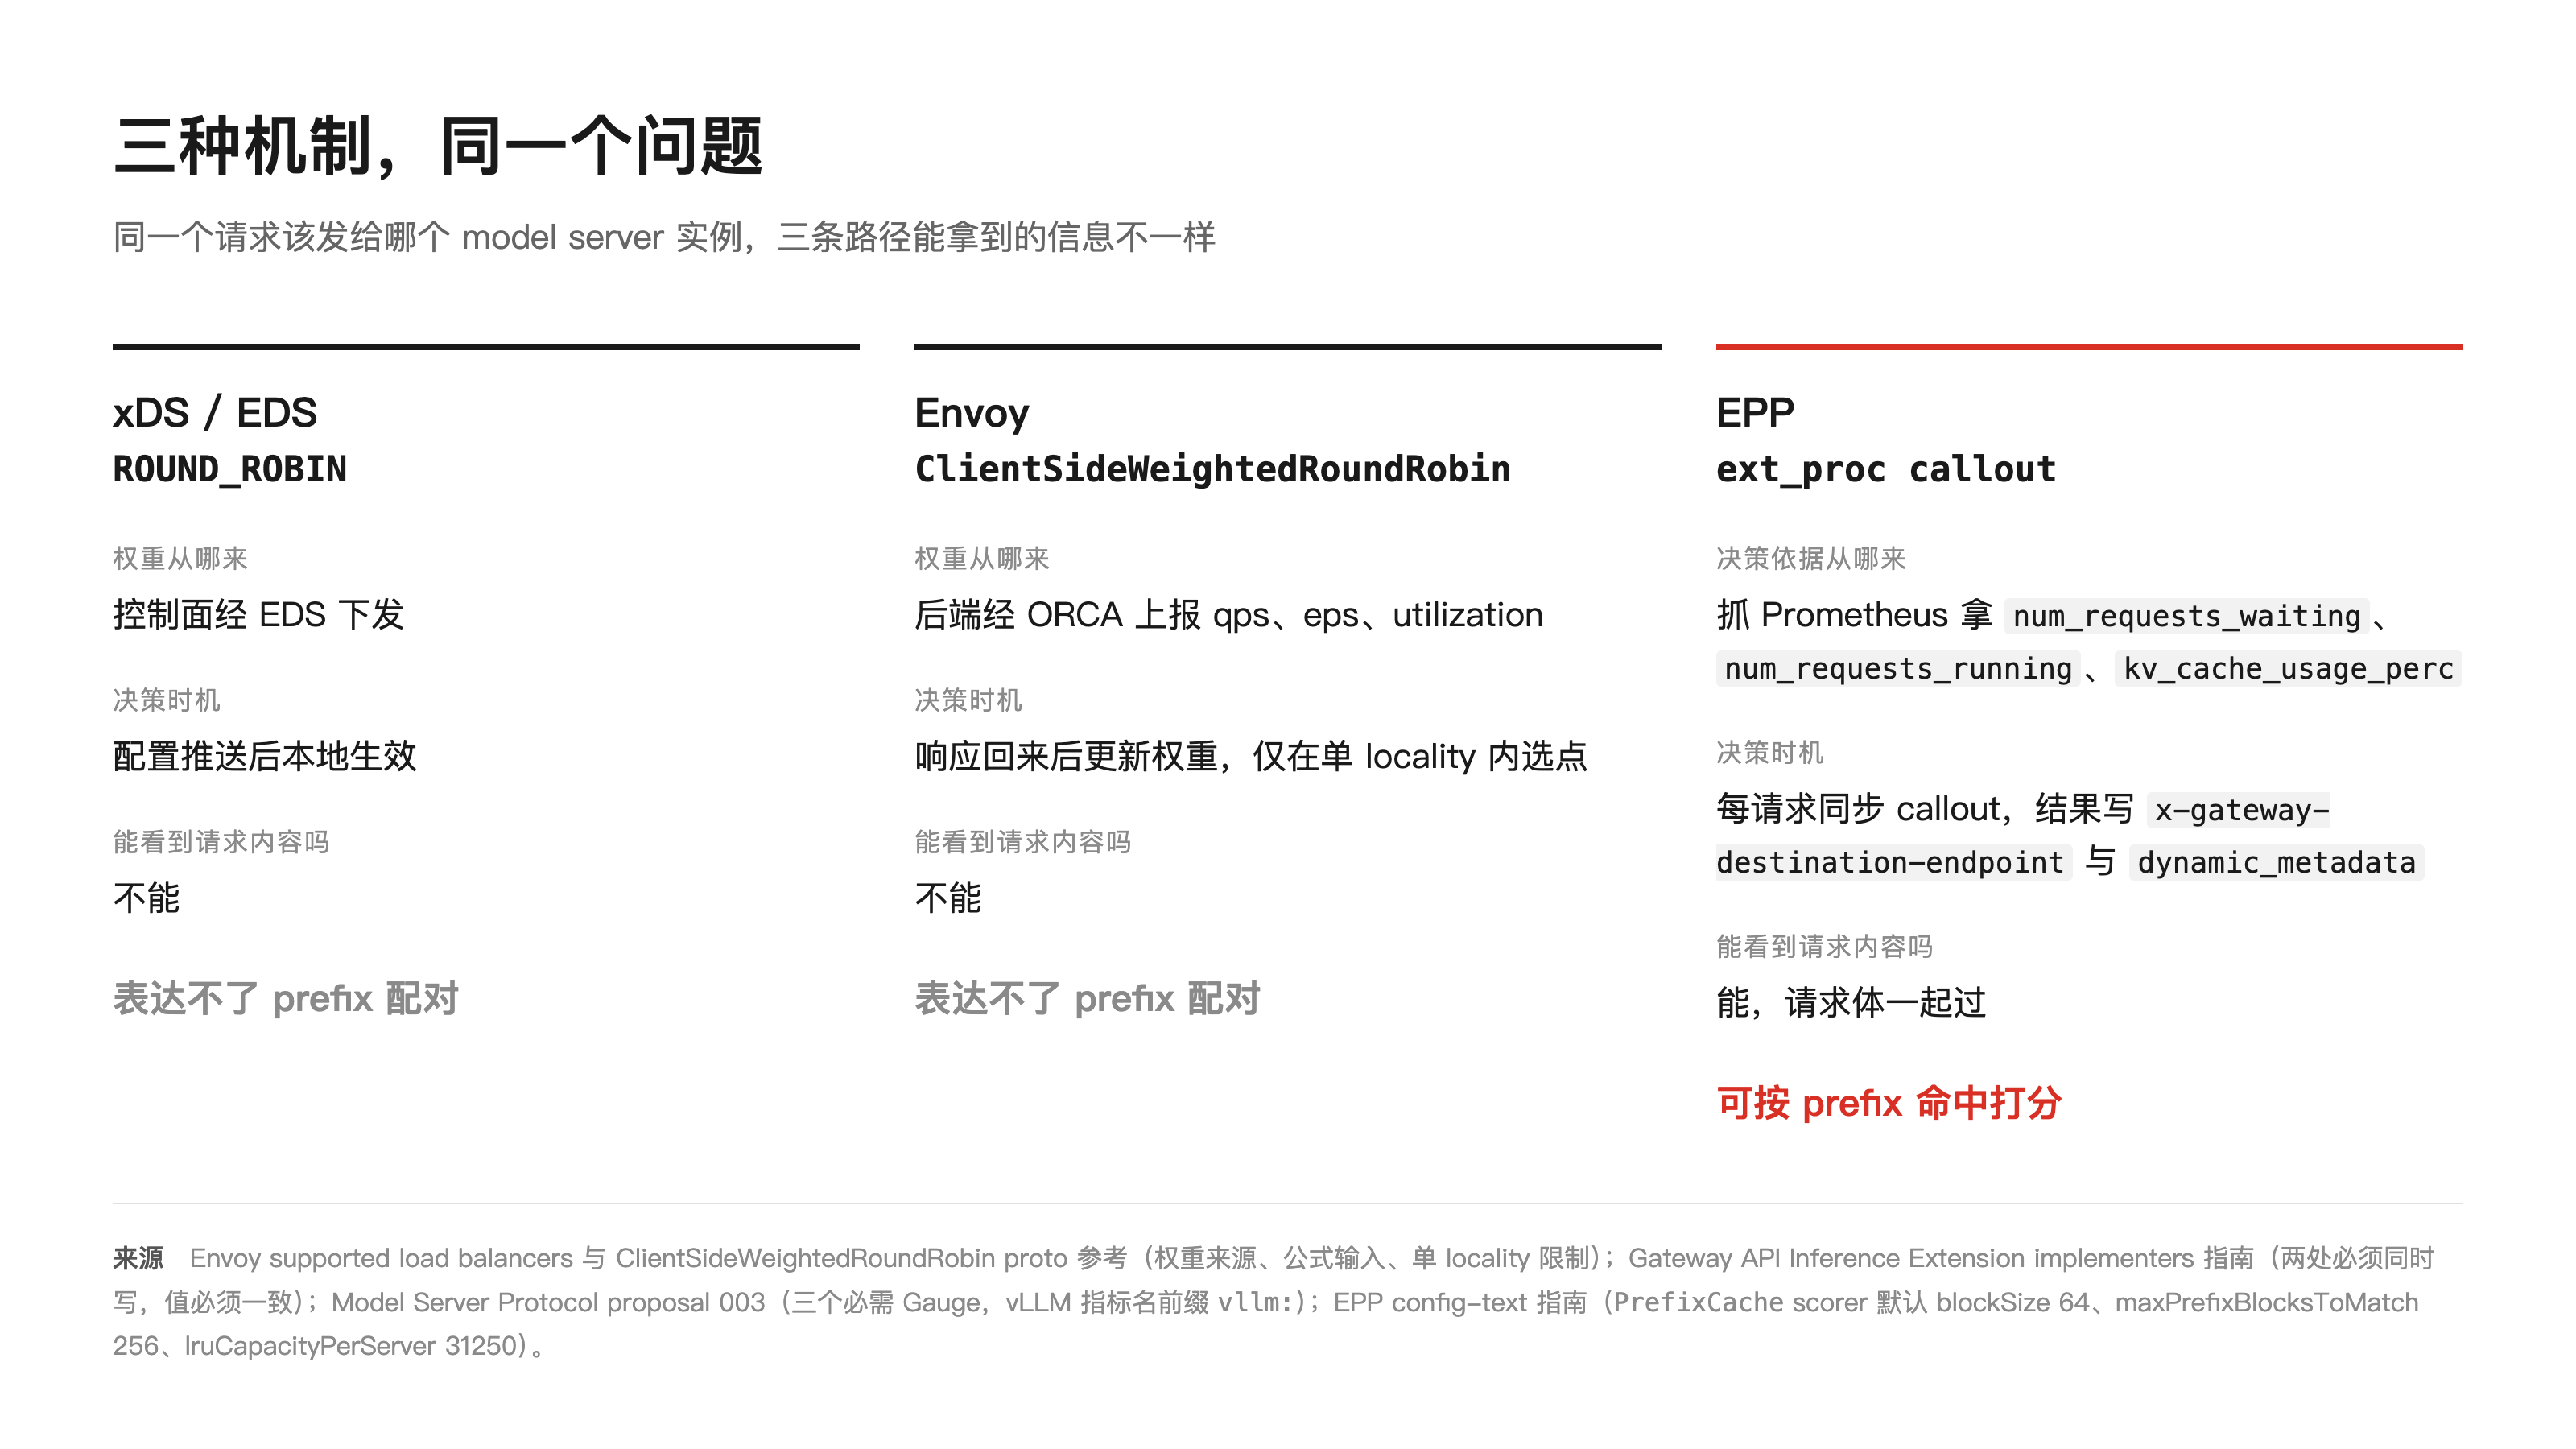
先看普通七层负载均衡最多能做到什么。Envoy 的 ClientSideWeightedRoundRobin 已经是这条路上走得很远的一个扩展。它的 endpoint 权重不由控制面经 EDS 下发,改成由后端自己通过 ORCA 协议上报 qps、eps 和 utilization,权重按 `qps/(utilization + eps/qps × error_utilization_penalty)` 现算。上报里 `rps_fractional` 不大于 0 或最终 utilization 不大于 0 的会被忽略,暂时没有有效权重的 endpoint 取其他 endpoint 权重的中位数。Envoy Gateway 把它包成 BackendUtilization,gRPC 后端由 xDS ORCA 库自动上报,HTTP 后端要自己在每次响应里加一段序列化指标的 middleware。
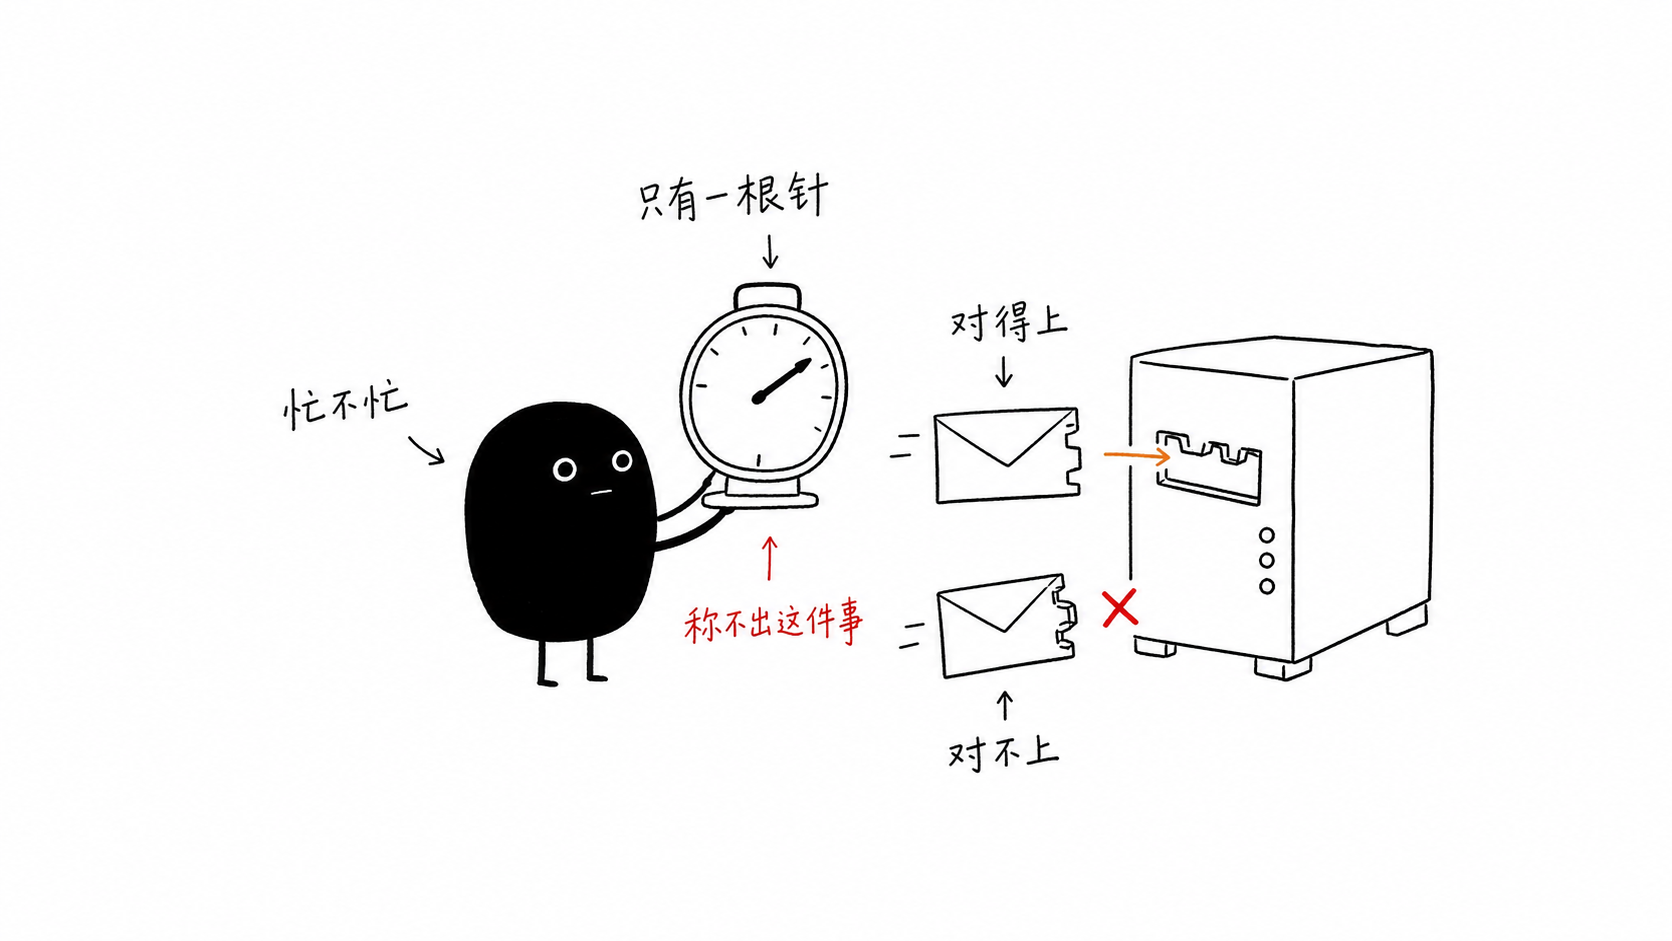
这套东西能表达一件事,某个实例现在有多忙。
LLM 推理里最值钱的信号不长这样。一个请求打过去要不要重跑一遍 prefill,取决于它的 prompt 前缀有没有落在那台机器的 KV cache 里。同一台机器对 A 请求命中,对 B 请求不命中。这个信号属于请求与实例的配对,权重是实例单方面的一个标量,更新得再快也装不进配对关系。
想清楚这一点,EPP 的形态就成了被逼出来的结果。
于是它长成了一个每请求被问一次的外部进程
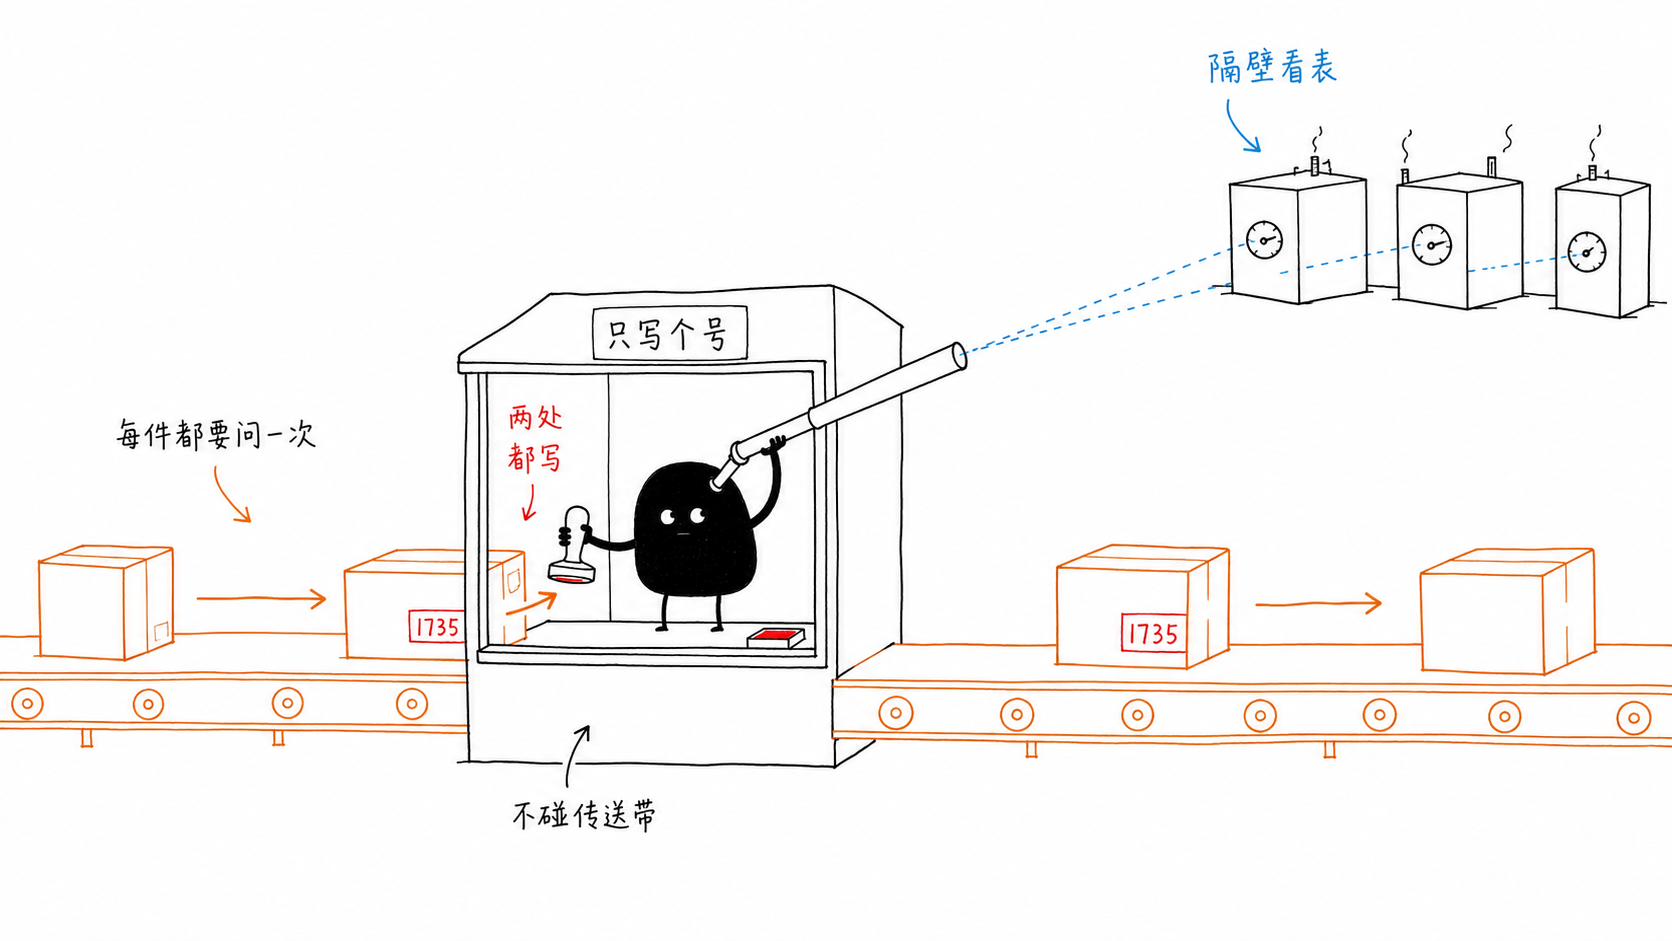
按 InferencePool API,EPP 是集群里一个独立部署,用 gRPC 实现 Envoy 的 External Processing 协议,由 `InferencePool` 的 `endpointPickerRef` 挂上去。`InferencePool` 已经 graduate 到 `inference.networking.k8s.io/v1` 并标为 stable。同一份文档里写明一个 EPP 只能关联一个 `InferencePool`,反过来一条 `HTTPRoute` 可以把多个池当 `backendRefs`。`endpointPickerRef` 在 v1.5.0 之前必填,现在改成可选,用来容纳网关自己内建选点逻辑的用法,具体实现支持不支持要查那家的文档。
它同时跑两条通路。一条是异步的,EPP 按 label selector 自己 watch Pod,周期性抓每个 model server 的 Prometheus 端点。Model Server Protocol 要求必须提供排队请求数、运行请求数和 KV cache 利用率三个 Gauge,指标名可以不同,类型和语义不能变。vLLM 那边对应 `vllm:num_requests_waiting`、`vllm:num_requests_running`、`vllm:kv_cache_usage_perc`,SGLang 是 `sglang:num_queue_reqs`、`sglang:num_running_reqs`、`sglang:token_usage`。model server 还必须实现 OpenAI 的 Completions 与 Chat API。
另一条是每请求同步的。implementers 指南规定,网关可以在 ext-proc 请求的 filter metadata 里设 `x-gateway-destination-endpoint-subset` 限定候选集,设了 EPP 就必须从这个列表里选,列表为空或没有合格 endpoint 时返回 503,不设就从池 selector 的全集里选。EPP 选完必须把结果同时写进 `x-gateway-destination-endpoint` header 和响应的 `dynamic_metadata`,两处值要一致,只写一处会得到 503 或 429。
请求体也要过这一趟。prefix 打分要看 prompt 本身,这是它用 ext_proc 而不是一个轻量 header 扩展的原因。打分逻辑在 EPP 配置里是插件框架,profile handler 决定走哪个 scheduling profile,scorer 打分再由 picker 收口,默认 picker 是 `MaxScorePicker`。`PrefixCache` scorer 估算 prompt 有多少已经在这台机器的 KvCache 里,默认 `blockSize` 64、`maxPrefixBlocksToMatch` 256、`lruCapacityPerServer` 31250。每个 scorer 在 profile 里带一个权重,加权求和。
这就是配对属性能被表达出来的地方。它有状态,看得见请求内容,跑在 model server 隔壁。
同一份配置里还有两样东西顺手接进来了。`LoRAAffinity` scorer 靠 model server 从同一个 Prometheus 端点暴露的 `vllm:lora_requests_info` 工作,里面带 `max_lora`、`running_lora_adapters` 和 `waiting_lora_adapters`。提案自己承认,参考 EPP 现在的 LoRA 亲和算法高度偏向 vLLM 那套动态 LoRA 实现。另一样是 `saturationDetector`,它单独判断系统整体是不是已经饱和,饱和以后要不要走特殊路径。协议层面也留了余地,EPP 可以在同一个 metadata namespace 下用 `x-gateway-destination-endpoint-fallback` 多给一个备选 endpoint。
同一个想法在 SGLang 那边落成了另一种东西
sglang-router 现在叫 SGLang Model Gateway,它的 `cache_aware` 策略维护一棵 prompt 前缀树来接住重复流量,命中不够或负载偏斜过阈值时转去均衡,阈值参数有 `cache-threshold`、`balance-abs-threshold`、`balance-rel-threshold`、`eviction-interval` 和 `max-tree-size`。前缀树这一层的思路和 `PrefixCache` scorer 是一回事,两边都在网关侧维护一个近似视图。
差别在位置上。Model Gateway 自己监听端口、自己 proxy 请求体,暴露 OpenAI 兼容的 `/v1/chat/completions` 和 `/v1/responses` 这些端点,`WorkerManager` 通过 `/get_server_info` 与 `/get_model_info` 探 worker 并跟踪负载,每个 worker 配了 circuit breaker。它还支持 prefill 与 decode 分离,`prefill` 条目可以带 bootstrap port,PD 模式会把 prefill 元数据和 decode 输出合并后流式返回,两边策略可以分开设。
所以这两个东西在选点这一层是替代关系,在整条链路上位置不同。EPP 只出决策,转发由 Envoy 负责,挂了可以按 `failureMode` 退化。Model Gateway 是数据面本体,挂了链路就断,它也因此把重试、限流和熔断都做进了自己。
这个形态顺手把调度域钉在了一个集群里
EPP 要能直连 Pod 抓指标,callout 每请求同步阻塞,一个 EPP 只绑一个靠本集群 label selector 选 Pod 的池。三条加起来,跨 region 的请求级推理调度在现在的模型下做不成。跨洲抓来的队列深度到手就旧了,同步那一跳直接加在首 token 延迟上。
上游承认这个缺口。Multi-Cluster InferencePools 提案引入控制器托管的 `InferencePoolImport`,让 `HTTPRoute` 引用它路由到远端集群的池。提案要求实现至少支持两种模式之一,Endpoint Mode 直接打到远端 Pod,前提是集群间 Pod 与 Service 网络连通,Parent Mode 打到远端池的 parent 比如 Gateway,只要求 parent 连通。它的动机写得很直白,GPU 容量稀缺且分散,单集群很少能吃下峰值。这份提案状态还是 Draft。
跨 region 实际只有 Parent Mode 走得通,而 Parent Mode 本身就是分层。全球那层选集群,请求级选点交回远端的 EPP。
Envoy 侧还有一处容易踩空。EPP 指名了具体 endpoint,Envoy 原本的 priority 与 locality 那两步就被跳过了。协议留了个口子,网关可以在 callout 之前把候选集限定到本 locality。但 envoyproxy/ai-gateway 的 issue 423 讨论的还停在更前面一步,Envoy 要么给每个 endpoint 用 subset,要么开一个专门支持 endpoint picker 协议的 LB policy,里程碑标着 v0.3.0。协议允许网关做,和你手上那个网关版本已经把它暴露成配置项,是两件事。
社区版 nginx 走不了这条路,它没有 ext_proc。能用的是 NGINX Gateway Fabric 2.2,它按自己的 external processing 机制调用标准 EPP,不自造调度逻辑。
我的判断
EPP 值得单独存在的理由只有配对属性这一条。队列深度和 KV cache 利用率这类标量信号,ORCA 加权已经能做到次秒级反应,真要抠也抠不出多少差距。prefix cache 亲和是权重机制拿不到的东西,它也顺带解释了为什么这类调度必须贴着 model server 放。
选型时按这个判据分。`InferencePool` 当标准接口,EPP 实现可替换,上游已经把 EPP 和相关 API 迁到了 llm-d/llm-d-router,仓库里只留一个做一致性测试的轻量 EPP。方向很清楚。
这个判断建立在公开文档上,我没有跑过跨 region 的推理压测,也没有实测过 prefix 命中带来的首 token 收益。手里的材料够说明各家现在为什么这样切,不够断言以后不会出现别的解法。
落到动作上
先确认你的 model server 真把那三个指标吐出来了,不然 EPP 只能退化成加权轮询。`failureMode` 想清楚要 FailOpen 还是 FailClose,EPP 挂掉时的行为得是设计出来的。跨 AZ 流量费和 RTT 已经咬人的话,先查你手上那个网关有没有把 callout 前限定候选集这件事暴露成配置。没有就接受 EPP 选点时不看 locality。跨 region 别指望一层解决,全球那层做 region 粒度导流,把容量上限显式配出来。
来源