推理集群一旦铺到多个 AZ、多个 region,工程上第一个冒出来的念头往往是在最前面加一个全局七层调度器,让它看见所有机房的 GPU,然后统一分配请求。这个念头很自然,但也很少有人真的做成。
我原本以为这是各家还没做到。把厂商文档和几个开源项目的调度设计翻了一圈才发现,大家是有意不做。全球那一层被刻意留得很笨,聪明的部分全放在机房里面。
两种不均,时间尺度差得太远
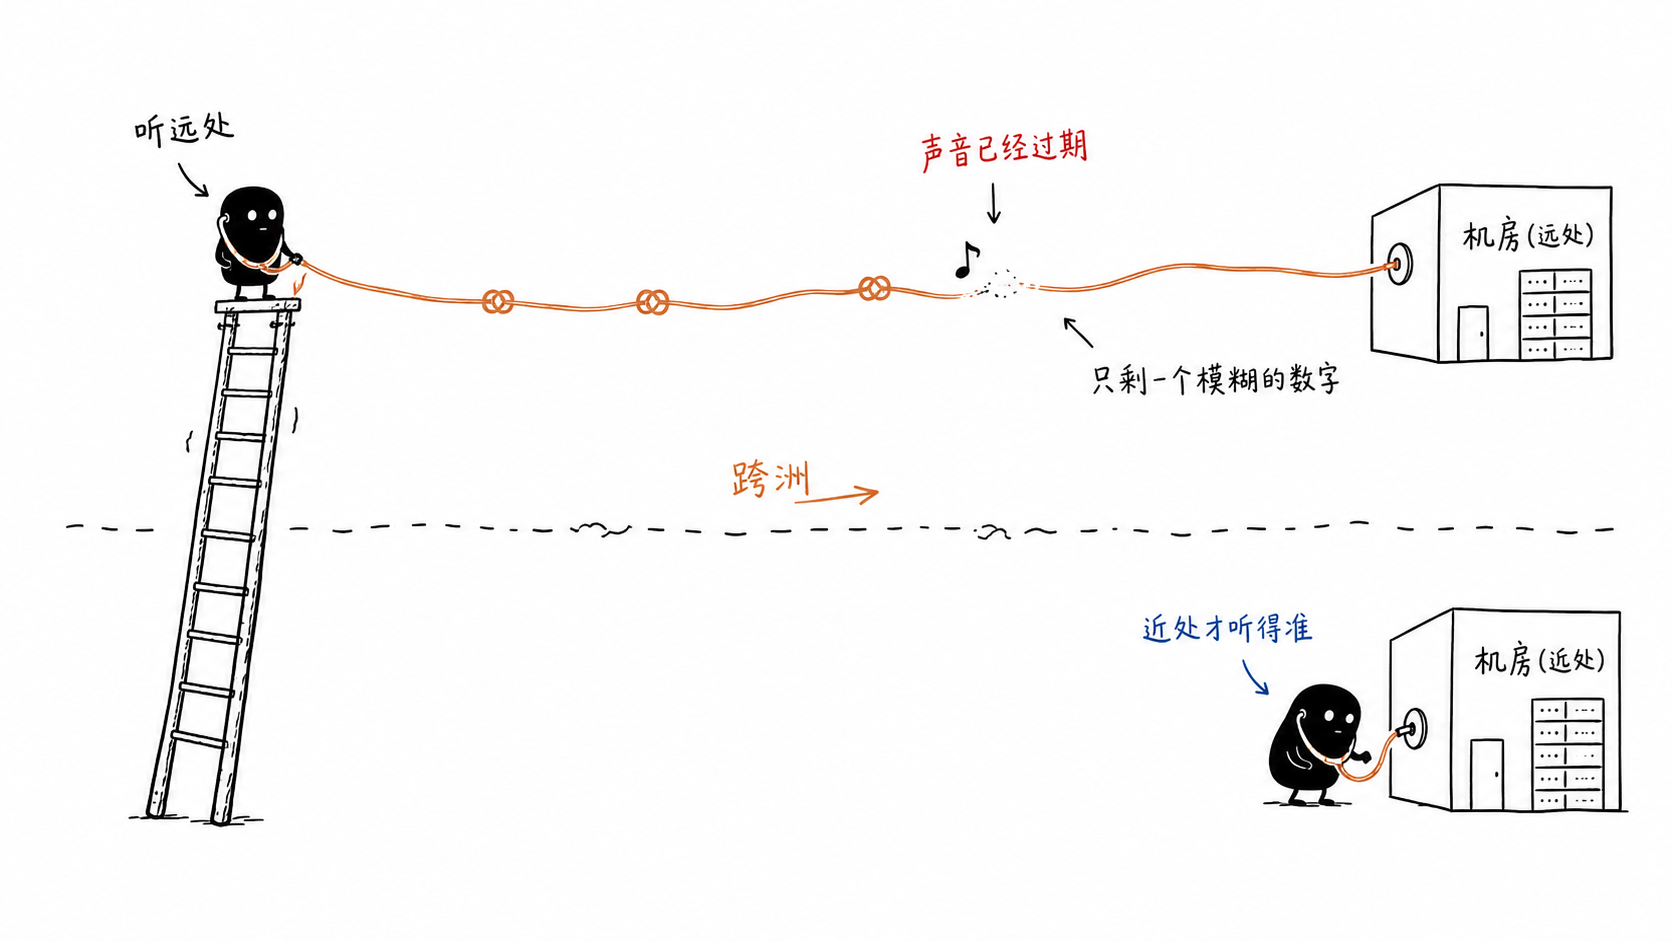
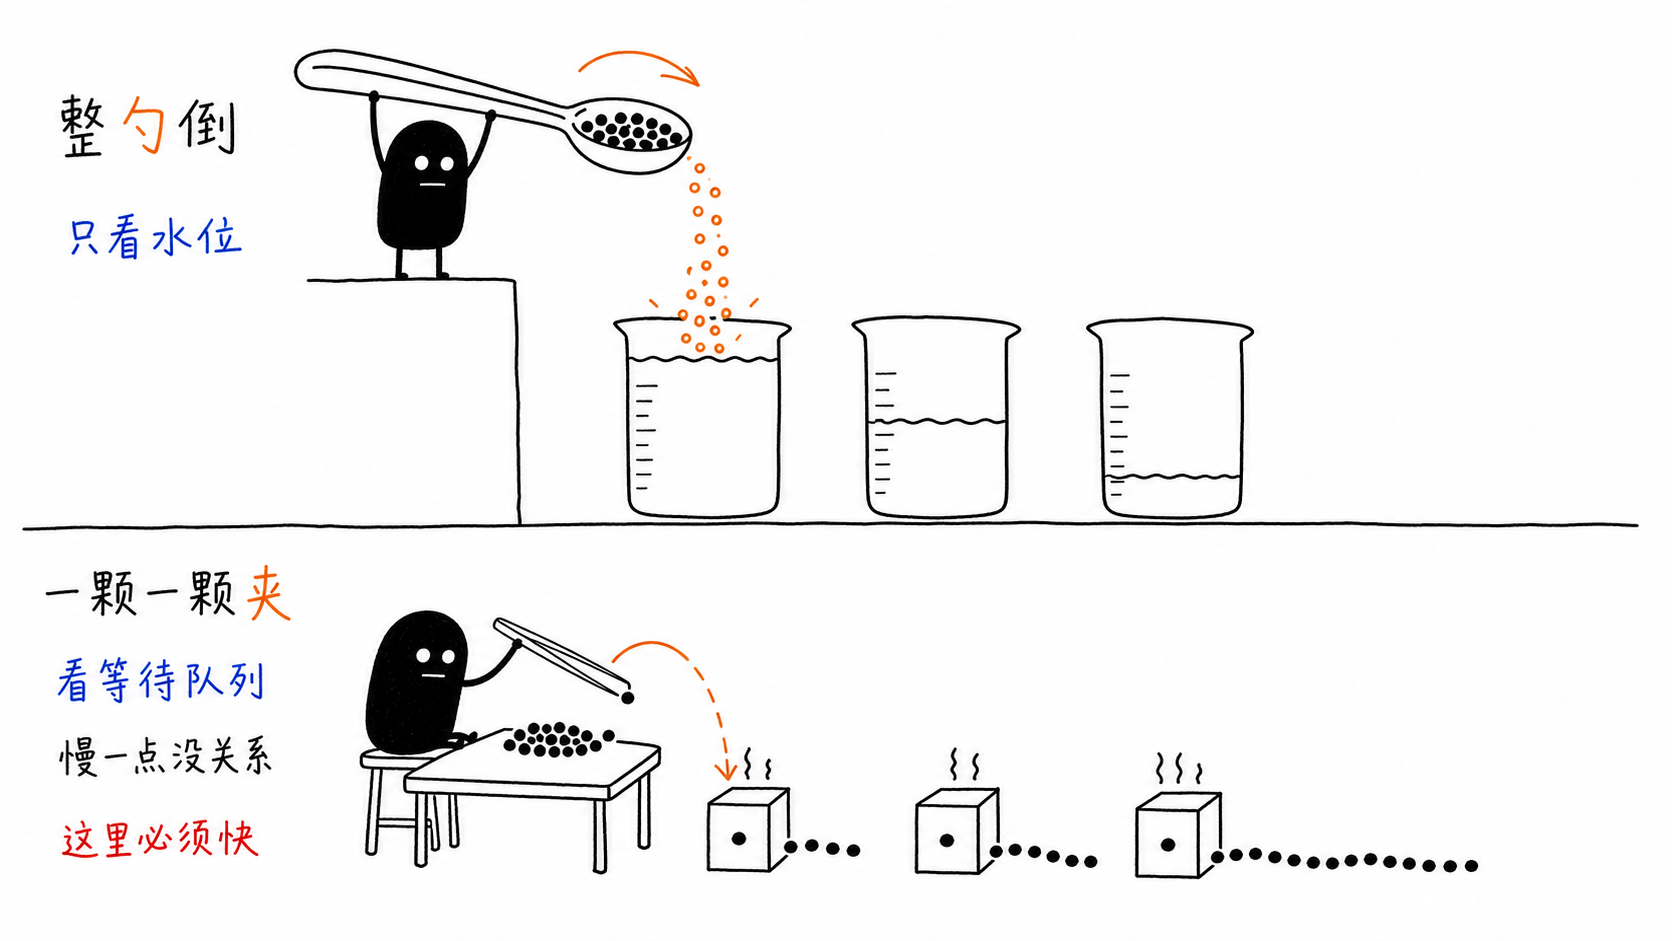
推理负载的不均,跟普通 Web 服务的不均不是一回事。一个请求打到哪张卡上,取决于那张卡此刻的 KV cache 占用、等待队列长度,以及 prefix 是否已经在它的缓存里。这些状态毫秒级变化,只有离 model server 很近的组件才看得清。
region 之间的容量不均是另一回事。某个 region 的 GPU 配额用满了,某个 AZ 的机器在滚动升级,某个地区的白天流量高峰来了,这些变化以分钟甚至小时计。
一个调度器同时管这两件事,就得同时满足毫秒级的状态新鲜度和跨洲的网络往返。这两个要求互相打架,所以实现上都拆开了。
全球那一层只认容量和健康
Google Cloud 的负载均衡文档把这个分工写得最直白。Backend service overview 说明,全球与跨 region 的负载均衡器使用容量把请求导向不同 region 的 zone,所有 zone 都达到目标容量之后,新请求按比例超额填充。文档还专门提醒一句,目标容量不是熔断器。
全球外部 ALB 的流量管理文档把顺序讲得更清楚。balancing mode 决定流量分给哪个 backend group,也就是哪个 zone 或哪个 region,`localityLbPolicy` 才决定组内选哪个 endpoint。先选组,再选实例。
Cloudflare 用了几乎相同的切法。它的流量导向文档把策略直接命名成 global traffic steering 和 local traffic steering,前者在负载均衡器上把流量导向可用的 pool,后者在 pool 内导向 endpoint。它的 dynamic steering 基于健康探测 RTT 的指数加权移动平均建立画像,文档提示配置变更要预留大约 10 分钟才能生效。十分钟这个量级,已经说明这一层不打算管请求级的事。
Azure Front Door 也是同样的。它先用健康探测筛掉不可用的源站,再取 priority 最高的一组,然后在允许的延迟区间内挑,最后按权重分配。整条链路上没有任何一步会去问模型服务器现在忙不忙。
AWS 的组合更保守。Route 53 的延迟路由在 DNS 层选 region,Global Accelerator 用 anycast 在四层把流量送到最近的健康 region,七层的 ALB 始终是 region 内的东西。托管推理那一侧,Bedrock 的跨区推理干脆把跨 region 的容量调度收进服务内部,绑定地理区的 inference profile 会在该地理区内自动挑选 region。
机房里那一层才看 GPU 的真实状态
推理特有的调度全部发生在这里。Kubernetes 的 Gateway API Inference Extension 里,`InferencePool` 已经毕业,到 `inference.networking.k8s.io/v1` 并被标为 stable,它的 Model Server Protocol 要求 model server 至少暴露排队请求数、运行请求数和 KV cache 利用率这三个指标。
Google 在 GKE Inference Gateway 文档里写明,代理对每一个请求都通过 ext-proc 协议咨询 Endpoint Picker,EPP 用 KV cache 利用率、队列长度、prefix cache 状态和 LoRA 亲和这些实时信号,为每个 model server Pod 算一个分数。
规格里还有一条容易被忽略的约束,一个 EPP 只能关联一个 `InferencePool`。这个一对一关系把调度域的边界钉在了池的边界上,而池默认活在一个集群里。
通用服务网格的做法也是同样的。Envoy 的选择顺序是先选 priority level,再在该 priority 内选 locality,最后才在 locality 内用集群的负载均衡器挑 endpoint。Istio 的 locality load balancing 建立在这套机制上,层级是 region、zone、sub-zone,它的文档还明确说跨 locality 的故障转移必须先配好 outlier detection 才能正常工作。跨 region 的切换靠探测到对面坏了驱动,不靠看到对面更闲驱动。
合成一层要付的账
Azure 架构中心那篇多后端网关指南把代价写得最不客气。它指出单 region 网关跨 region 调用后端会带来更多网络延迟和出网费用,在需要严格数据驻留、不允许跨境处理的场景下,用一个全局网关跨 region 路由并不合适,应该按 region 或地理区部署各自独立的网关。它还专门劝了一句,不要仅仅为了提高配额就去做统一网关。
这三条落到工程上都很硬。跨洲的一次额外往返,对首 token 延迟的伤害是确定的。跨 region 的出网费用会随 token 量线性增长。合规要求往往根本不给你跨境调度的选项。
状态过期这笔账最容易被漏掉。Cilium Cluster Mesh 的全局服务文档直说,远端集群不可达时,它会保留缓存里最后一次拿到的服务信息,流量因此可能被送到已经过期或走不通的后端。对应的 `clustermesh.cacheTTL` 默认是 `0s`,也就是默认不做撤销。这只是四层服务发现层面的例子。换到需要毫秒级新鲜度的 KV cache 与队列深度上,问题只会更严重。
一个反例,边界写在它自己的限制里
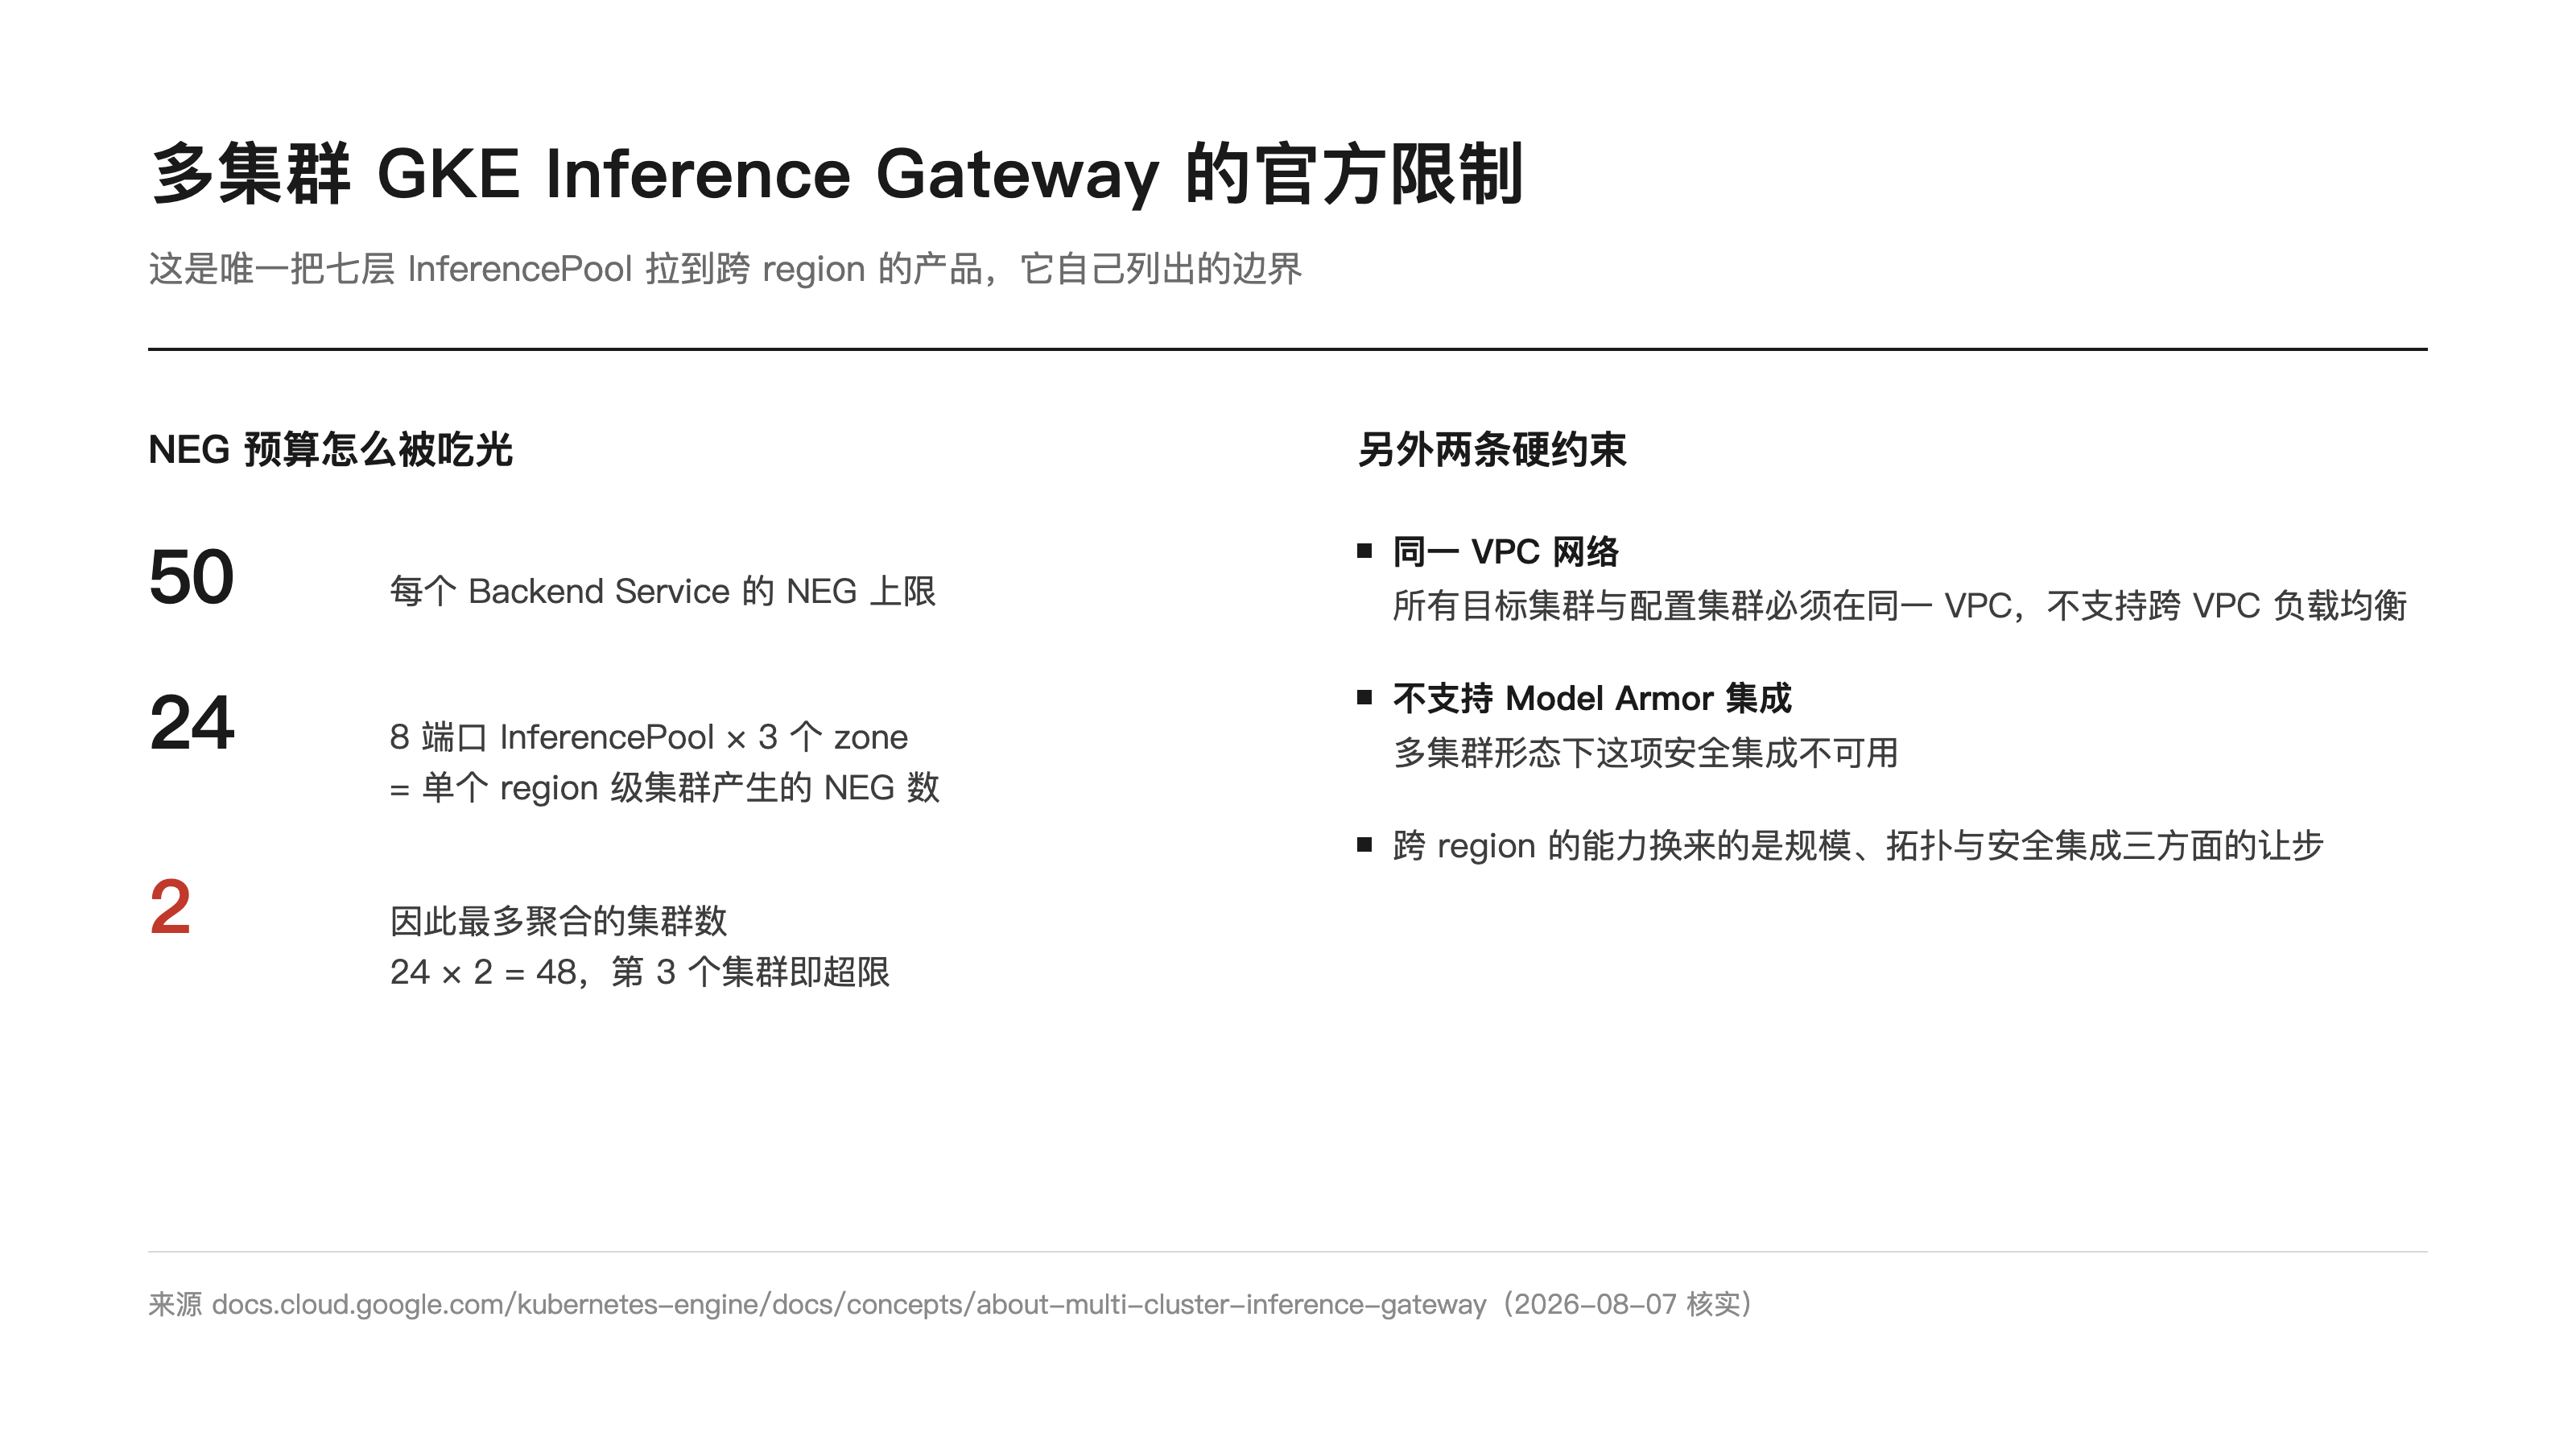
Google 的多集群 GKE Inference Gateway 确实把多集群网关和 Inference Gateway 结合起来,明确支持跨不同地理 region 的负载均衡,并在集群或 region 出问题时自动重路由,让工作负载突破单集群容量。我一开始把它当成推翻上面判断的证据,读完限制才改了主意。
每个 Backend Service 上限 50 个 NEG,而一个八端口的 `InferencePool` 在三 AZ 的 region 级集群里就产生 24 个 NEG,所以这样的池最多聚合两个集群。所有目标集群和配置集群必须在同一个 VPC 网络,不支持跨 VPC。它还不支持 Model Armor 集成。
一个能跨 region 做七层推理调度的产品,规模上限是两个集群,拓扑上限是单 VPC,能力上要放弃一部分安全集成。这比任何论证都更能说明这条路的问题。
我的判断
前端需要一个跨机房的入口,但它不应该是一个请求级的七层调度器。全球层的职责是选对 region 和集群,依据是健康、容量和就近,时间尺度可以到分钟级。请求级的负载感知调度必须留在机房内,那里的 KV cache 和队列深度信号才是新鲜的。
正在纠结多 AZ 多 region 不均的时候,卡住的多半是容量画像。一个 region 拿不到足够 GPU,或者副本数按 QPS 伸缩却没看队列深度,这类问题放到全局调度器里也解决不了,只会把不均搬到更贵的链路上。
这个判断的边界也说一下。它建立在公开文档上,我没有跑过跨 region 的推理压测。手里的材料只够说明各家目前都这样分层,不足以断言以后不会出现一种真正可用的跨 region 请求级调度。
落到动作上
先把机房内那一层做实,让 `InferencePool` 加 EPP 这类结构确实吃到 KV cache 和队列指标,再往上谈跨 region。全球层用 anycast 或 DNS 做 region 粒度导流,并把容量上限显式配出来,让超载有明确的溢出行为,别留成隐式排队。跨 region 的切换用健康探测和 outlier detection 驱动,别指望它做细粒度均衡。有数据驻留要求的话,直接按地理区切成互相独立的网关,别给全局层留下做出违规路由的机会。
上游还有一个变动值得留意。GIE 仓库已经把 EPP、`InferenceObjective` 和 BBR 迁到了 `llm-d/llm-d-router`,本仓库保留 `InferencePool` 和一个用于一致性测试的轻量 EPP。如果你在做选型,方向是 `InferencePool` 当标准接口、EPP 实现可替换,这对分层设计其实是好消息。
来源
-
Traffic management for global external Application Load Balancer(Google Cloud)
-
Use a gateway in front of multiple Azure OpenAI deployments(Microsoft)