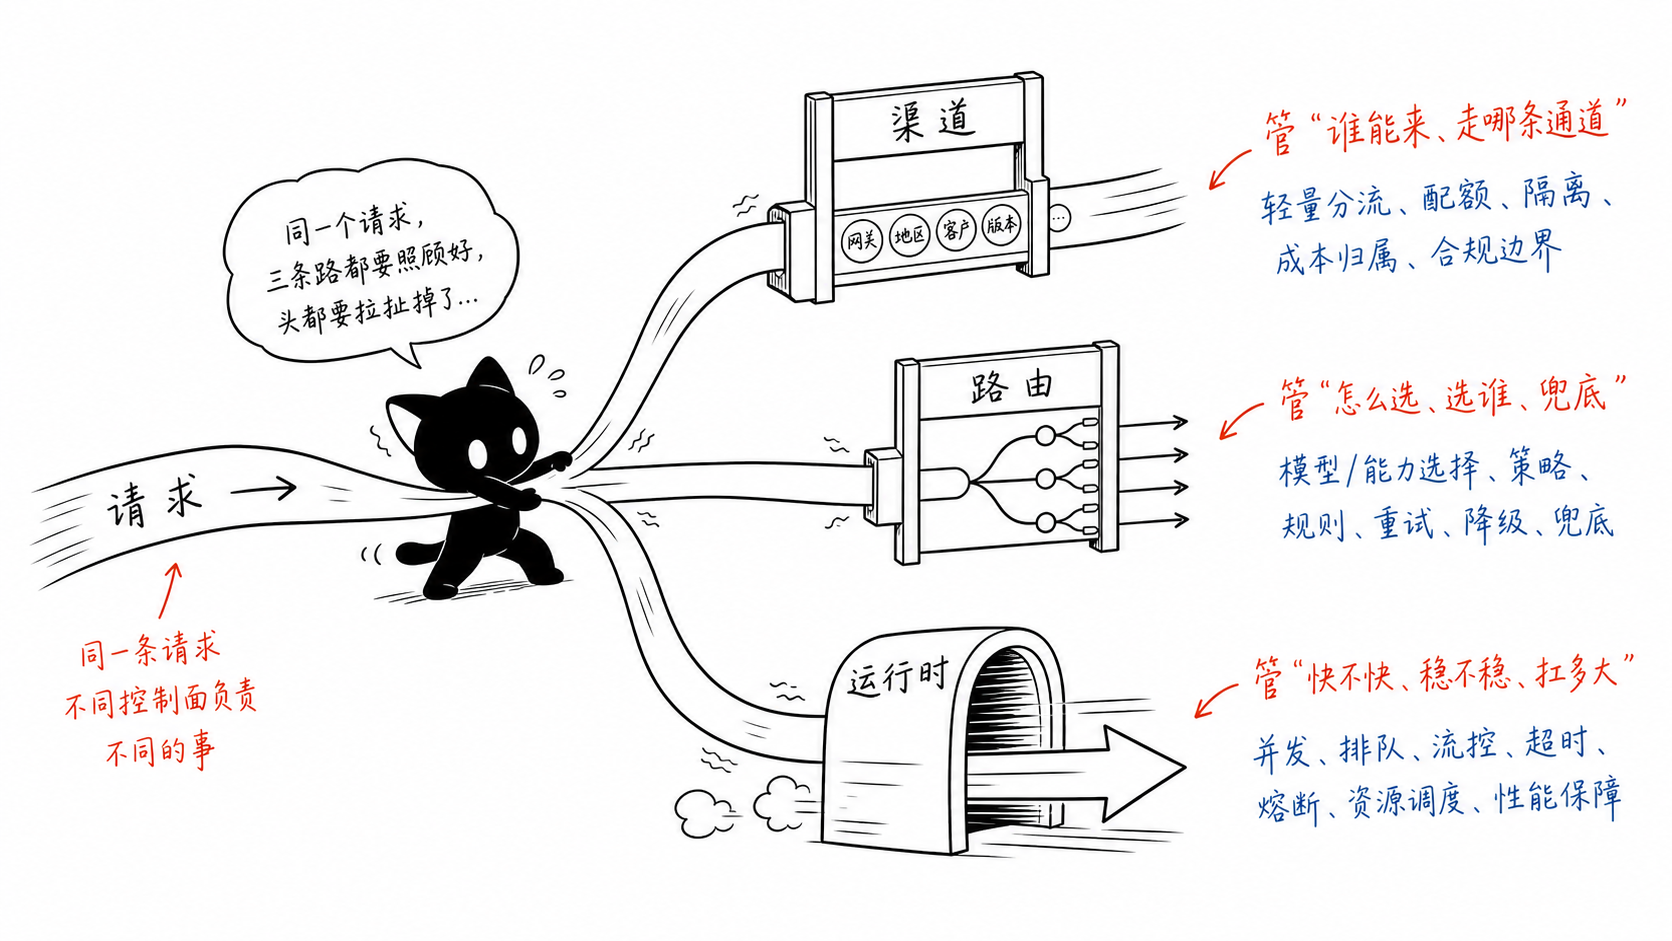
“AI 网关”这个词正在变成一个过大的筐。有人把渠道聚合、充值和用户额度放进去,有人把 Python SDK、模型路由和成本核算放进去,也有人把 Go 的低延迟转发、故障转移和 MCP 放进去。OneAPI、LiteLLM、Bifrost 恰好把这三种方向摆在了一起。
这不是一次“谁的 provider 更多”的排行榜。更有用的问题是:你的系统最需要哪一个控制面?是把上游渠道变成一个可运营的分发平台,还是让应用用统一接口调用尽可能多的模型,或者是在高并发下把网关本身的开销压到最低?
先看它们各自在解决什么
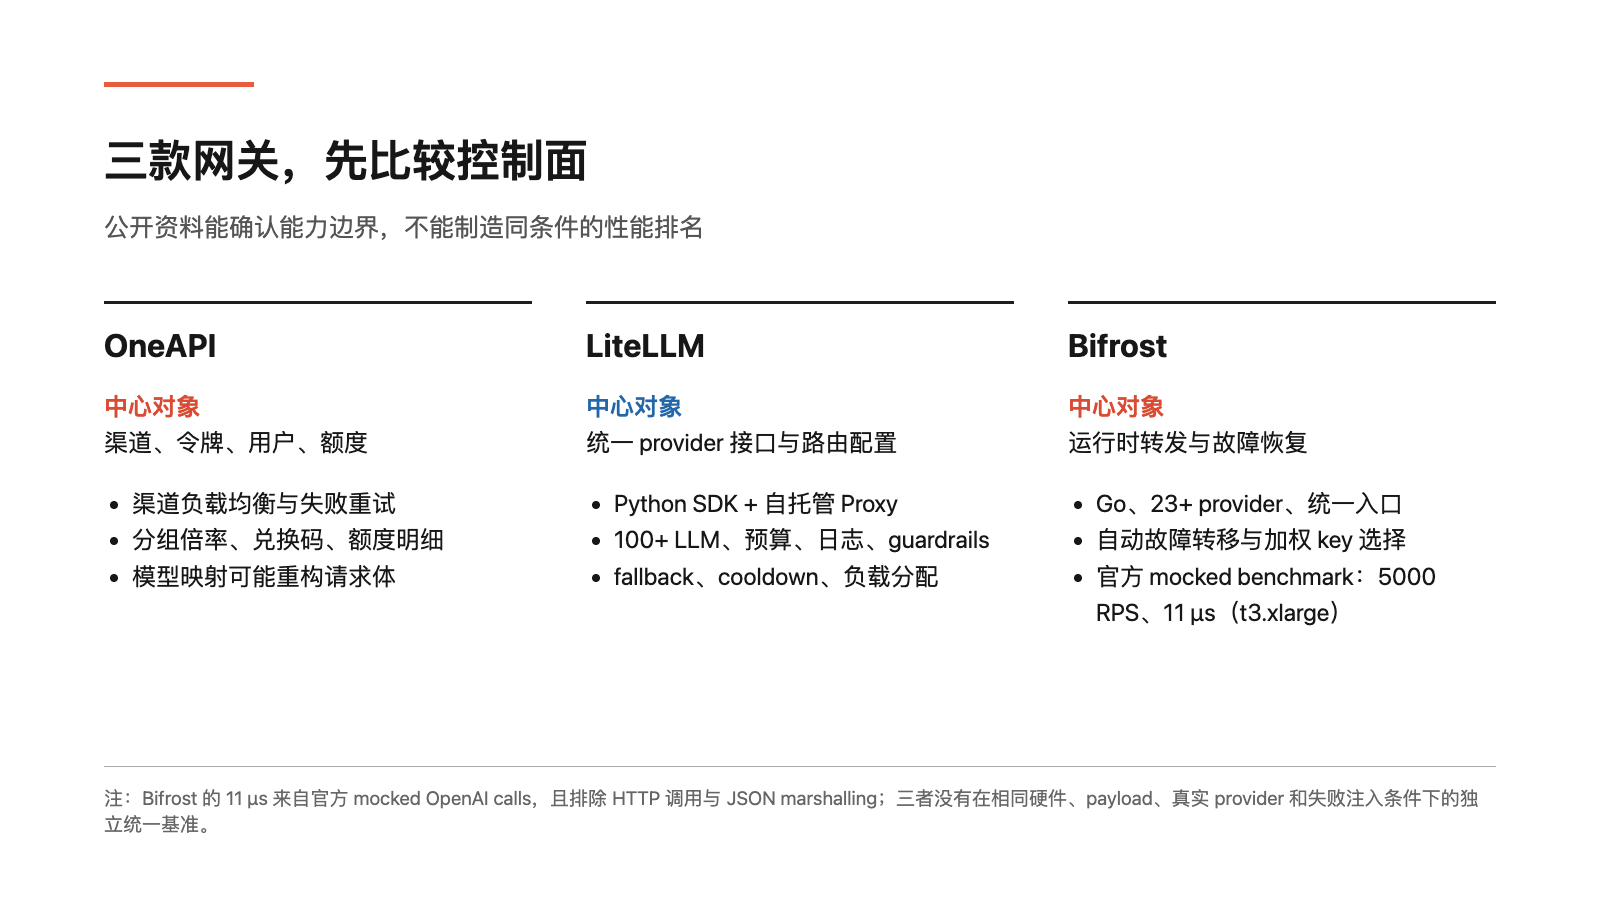
One API 官方仓库 的中心对象是渠道、令牌、用户和额度。它通过标准 OpenAI API 格式接入多种渠道,提供渠道负载均衡、模型列表、分组倍率、令牌过期和 IP 限制、兑换码、额度明细、失败重试与多机部署。它很像一个“模型渠道运营后台加中继层”:当你需要向不同用户分发 key、设置倍率、做账户结算时,OneAPI 的产品形状很直接。
代价也藏在这个形状里。官方 README 特别提醒,模型映射会重构请求体,可能让尚未正式支持的字段无法透传。也就是说,OneAPI 的兼容性不只取决于上游是否兼容 OpenAI,还取决于网关是否需要介入请求。它适合明确的渠道管理,不应被自动理解成一个完整的 LLM 运行时治理平台。
LiteLLM 的优势是边界宽。它同时提供 Python SDK 和自托管 Proxy,统一 100+ LLM provider 的调用格式;应用可以直接用 SDK,也可以把 base URL 指向 Proxy。Proxy 侧有 virtual keys、团队或用户预算、成本追踪、日志、guardrails、缓存和管理界面,Router 侧则提供多 deployment 的负载分配、重试、fallback 与 cooldown。
这让 LiteLLM 很适合“先把模型接进来,再逐步把路由和治理写成配置”的团队。它的另一个价值是应用层复用:同一套调用抽象既能放在 Python 进程内,也能移到集中式网关。但覆盖面越大,版本和 provider 差异越需要持续验证。仓库的主语言是 Python,当前描述还提到 Rust core;不能因为这句话就推断每条 Proxy 请求都拥有相同的 Rust 数据路径。部署时应锁定版本、做自己的回归和错误分类测试。
Bifrost 的设计中心更靠近运行时。它用 Go 提供统一的 OpenAI 兼容入口,官方资料称支持 23+ provider,并把自动故障转移、负载均衡、语义缓存、虚拟 key、Prometheus/Tracing 与 MCP 放在同一产品里。它还有 Go SDK,因此既可以作为独立 HTTP 网关,也可以被 Go 应用直接嵌入。
三种路由,不是同一种“智能”
三者都能说“支持路由”,但路由发生的位置不同。OneAPI 主要围绕渠道可用性、渠道分组和额度倍率做分发;LiteLLM 把 model group、deployment、retry 和 fallback 暴露为较细的配置对象;Bifrost 更强调 provider、key 和模型的运行时选择,以及失败后的替代路径。
这一区别决定了故障转移能否安全。429、超时和 5xx 可以重试,不代表所有错误都应该重试;流式输出已经开始后,再切换 provider 也可能造成重复内容;不同模型之间的工具调用、JSON schema、上下文长度和质量并不等价。LiteLLM 文档给出了失败阈值、cooldown 和 fallback 配置,Bifrost 文档则把 provider 级并发、队列和加权 key 选择作为调优点。产品有这些开关,不等于系统已经替你完成了幂等、预算和质量策略。
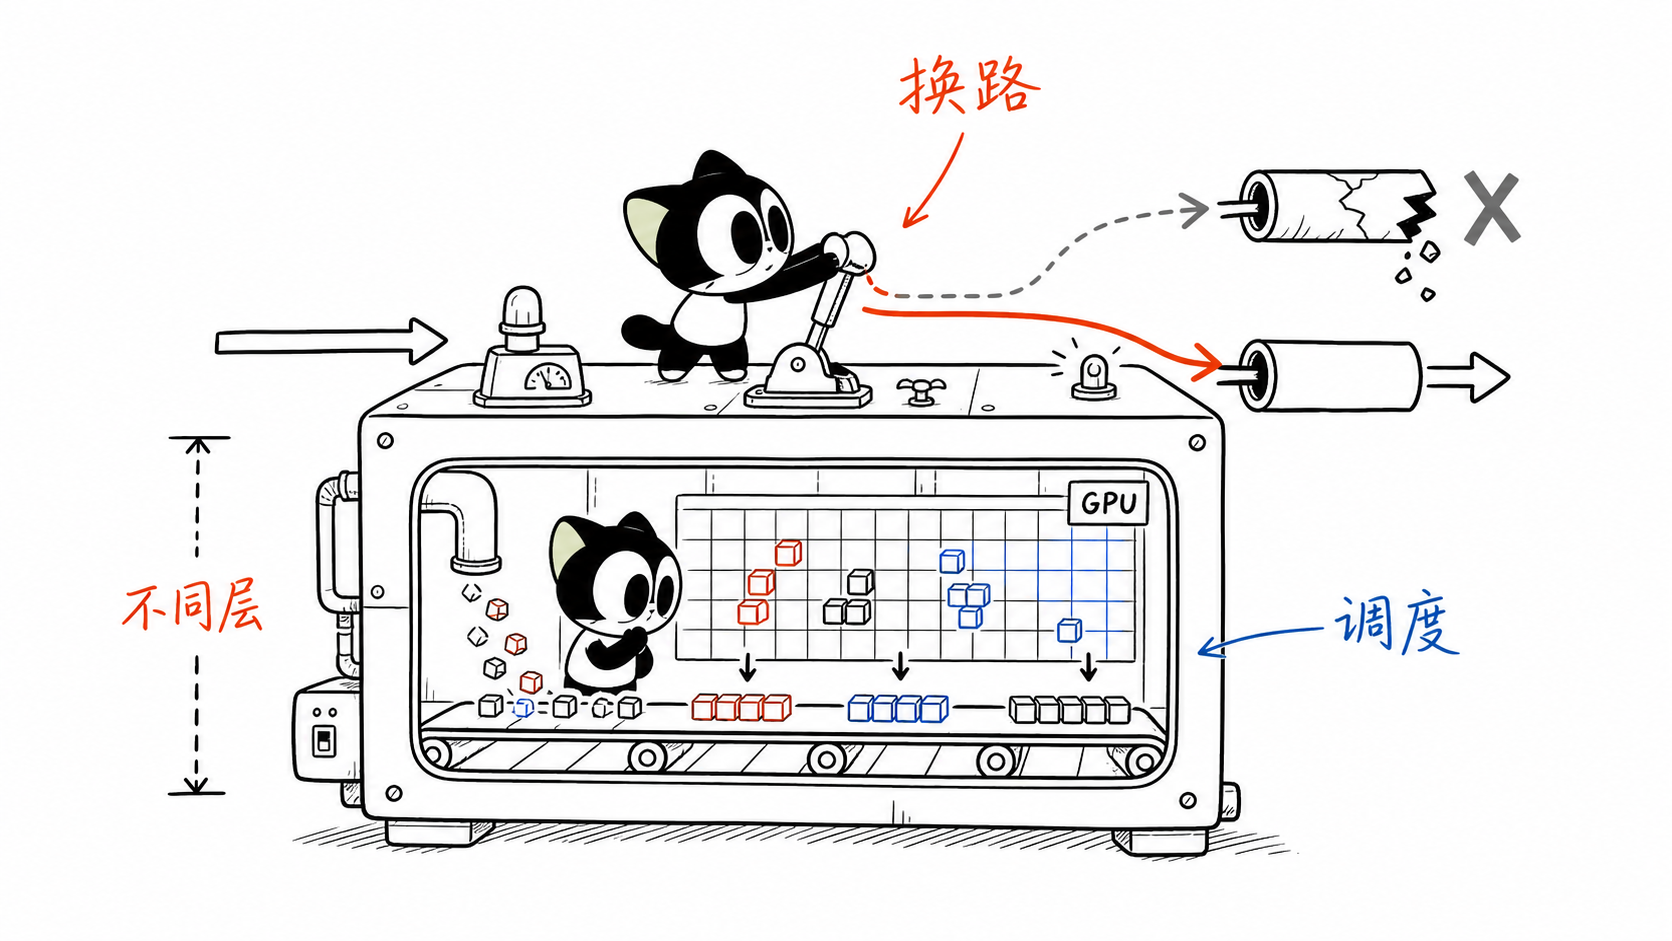
还要划清一个容易混淆的边界:AI 网关通常负责入口认证、协议转换、模型选择、成本和审计;它不是 vLLM。后者通过 PagedAttention、continuous batching、prefix cache 等机制提高推理服务的 GPU 利用率。Kubernetes 的 Inference Gateway 则把模型路由、优先级和调度扩展到 Gateway API。把 Bifrost 的 provider fallback 和 vLLM 的 KV cache 调度称为同一类“AI 路由”,会导致架构决策失真。
性能数字应该怎样读
Bifrost 官方基准在 AWS t3.medium 和 t3.xlarge 上以 5000 RPS 测试 mocked OpenAI calls,报告网关开销分别为 59 µs 和 11 µs,成功率为 100%。文档还说明,11 µs 排除了 HTTP 调用和 JSON marshalling。这个结果有价值:它证明 Go 数据路径可以把代理自身的开销做得很低。但它不是用户请求的端到端 TTFT,也不能覆盖真实 provider 限流、跨地域网络、长上下文、流式响应和失败重试。
LiteLLM 官方文档也给出过 1k RPS 下 8 ms P95 的网关基准。两组数字不能直接相减,因为硬件、payload、并发模型、版本和是否包含回调都不同。OneAPI 没有在官方 README 中给出可对齐的同类数字,因此不能为了完成排行榜而给它填一个推测值。
我的判断是:只有当网关处理时间已经接近你的业务 SLO,或一个请求链中存在大量连续模型调用时,代理微秒级差异才值得成为首要指标。大多数在线生成请求的主要变量仍是 provider 排队、首 token 时间、输出长度、重试和网络。先用真实流量测 p50/p95/p99、首 token、错误率、token 成本和 fallback 后质量,再谈“最快”。
各家厂商在开源 AI 网关里选了哪条路
三款独立 LLM Proxy 之外,传统网关厂商并没有集体重写数据面,而是在既有技术栈上选择不同的 AI 扩展方式。
阿里发起的 Higress 延续 Envoy 与 Istio 路线,用 Wasm 插件处理 AI 流量、SSE 和安全策略,并同时对接 Ingress API 与 Gateway API。它更适合已经运营 Istio/Envoy、希望 API 与 AI 流量共用网关的团队;选它的理由应是技术栈一致和插件热更新,而不是另起一套 LLM Proxy。
Apache APISIX 代表 NGINX/OpenResty 插件路线。`ai-proxy` 与 `ai-proxy-multi` 把 provider 转换、流式调用、fallback 控制和 LLM 日志变量放进通用 API Gateway。API7 另有 AI-native 项目,但 APISIX 本身由 Apache 软件基金会治理。对已经用 APISIX 管理普通 API 的团队,优先扩展原网关通常比再串联一个代理更容易统一认证、限流和观测。
Kong Gateway 也选择在成熟 API Gateway 上增加 AI Proxy 和相关插件。它的优势是现有 Kong 路由、认证和插件体系可以继续使用;风险是开源仓库、Kong Enterprise 与 Konnect 的能力边界会随版本变化,尤其 MCP 聚合、高级分析和治理功能不能只看产品总览,必须按目标版本逐项核对许可证与部署形态。
Envoy AI Gateway 更像云原生平台组件。官方采用两层模式:第一层负责统一认证、顶层路由和全局限流,第二层进入自托管模型集群,并通过 endpoint picker 做推理感知选择。它适合已经标准化 Kubernetes Gateway API、需要把外部 provider 与内部模型池放进同一流量模型的平台团队。
Solo.io 发起、现托管于 Linux Foundation 的 agentgateway 则把边界推到 Agent。它以同一 HTTP/gRPC 数据面承载普通 API、LLM inference、MCP tool server 和 A2A,并强调协议感知路由、授权、可观测性与多租户。若主要问题已经从“调用哪个模型”变成“哪个 agent 可以调用哪个工具”,它比只做模型协议转换的网关更对题。
这五条路线没有统一冠军:已有 API Gateway 的团队应先评估原栈扩展;Kubernetes/Envoy 平台看 Envoy AI Gateway 或 Higress;MCP/A2A 治理看 agentgateway;只有当 provider 覆盖、模型成本或低开销转发本身是主矛盾时,才回到 LiteLLM、OneAPI、Bifrost 这类独立网关。
技术判断:按控制面选,而不是按星数选
如果你的首要任务是渠道聚合、用户分发、倍率计费和一个能快速上线的运营后台,OneAPI 是最贴近问题的选择。但它应该被当作需要严格版本审查的业务系统:默认密码、权限边界、出网控制、日志脱敏、密钥轮换和安全响应都要纳入上线清单。仓库 API 显示其最近一次代码 pushed_at 为 2026-01-09;这不是漏洞结论,却足以说明不能只看 stars 和 README。
如果你需要大量 provider、Python 生态、应用内 SDK 与集中式 Proxy 之间的迁移自由,LiteLLM 更合适。它的强项不是单一转发路径的极限,而是兼容面、配置表达力和生态连接。代价是升级频率、provider 行为差异和配置复杂度。把它当作平台组件时,应固定版本,建立 provider contract tests,并明确哪些 guardrail、审计和 SSO 能力属于当前部署或商业版本。
如果你的主要约束是高并发、多 key、多 provider 故障切换,且团队愿意运营 Go 服务,Bifrost 值得优先做压测。它的官方 benchmark 说明了数据路径潜力,Apache-2.0 也便于自托管和二次集成。但 MCP、语义缓存、guardrails 和企业治理越多,越不能只测空转发;应把工具权限、缓存命中后的数据边界和租户隔离一起压测。
最终可以把选择压缩成三句话:OneAPI 先解决“谁能用、用哪个渠道、怎么算钱”;LiteLLM 先解决“应用如何用统一接口接入最多模型”;Bifrost 先解决“请求如何以低开销、可恢复的方式穿过网关”。如果你的团队同时需要这三件事,组合架构可能比寻找一个满分产品更诚实:网关负责转发,身份与治理负责约束,推理引擎负责 GPU 调度,观测系统负责证明它们真的按预期工作。