假设 AI Gateway 已经负责认证、租户配额、模型目录、审计和成本,后面只接自建推理集群。接下来的问题不是再选一个“AI 网关”,而是:谁来决定请求进入哪个 Region、哪个集群、哪个 Pod,以及 prefill 和 decode 落在哪里。
这四个决定不能塞进一个 round-robin。LLM 副本是有状态的:队列长度不同,KV cache 内容不同,LoRA 装载不同,请求成本也可能相差几个数量级。
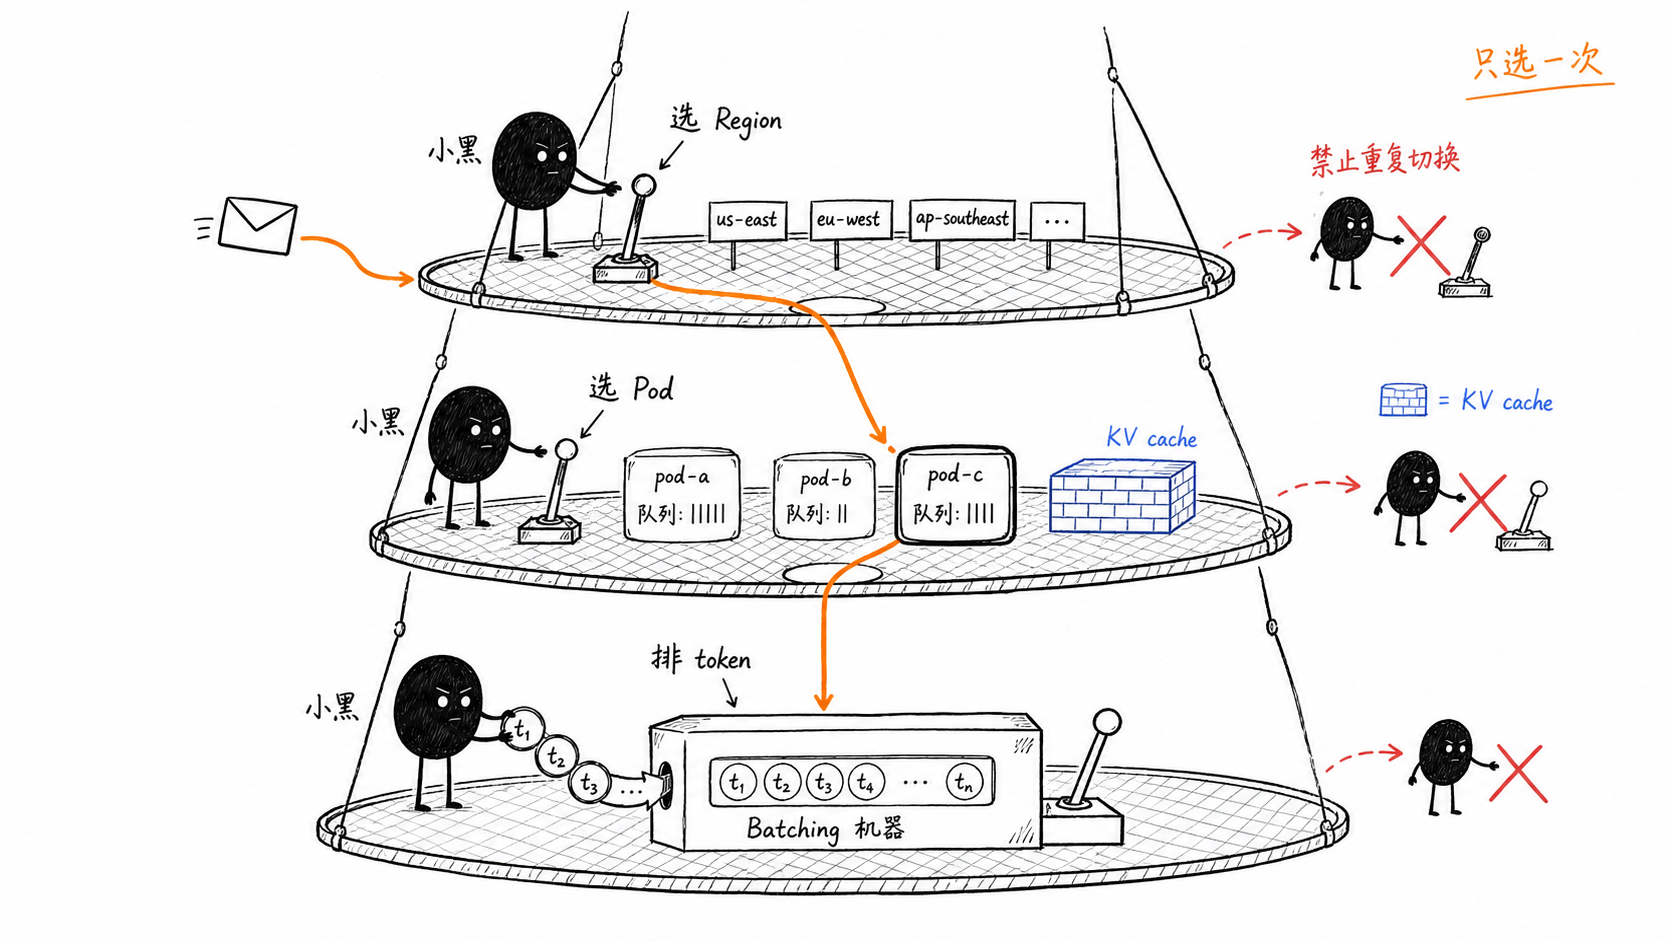
先把路由拆成三个作用域
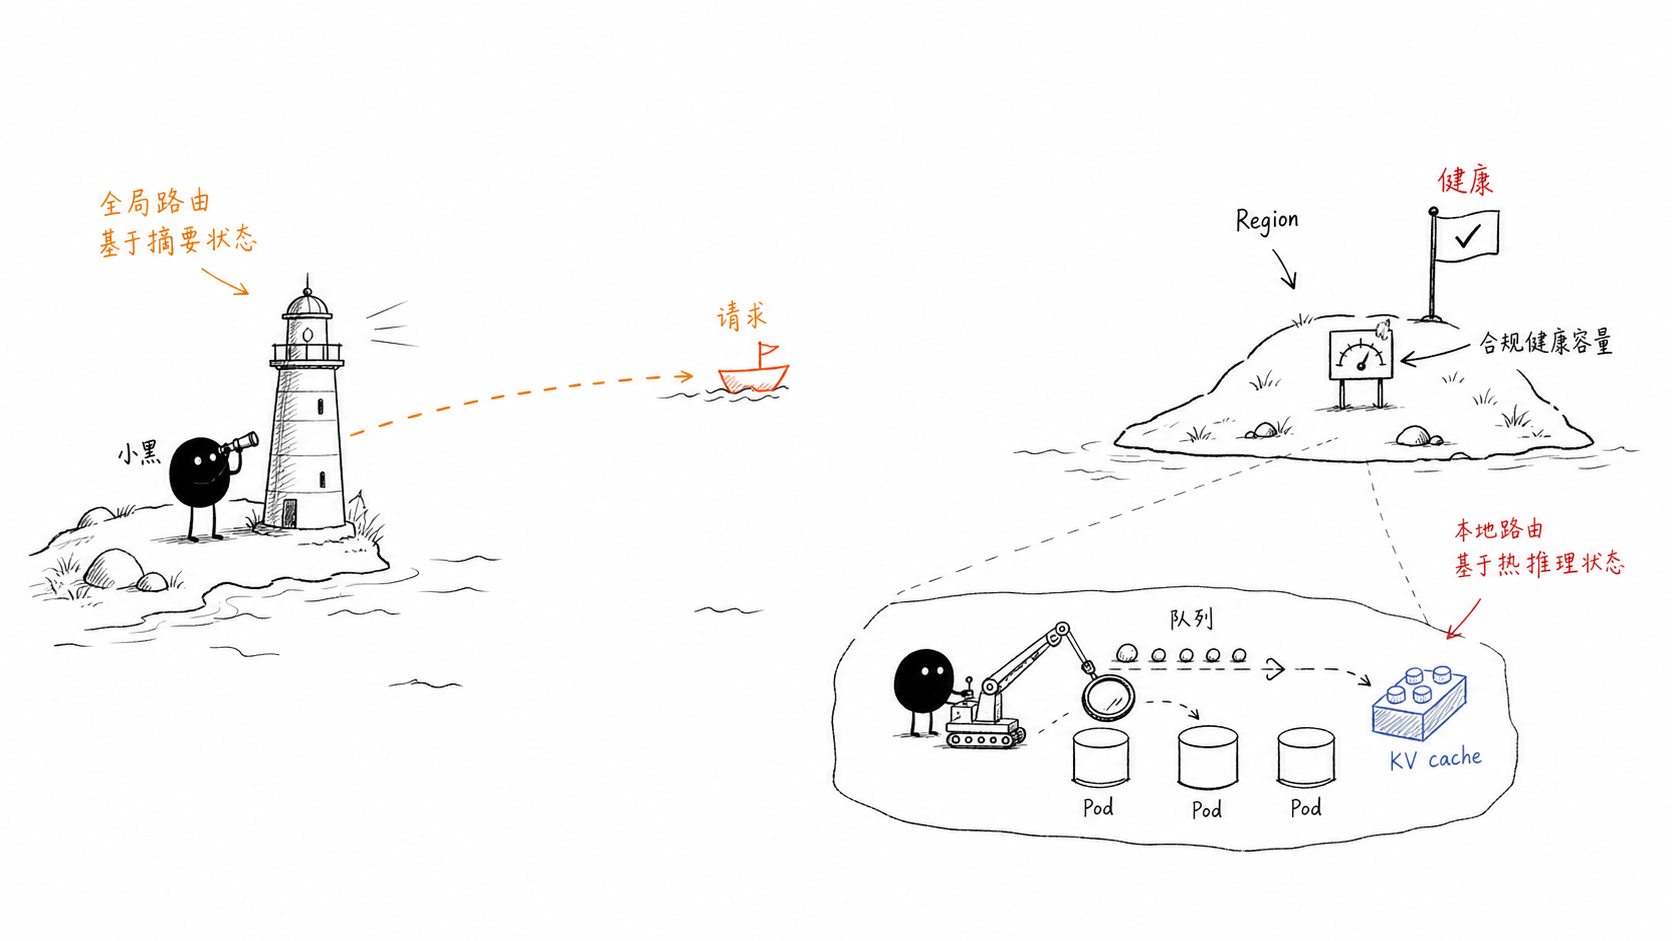
Global/Region Director 只选 Region 或机房。输入是数据合规、用户距离、Region 健康、模型可用性、剩余容量和成本。它不应该理解每个 Pod 的 KV cache,因为跨 WAN 同步这种热状态既慢又容易过期。
Cluster Inference Gateway 在一个低延迟网络域内选模型池和 Pod。它需要看到 active requests、预计 prefill tokens、KV prefix 命中、LoRA 可用性和 Pod 健康。Kubernetes Gateway API Inference Extension 用 InferencePool 加 Endpoint Picker/EPP 标准化了这个位置。
Engine Scheduler 在实例内部做 continuous batching、抢占和 token 调度;PD 分离时还要协调 prefill 与 decode worker。它属于 vLLM、SGLang、TensorRT-LLM 或 Dynamo 内部,不应由前置 NGINX 模拟。
可选方案横评:先按主栈筛选
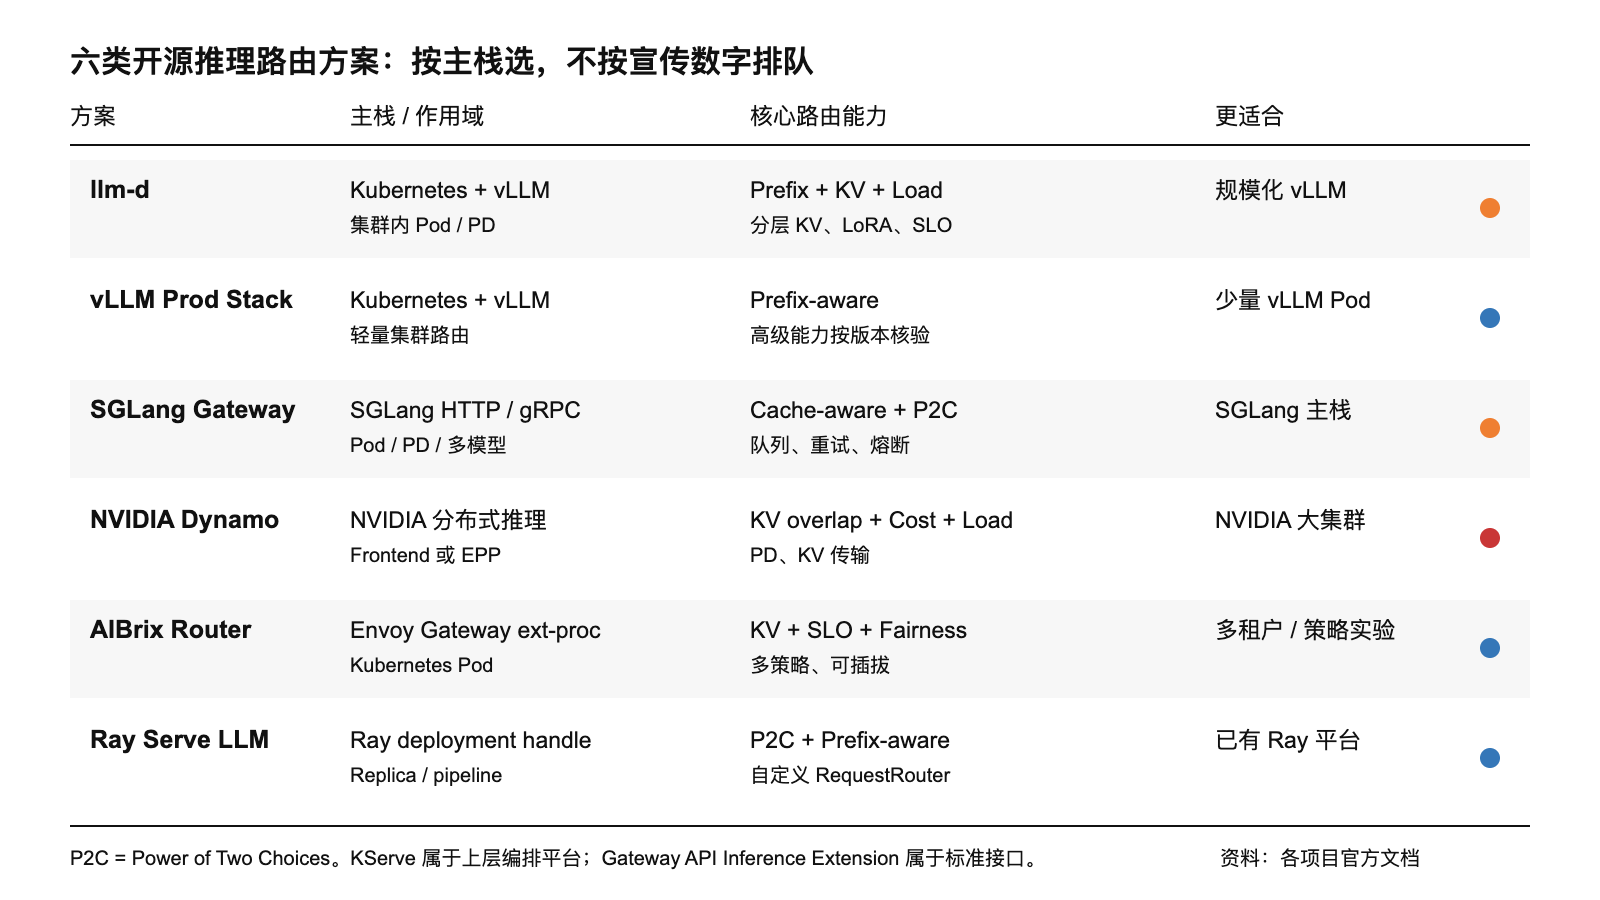
llm-d:Kubernetes + vLLM 的完整生产路径。 它把 Gateway API Inference Extension、vLLM 遥测、prefix/KV-cache-aware 与 load-aware scoring 组合起来,并继续覆盖 PD 分离、分层 KV、LoRA 路由、HA 和 SLO-aware autoscaling。优势是推理状态看得深、Kubernetes 集成完整;代价是组件多、调优面大。适合多 Pod、多节点、大规模 vLLM 集群,也是本文的通用首选。
vLLM Production Stack Router:轻量 vLLM-only 方案。 官方文档已有 prefix-aware 路由,能把共享 prompt 前缀送回相同实例。它更容易从“几个 vLLM Pod”起步,但路线图中的更高级 KV-aware、排队和 PD 能力必须按具体版本核验。适合规模不大、团队希望少引入一套平台的场景。
SGLang Model Gateway:SGLang 主栈的性能型选择。 Rust Router 支持 `cache_aware`、`power_of_two`、round-robin、按模型策略和 PD 分离,还覆盖 HTTP/gRPC、队列、重试与 worker circuit breaker。优势是与 SGLang runtime 贴合、数据路径短;若后端混用多种 engine,耦合会比标准 EPP 更明显。
NVIDIA Dynamo:NVIDIA 大集群与 PD 分离优先。 Dynamo 同时提供 Frontend-owned KV routing 和 Gateway API EPP 两种拓扑,KV Router 会综合缓存重叠、prefill 成本与 active load。官方明确要求二选一:EPP 已选 worker 时,Frontend 必须 `direct`,不能再选一次。它适合 NVIDIA GPU 集群、KV 传输和 disaggregated serving,但平台复杂度最高。
AIBrix:策略丰富的 Kubernetes 路由实验场。 它以 Envoy Gateway ext-proc 扩展工作,内置 least-request、least-busy-time、prefix-cache、Preble、VTC 公平性、SLO-aware、session affinity 和 PD 策略。优势是策略面广、可插拔;风险是策略越多越需要稳定的指标语义和版本验证。适合多租户平台或需要研究公平/SLO 调度的团队。
Ray Serve LLM:已有 Ray 平台时最顺手。 它明确区分 model ingress 与 replica routing,默认使用 Power of Two Choices,并提供 prefix-aware 和自定义 RequestRouter。它擅长模型编排、Python pipeline 和 autoscaling;如果目标只是给独立 vLLM Pod 加一个标准 Kubernetes EPP,Ray 的系统边界会偏重。
KServe 更适合作为上层编排平台:管理 InferenceService、runtime、扩缩容和发布,再组合 Envoy AI Gateway 与 Inference Extension。它不是第七种 Pod scoring 算法。
跨 Pod、机房和 Region,要不要再加 NGINX?
跨 Pod:通常不需要额外 NGINX 做第二次负载均衡。 让 AI Gateway 把请求交给一个 Cluster Inference Gateway;后者通过 Envoy Gateway/EPP、llm-d、SGLang Router 或 Dynamo Frontend 直接选 Pod。若 Kubernetes Service 或 NGINX 又做一次 round-robin,EPP 的 KV cache 选择会被覆盖。
跨机房或跨 Region:需要全局入口,但职责只是选 Region。 可以是 DNS/GSLB、Anycast、云全局负载均衡,也可以是 Envoy/NGINX Plus 一类具备主动健康检查和熔断的 L7。普通开源 NGINX 能转发流式 HTTP,但动态容量、优先级和健康状态需要额外控制面;不要为了“统一”让它维护全球 Pod 列表。
每个 Region 内独立部署推理网关、EPP、模型池和指标系统。Region 之间只同步模型版本、容量摘要和健康状态,不同步逐 Pod 队列,也不要默认跨 Region 追逐 KV cache。跨 WAN 的 cache 搬运只有在专线、超长前缀和明确收益模型下才值得验证。
调度算法:不是单选,而是过滤加打分
先做硬过滤:模型与版本匹配、LoRA 已装载、Region 合规、Pod 健康、显存水位可接受、并发未超上限。过滤后再打分:
`score = cache_gain - predicted_queue_delay - prefill_cost - overload_penalty`
共享长前缀、多轮对话多时,提高 `cache_gain`;请求差异大、cache 命中低时,退化到 Power of Two Choices + active requests/estimated tokens,通常比全量轮询更稳且协调成本低。长短请求混合时,不能只看请求数,应估算 input tokens、output tokens 或 predicted latency。多租户场景再叠加 VTC/DRF 类公平约束,防止长请求用户占满 decode 资源。
Region 层使用另一套算法:先过滤合规与模型可用性,再按延迟、可用容量、错误率和成本做加权选择,并加入迟滞和熔断,避免流量在 Region 间来回震荡。健康 Region 内尽量保持 locality;只有容量不足或故障时才溢出到次选 Region。
一条可落地的请求链路
用户请求先到全局入口。全局入口根据租户允许的数据地域、目标模型在各 Region 的部署状态、最近一段时间的错误率和容量水位,选择一个 Region。这里可以复用现有云全局负载均衡或企业统一的 L7 入口,不需要解析完整 prompt,也不需要知道某个 Pod 的缓存内容。为了防止抖动,同一会话可以在短时间内保持 Region 亲和,但故障时必须允许切换。
进入 Region 后,请求到达 AI Gateway,完成身份、配额、内容策略和模型名称映射。随后它把确定的模型与必要元数据交给 Cluster Inference Gateway。若使用 Gateway API Inference Extension,Gateway 根据 HTTPRoute 找到 InferencePool,再调用 EPP;EPP 过滤不合格端点、读取缓存或预测状态、计算分数并返回一个 Pod,Gateway 必须直接把请求送到该 Pod。中间的 Service 应使用直达端点或已选目标,不能再做随机分发。
Pod 内部的 engine scheduler 接手后,才决定请求何时进入 batch、是否抢占、每轮 decode 分配多少 token。PD 分离时,Cluster Inference Gateway 或框架专用 Router 还要先选 prefill worker,再选择或绑定 decode worker,并处理 KV 的传输。这个阶段依赖高速集群网络,不应跨 Region 延伸。
算法如何调,先看工作负载
如果大量请求共享长 system prompt、工具定义或多轮历史,缓存收益应占更高权重;但必须设置负载保护阈值,一旦候选 Pod 的预计排队时间显著更长,就放弃 cache affinity。反过来,prompt 高度离散时,维护精确 KV 索引的收益可能低于开销,此时 Power of Two Choices 配合 active requests、waiting tokens 或 predicted latency 更合适。
只用 least-request 也不够:一个八千 token 的 prefill 和一个几十 token 的续写不能计为同一个请求。至少要按输入长度估计 prefill 工作量,再结合当前 decode 序列数估算等待时间。对延迟敏感与批处理任务混跑时,应先按优先级或独立池隔离,而不是在一个分数公式里不断加补丁。
所有智能路由都要有明确降级顺序:精确 KV 状态不可用时退到预测缓存,指标过期时退到 P2C,EPP 超时或无健康端点时快速失败或切备用池。不要悄悄回到 Kubernetes Service 的 round-robin,否则系统看似可用,尾延迟和缓存命中却会在故障时同时恶化。
我的选型建议
-
vLLM + Kubernetes、准备规模化:优先 `llm-d + Gateway API Inference Extension`。
-
少量 vLLM Pod、先解决 prefix locality:从 vLLM Production Stack Router 起步。
-
SGLang 为唯一主引擎:选 SGLang Model Gateway。
-
NVIDIA 大集群、PD/KV 传输是核心:选 Dynamo,并坚持 Frontend 或 EPP 单点选址。
-
需要公平性、SLO 和大量策略实验:评估 AIBrix。
-
已经以 Ray 管理模型和应用 pipeline:使用 Ray Serve LLM 原生 replica routing。
最终拓扑应是“全局层选 Region,集群层选 Pod,引擎层排 token”。可以增加 L7,但不能增加第二个不理解推理状态的 Pod 选择器。真正需要压测的不是谁的 QPS 宣传数字,而是你的 prompt 重复率、队列分布、故障回退和跨域溢出是否符合 SLO。
资料来源