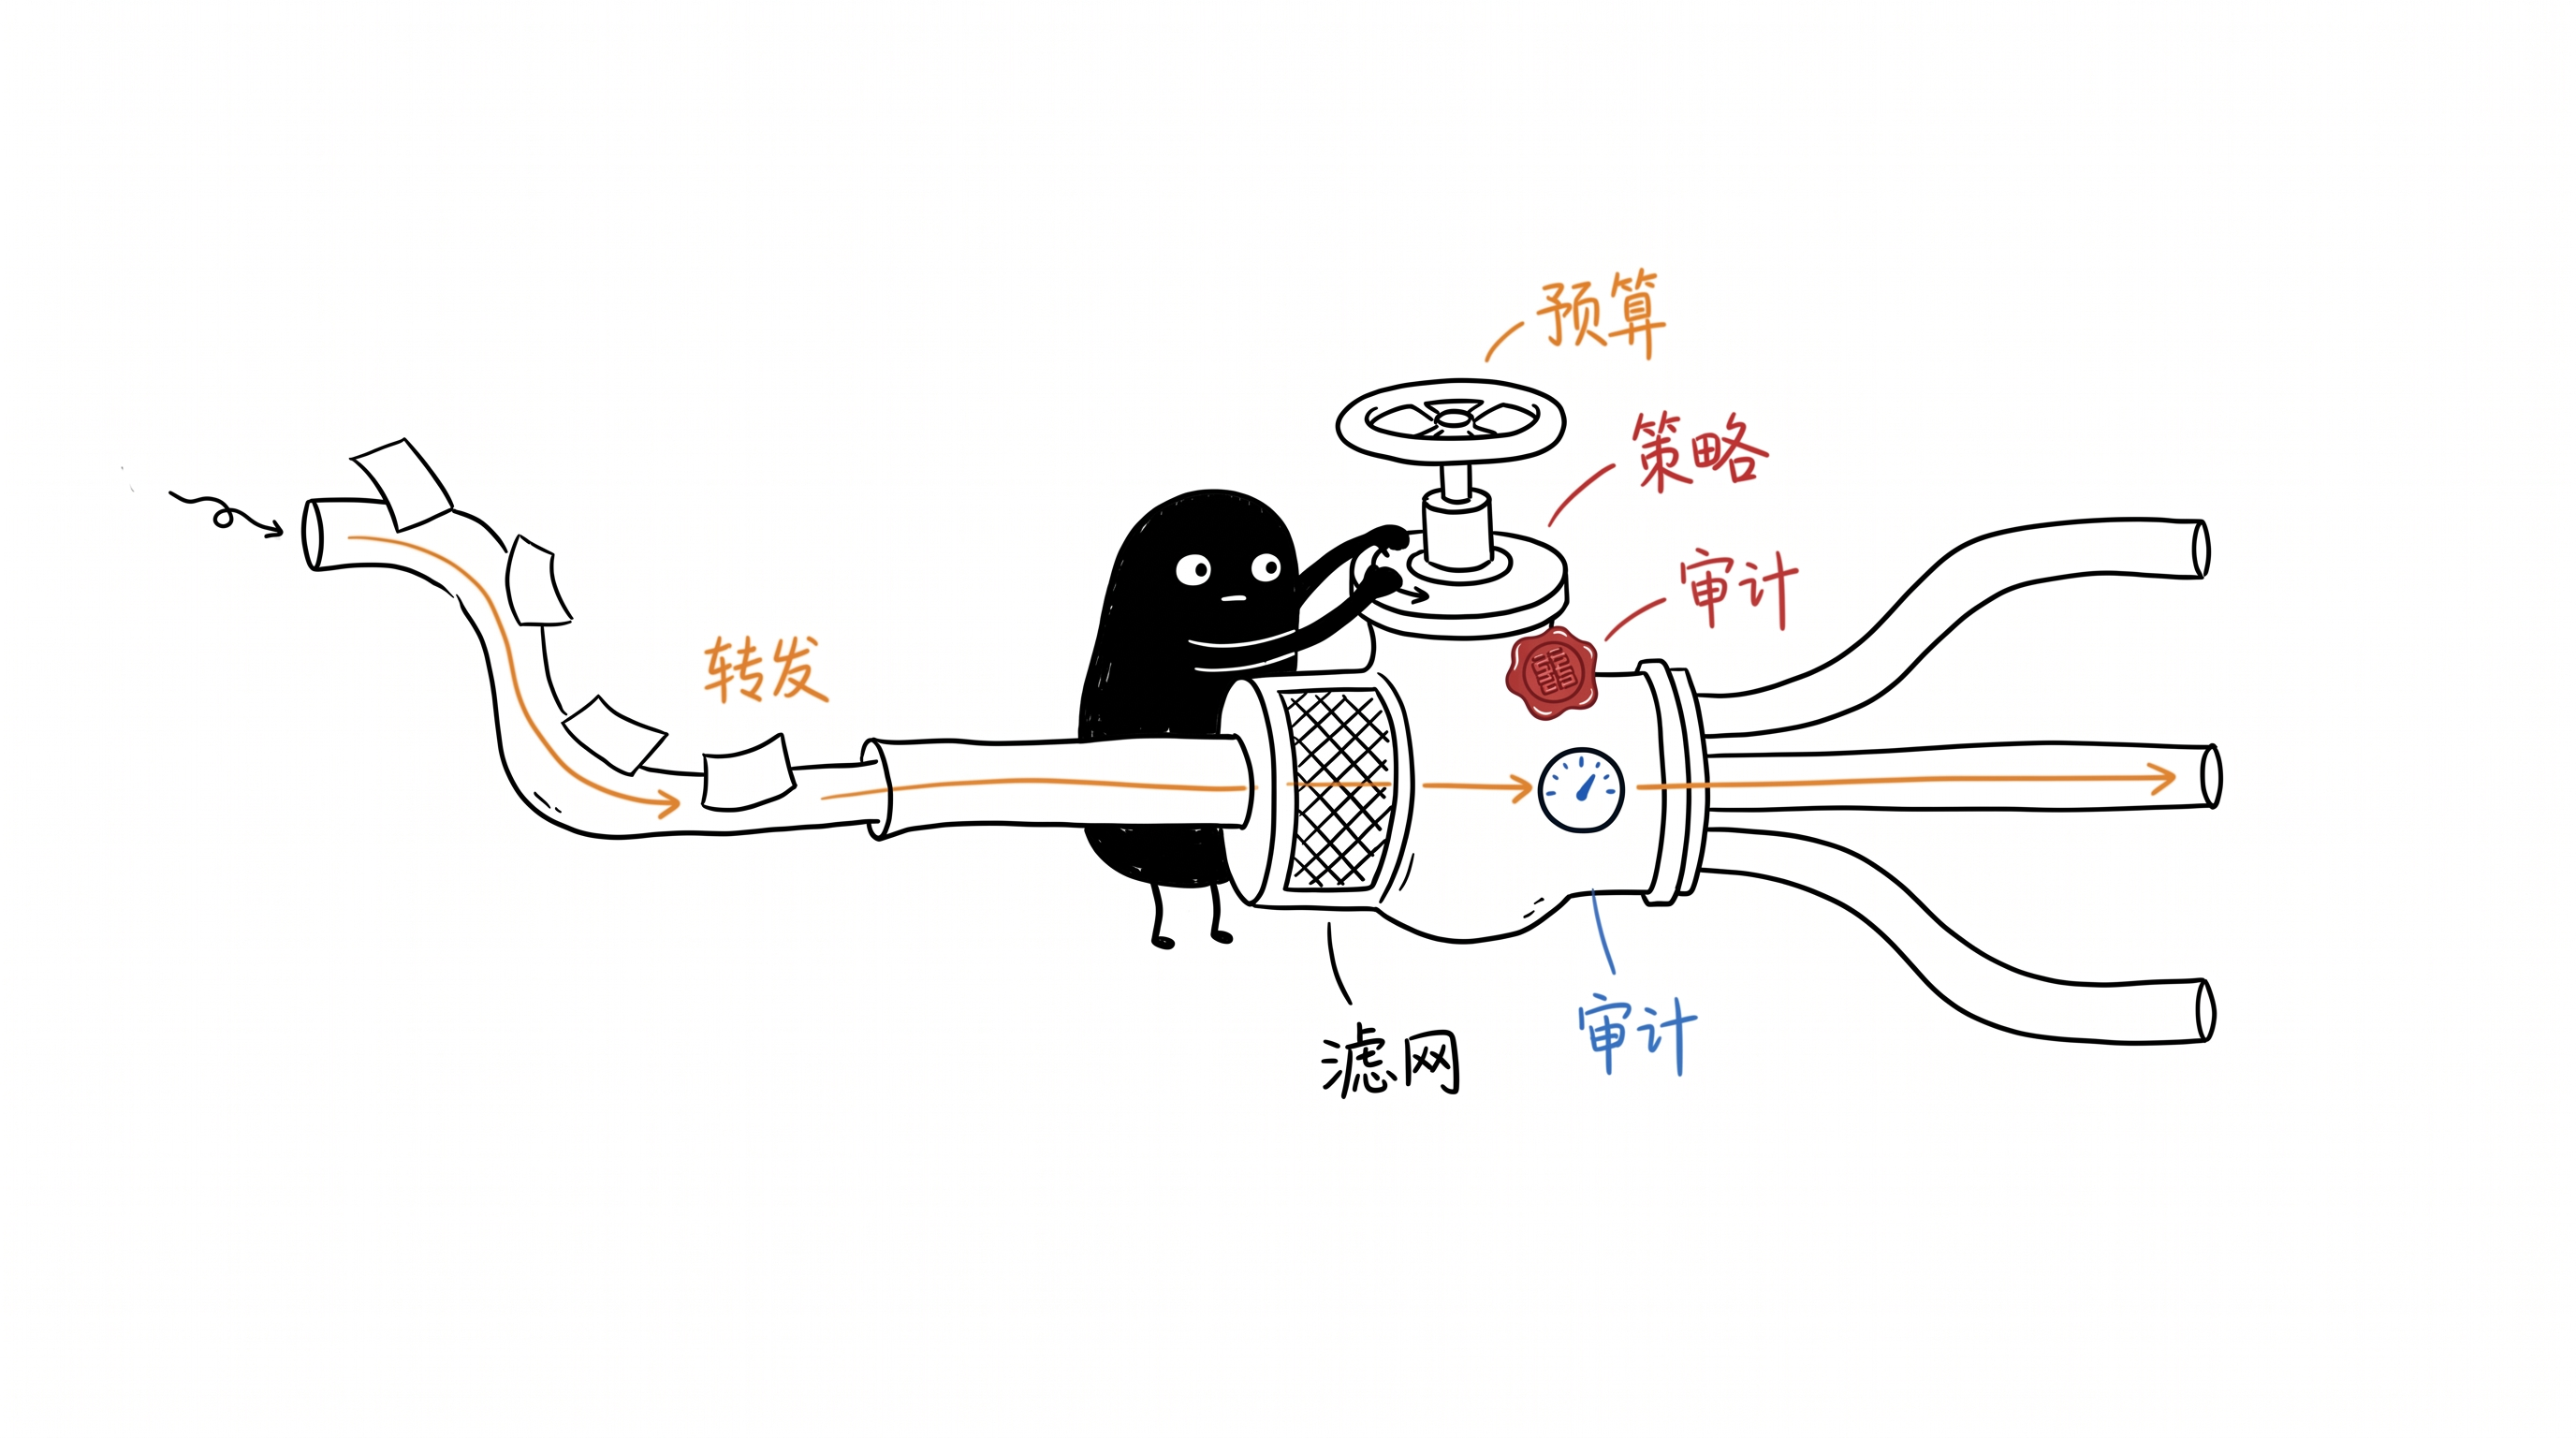
如果 AI 网关只做一件事:把 OpenAI 格式请求改写后转给另一个模型,那么它很容易被 SDK、反向代理或几十行路由代码替代。企业真正难替代的,不是“能转发”,而是每一次模型调用都能回答四个问题:谁在用、花了多少、数据去了哪里、出了问题能否追责。
两个同日更新,暴露了同一件事
北京时间 7 月 25 日,LiteLLM 发布开发版本 `v1.95.0-dev.2`。这份 release 的重点不是又多接了一个模型,而是一串很“企业”的改动:Docker 镜像可用 cosign 验签;Guardrails 可只扫描会话新增消息;预算扣减支持 fail-closed;成本页增加按工具归因和缓存泄漏视图;缓存写入 token 被纳入计费;同时修复 SSO、SCIM、fallback 和 MCP OAuth 行为。
同日,SGLang `v0.5.16` 继续改动缓存、调度、量化和运行时:`UnifiedRadixTree` 成为更多模型的默认缓存结构,引入 FlexKV 连接器和单请求输出 token 上限,同时删除若干实验后端,并明确保留了尚未解决的调度问题。
前者说明网关的工作面正在扩大,后者说明它背后的推理层仍在快速变化。企业需要的因此不是一个写死上游地址的“中转站”,而是一个在后端持续变化时仍能保持身份、预算、策略和审计契约稳定的基础设施层。需要强调:LiteLLM 这次是 dev release,适合观察方向,不等于生产升级建议。
从转发到控制,一次请求多了四道责任
传统 API 网关主要看路径、方法、身份、QPS 和上游健康。AI 请求还携带 prompt、上下文、模型、token 预算、工具权限和数据地域要求;响应又可能流式持续数分钟,产生 reasoning token、缓存费用或外部工具副作用。
所以生产级 AI 网关至少要闭合四个回路。
-
接入契约:把不同厂商协议、凭据和模型名收敛成应用可依赖的稳定接口。
-
成本控制:在调用前做 token 配额和模型选择,在调用中处理超时、重试与 fallback,在调用后按团队、应用、Agent 和工具归因。
-
合规执行:在数据离开边界前完成身份、模型白名单、地域、敏感信息和工具权限判断,而不是只在事后留一份日志。
-
运行证据:记录请求量、token、首 token 延迟、错误、策略命中和配置版本,让事故能复盘、策略能回滚。
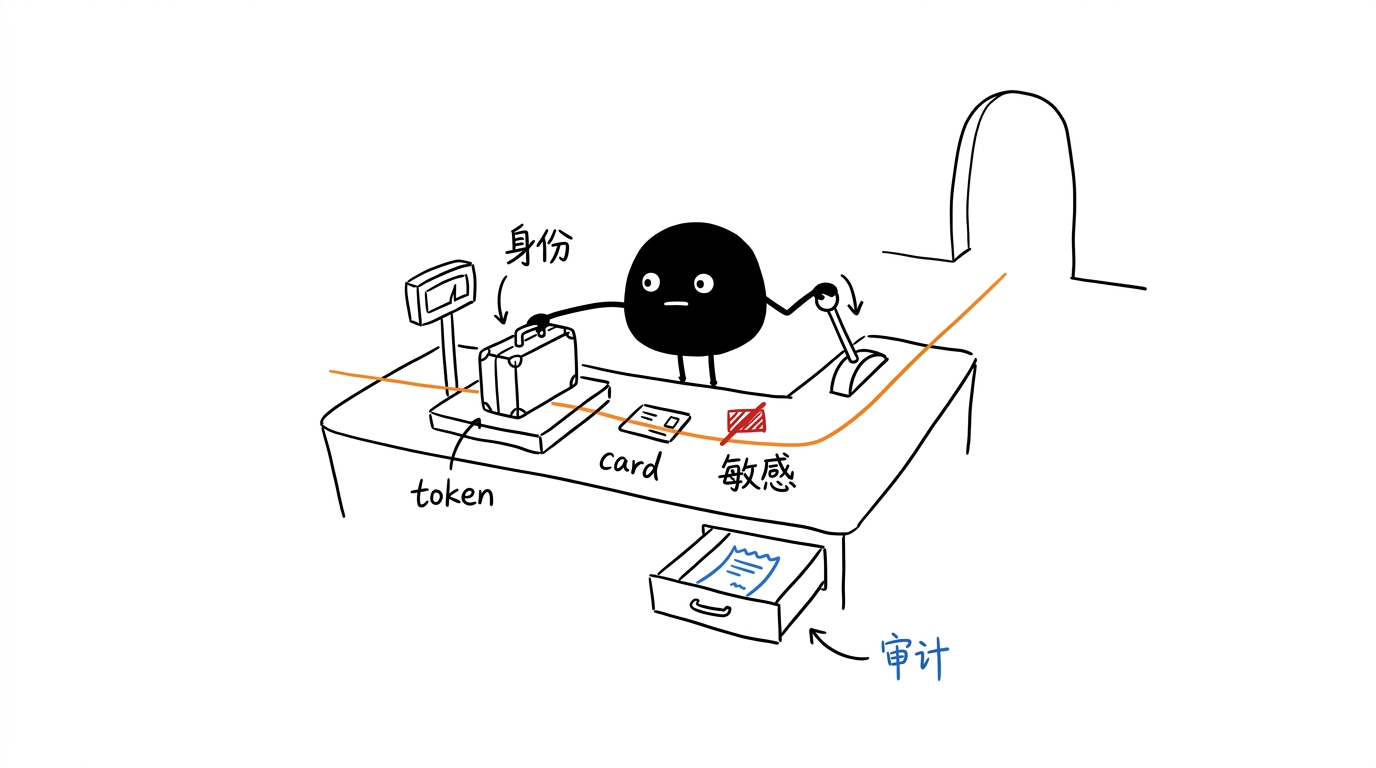
这里有一个容易被忽略的反面:网关越集中,故障半径越大;记录越完整,prompt 日志本身越可能成为敏感数据仓库。因此“企业级”不是把所有内容全部落盘,而是元数据默认可审计,正文按目的、授权、加密和保留期最小化采集。
云厂商已经把差异做到了成本与合规
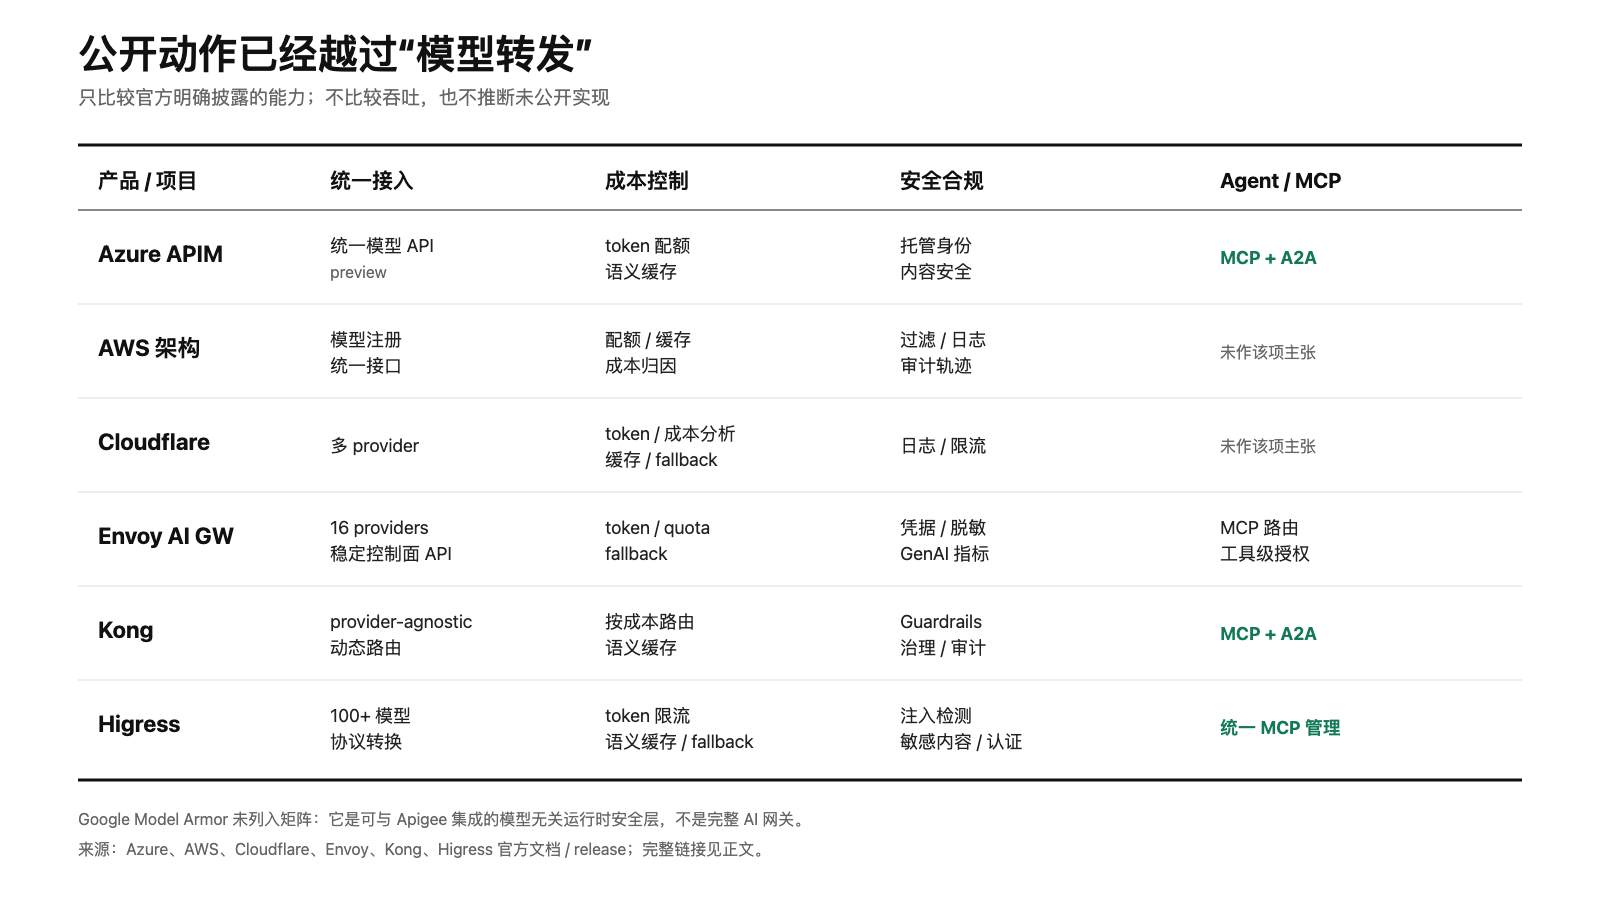
Azure API Management 没有另起一套孤立产品,而是把 AI gateway 放进既有 API 管理:统一模型 API 仍处于 preview,但已经覆盖跨厂商格式转换、托管身份、token 限额与周期配额、语义缓存、内容安全,以及 MCP 和 A2A 入口。这个动作的重点是“同一套策略只定义一次”。
AWS 的参考架构 更早把问题说透:模型注册与抽象、身份、配额、缓存、输入输出过滤、CloudWatch 日志和 CloudTrail 审计要放在统一消费平台。它是一种架构模式,不应误写成一个包含全部能力的单体产品,但它清楚表明企业采购的对象是治理闭环。
Google Cloud 则把合规能力产品化为 Model Armor:它并不是完整网关,而是可与 Apigee 等入口集成的模型无关安全层,检查 prompt、响应和 Agent 交互中的提示词注入、敏感数据、恶意文件与不安全 URL。合规从“写政策文档”变成了在线、可计量的运行时控制。
Cloudflare AI Gateway 的公开能力更偏边缘控制:请求、token 和成本分析,配合缓存、限流、重试和模型 fallback。它说明成本治理也不是一张月底账单,而是能在请求路径上直接改变调用次数和失败成本。
软件网关正在争夺同一个控制点
开源与商业软件的动作更直接。Envoy AI Gateway `v1.0` 把核心控制面 API 声明为稳定契约,统一 16 个 provider,并把 token/quota 限流、provider fallback、请求响应脱敏、GenAI 指标和 MCP 细粒度授权放进同一能力面。
Kong AI Gateway 把动态路由目标明确写成成本、延迟或可用性,同时提供语义缓存、Guardrails、数据治理、审计以及 MCP/A2A 流量控制。Higress 则公开支持 100 多个模型,组合 token 限流、语义缓存、fallback、提示词注入与敏感内容检测、认证、可观测和 MCP 管理。
这些产品实现不同,却在收敛到同一组采购问题:接口能否稳定,token 能否预算化,敏感数据能否在出站前被拦住,Agent 调工具能否授权,所有决策能否形成证据。
功能清单不够,要看控制闭环
成本能力最容易被一张漂亮仪表盘掩盖。真正可用的账本必须统一不同 provider 的用量口径,区分输入、输出、reasoning、cache read、cache write 和工具调用,并能把网关估算与供应商账单定期对账。LiteLLM 这次专门修正缓存写入 token 的成本映射,恰好说明“看见 token”不等于“算对钱”。路由节省了多少,也要与质量、首 token 延迟、失败重试和缓存命中一起记录,否则低价模型可能只是把成本转成更高的返工率。
合规能力同样不能停留在“支持脱敏”四个字。采购 POC 至少要验证策略执行顺序、流式响应能否中途阻断、误报后如何受控放行、配置变更由谁审批,以及控制面不可用时数据面选择 fail-open 还是 fail-closed。每次判定应留下策略版本、主体、模型、地域、命中规则和处置结果;prompt 正文则应默认最小化保存。这样审计拿到的是可重放的决策证据,而不是一堆无法解释的文本日志。
最后还要把旁路纳入威胁模型。只要应用仍能直接持有 provider key,网关上的预算与合规规则就不是边界,只是一条建议路径。企业级部署应把上游凭据、网络出口和工作负载身份一起收口,并用短期凭据与密钥轮换降低集中化风险。
技术判断:成本和合规才是长期护城河
我的判断是,模型转发会快速商品化,成本与合规执行才会决定 AI 网关能否进入企业基础设施清单。原因不是企业不关心性能,而是低延迟、高吞吐和多模型接入很快会变成入场券;预算失控、数据越境、工具越权或审计断链,却会直接阻断上线。
这也给落地顺序一个明确答案。第一,先建立虚拟模型名和 provider-independent contract,避免应用绑定供应商。第二,把成本账本做到团队、应用、Agent、模型和工具五个维度,缓存 token 与 reasoning token 不能丢。第三,把策略写成可测试、可版本化、默认 fail-closed 的配置,并演练控制面失联。第四,给流式请求单独定义超时、重试和旁路策略,避免治理层成为新的单点。
当网关能够在不改应用的情况下替换模型,在调用前阻止超预算和不合规请求,在调用后给出可核验账本,它才完成了从“中转代理”到“企业基础设施”的升维。