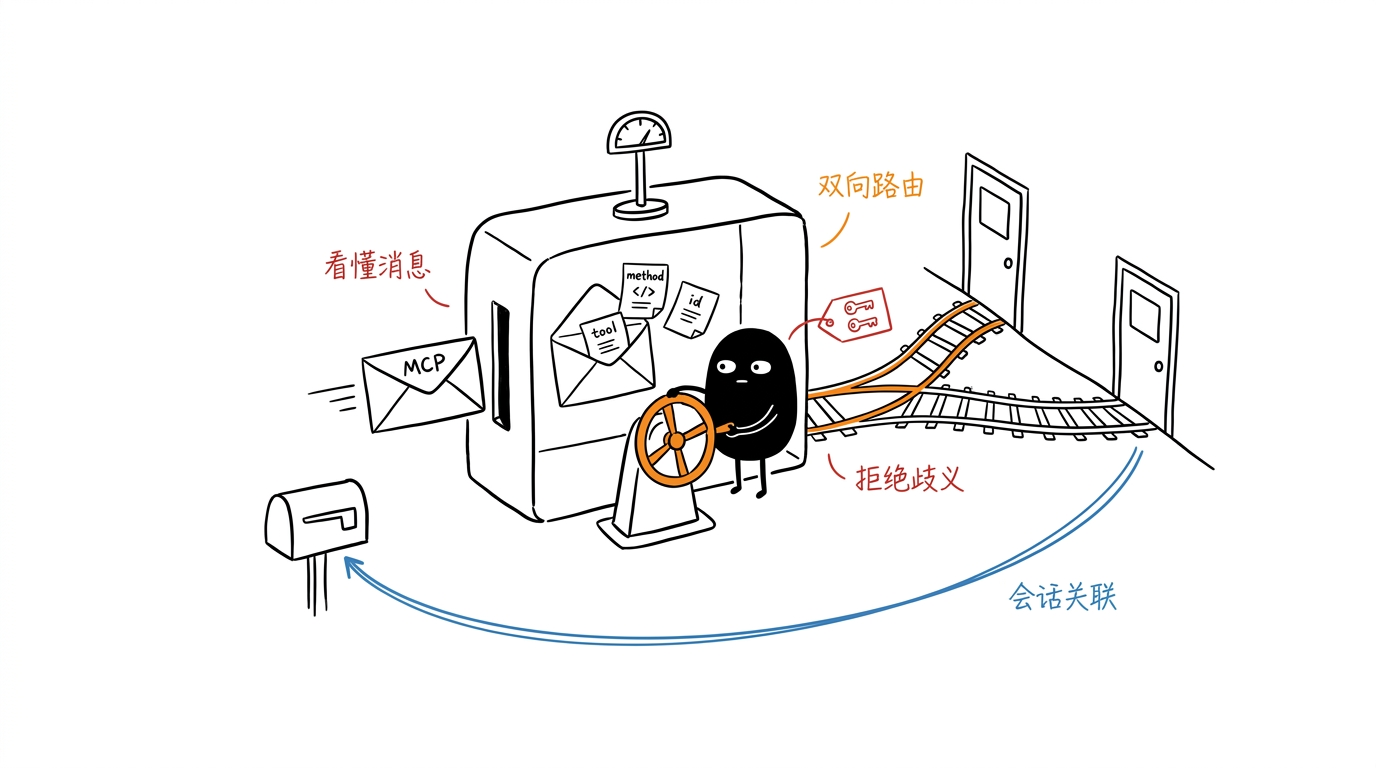
传统 API 网关收到一段 JSON,通常关心路径、Header、身份和限流;至于 body 里是 tools/call,还是某个后端向客户端发出的 elicitation/create,往往留给应用处理。
7 月 15 日发布的 Envoy 1.39,开始改变这条边界。它不仅能识别 MCP 消息,还加入了流式 JSON 解析、字段级策略元数据、多后端聚合、反向请求路由与 REST bridge。MCP 网关正在从“转发一段 HTTP”变成“理解一段 Agent 协议”。
这次发布真正增加了什么
Envoy v1.39.0 的改动很多,MCP 相关能力可以分成三组。
第一组是看懂消息。MCP filter 会解析 JSON-RPC,把 method、id、params.name 等字段写入 dynamic metadata,后面的 RBAC、ext_authz、访问日志和 tracing 因此可以围绕“调用了哪个工具”做策略,而不只围绕 URL 做策略。
新加入的 Wuffs 流式 JSON parser 则按 HTTP body chunk 增量解析,不必先把完整 body 构造成 DOM。官方 release notes 还明确写到,它只捕获处理器选择的字段,大字段可保留为原始 body 的 byte range;这让协议识别不必天然等于“复制并驻留整段 prompt”。
第二组是挡住歧义输入。1.39 提供 reject_duplicate_keys,可在任意嵌套层级拒绝重复 JSON key;解析状态也会进入 metadata 和 filter state,区分 body 超限、解析失败、重复键等结果。版本同时移除了“找到目标字段就提前停止解析”的优化,改为完成 root object 解析,以缓解 JSON Parameter Pollution。需要注意:reject_duplicate_keys 默认是 false,升级本身不等于已经启用防护。
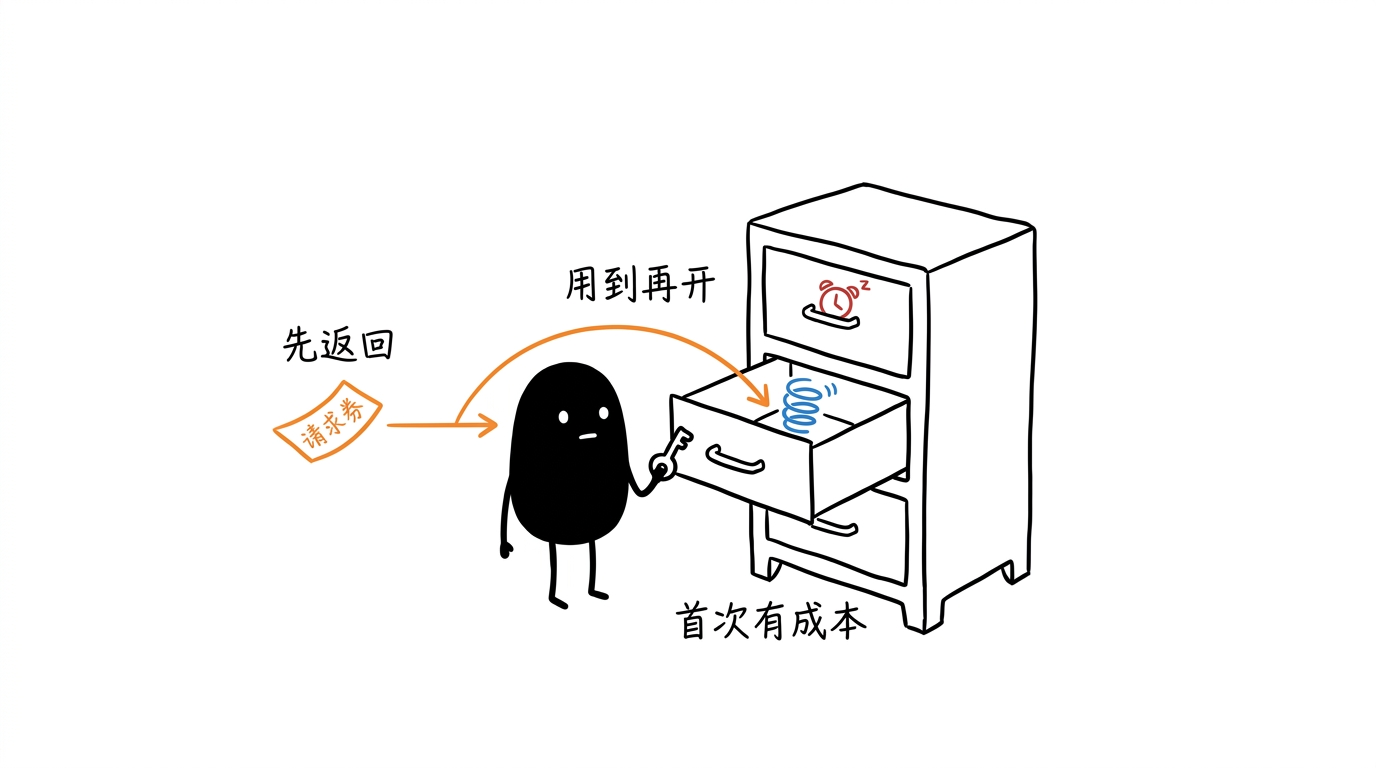
第三组是接管会话与路由。MCP router 可以把多个后端呈现成一个逻辑入口。lazy_initialization 让客户端初始化不再等待所有后端逐个响应,而是在第一次路由到某个后端时再初始化它;慢后端不会拖住整个入口,但第一次命中仍会付出初始化成本。
同一版本还扩展了 MCP JSON REST bridge:工具配置可以按 route 覆盖,tools/list 也可以由网关本地生成,不必每次转发到 upstream。这适合把存量 REST 服务逐步暴露成 MCP tool,但控制面必须成为工具清单的事实来源。否则本地列出的 schema 与后端真实能力漂移,Agent 会先“发现”一个工具,再在真正调用时失败。
最关键的变化:请求不再只有一个方向
普通反向代理的心智模型很直:客户端发请求,网关选 upstream,upstream 回响应。MCP 的 session 里,后端也可能主动向客户端发请求,例如 elicitation/create 索取用户输入、sampling/createMessage 请求模型生成,或 roots/list 查询客户端可用根目录。
Envoy 1.39 的 MCP router 会通过 SSE 把这些 server-to-client 请求送回客户端。在多后端聚合模式下,它还会改写 JSON-RPC id,给原始 id 加上后端前缀;客户端响应回来后,网关再解析前缀、恢复原始 id,并把响应送回正确的 backend。
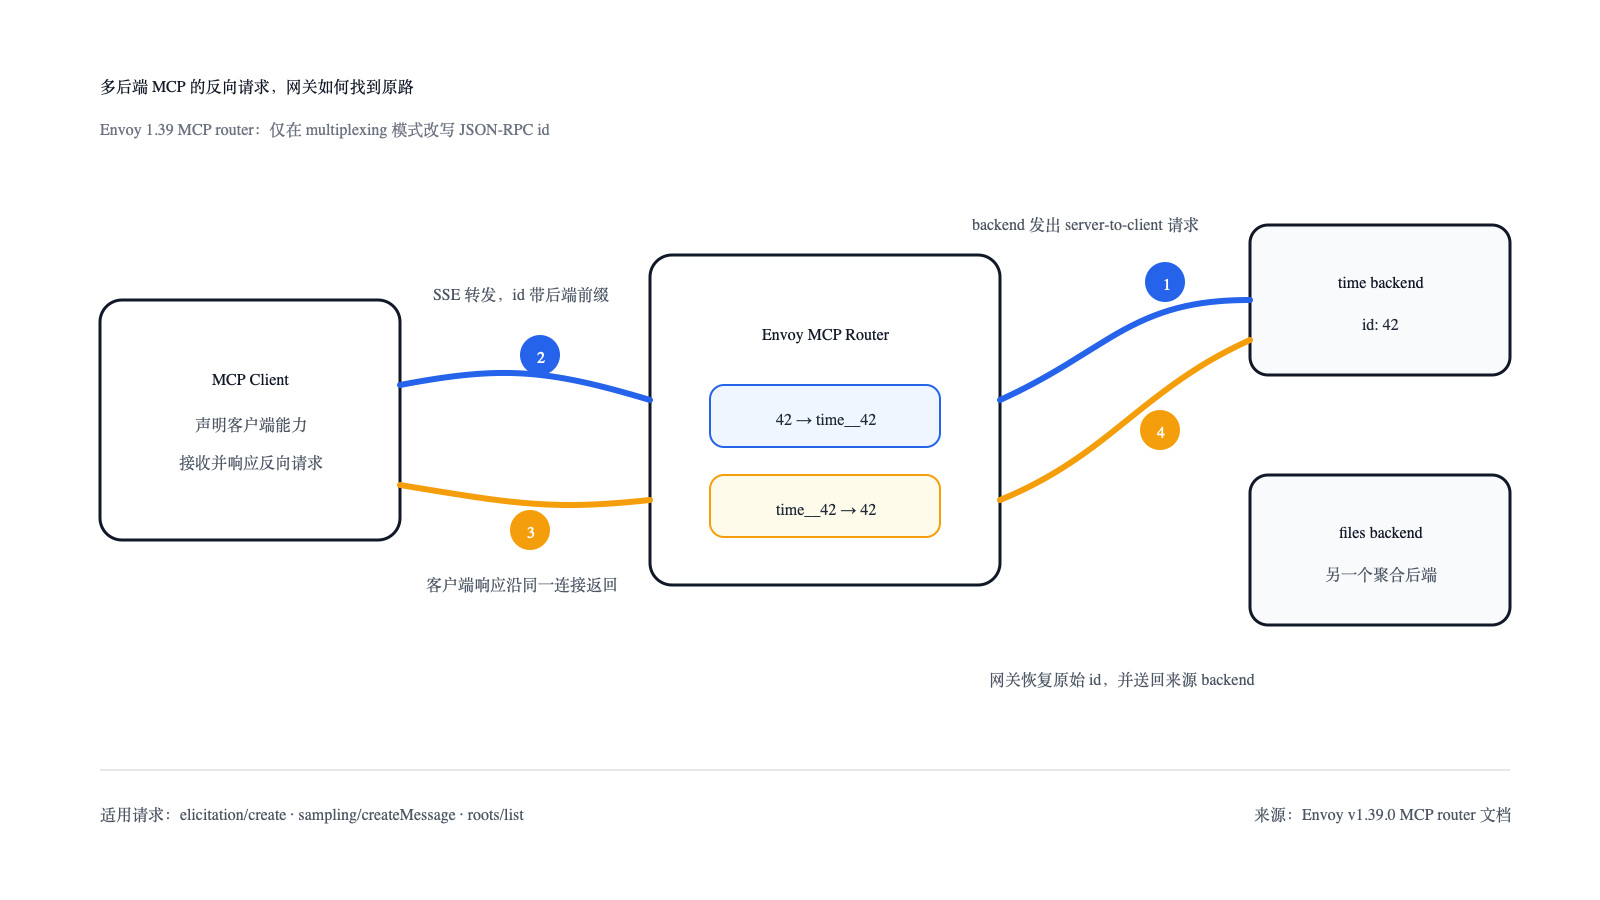
这件事看似只是“改一下 id”,实际意味着网关要维护协议级关联:哪个 client session 对应哪些 backend session,哪一个反向请求从哪里来,客户端是否声明了相应能力,响应最终该回到哪里。MCP 网关因此同时承担四种角色:消息解析器、策略执行点、聚合路由器、会话相关器。
这也是 MCP 网关和“给 API Gateway 加几个路径规则”的根本差别。HTTP 路由选错 upstream,通常表现为 404 或权限错误;反向请求的关联丢失,可能表现为用户批准送错工具、sampling response 回错 agent,或者一个失速 backend 长时间占住 session。错误从一次请求扩大成一段双向会话。
网关为什么必须看 body,又不该看得过多
要按 tool、resource 或 method 做最小权限,网关必须读取部分 body;但 Agent 流量又可能包含 prompt、文件片段、工具参数和个人数据。全量记录显然会扩大敏感数据面,完全不解析又只能退回粗粒度 URL 策略。
Envoy 这次的设计给出一个有价值的中间路线:流式提取少量有界标量,把策略所需字段写入 metadata,把大字段留在原始字节范围内。对平台团队而言,合理默认值不是“记录所有 MCP body”,而是只暴露 method、tool name、解析状态、body 是否超限、路由后端与 session correlation id;工具参数本身按需脱敏,默认不进访问日志。
重复键防护尤其应该在这里启用。假设请求同时出现两个 model 或两个 params.name,网关与后端若采用不同的“第一个值/最后一个值”规则,前置授权看到的对象可能不是最终执行的对象。拒绝歧义输入比试图让所有解析器恰好一致更可靠。
不过,body size limit 不能简单照搬普通 JSON API。1.39 在 PASS_THROUGH 模式允许超限请求继续通过,并用 is_exceeding_limit 标记;在 REJECT_NO_MCP 模式,如果限制范围内找不到必需字段则返回 400。这是兼容性与强制策略之间的明确取舍。平台应按路径决定:高风险工具入口宁可 fail closed,纯观测入口可以 pass through,但必须让告警与日志看见“策略没有完整解析”。
我的技术判断:MCP 数据平面已经出现,但还不是成品
Envoy 1.39 的意义,不是宣布 MCP Gateway 已经成熟,而是证明它需要一套独立的数据平面语义。 这套语义至少包括增量解析、字段级授权、双向消息、会话映射和协议桥接。继续把这些逻辑散落在每个 Agent SDK 里,策略会重复、审计会断裂,故障也很难从入口收敛。
但现在不适合把全部 MCP 流量一次性迁入。官方文档明确标注 MCP filter 仍在 actively under development;重复键拒绝也不是默认开启。新 parser、router 与 transcoder 应被视为待验证能力,而不是升级即可获得的生产承诺。
比较稳妥的落地顺序是:
- 先做 pass-through 观测,只提取
method、tool name、解析状态和 backend,不改写业务流量。 - 在影子流量中打开
reject_duplicate_keys,统计现有客户端是否产生歧义 JSON,再逐步转为强制拒绝。 - 先对只读、幂等工具启用字段级 RBAC 或
ext_authz,把高风险写操作留在独立路由与独立策略域。 - 最后试点聚合 router,并专门压测断线重连、SSE 中断、重复 JSON-RPC id、后端迟迟不初始化以及客户端不支持 elicitation 的情况。
回滚也必须按协议层准备。关闭某个 filter 容易,已经建立的多后端 session 却未必能无损迁移;因此 canary 单元至少要绑定 Envoy 版本、MCP filter 配置、router 模式与客户端能力集合。发现异常时,应排空新 session,让既有 session 自然结束,而不是只滚动重启 Pod。
观测上也要把“请求完成”和“会话完成”分开。一次 tools/call 返回 200,只能说明这一轮响应结束;后端可能仍持有 SSE、等待用户确认,或等待客户端返回 sampling 结果。网关应至少记录 session 建立、后端初始化、反向请求发出、客户端响应、超时和清理这几类状态,并用同一个 correlation id 串起它们。这样排查时才不会把一个尚未关闭的会话误判成空闲连接,也不会因为只看请求日志而漏掉真正的阻塞点。
给网关团队的四个检查题
上线前可以问四个问题:授权依据是 URL,还是实际的 MCP method 与 tool name?网关和后端遇到重复 JSON key 时是否得出同一结论?server-to-client 请求断线后,id 映射由谁清理?某个慢后端会拖住全部客户端初始化,还是只影响第一次命中它的请求?
如果这四个问题还没有答案,你拥有的是一个能转发 MCP 的代理,还不是一个能治理 MCP 的网关。