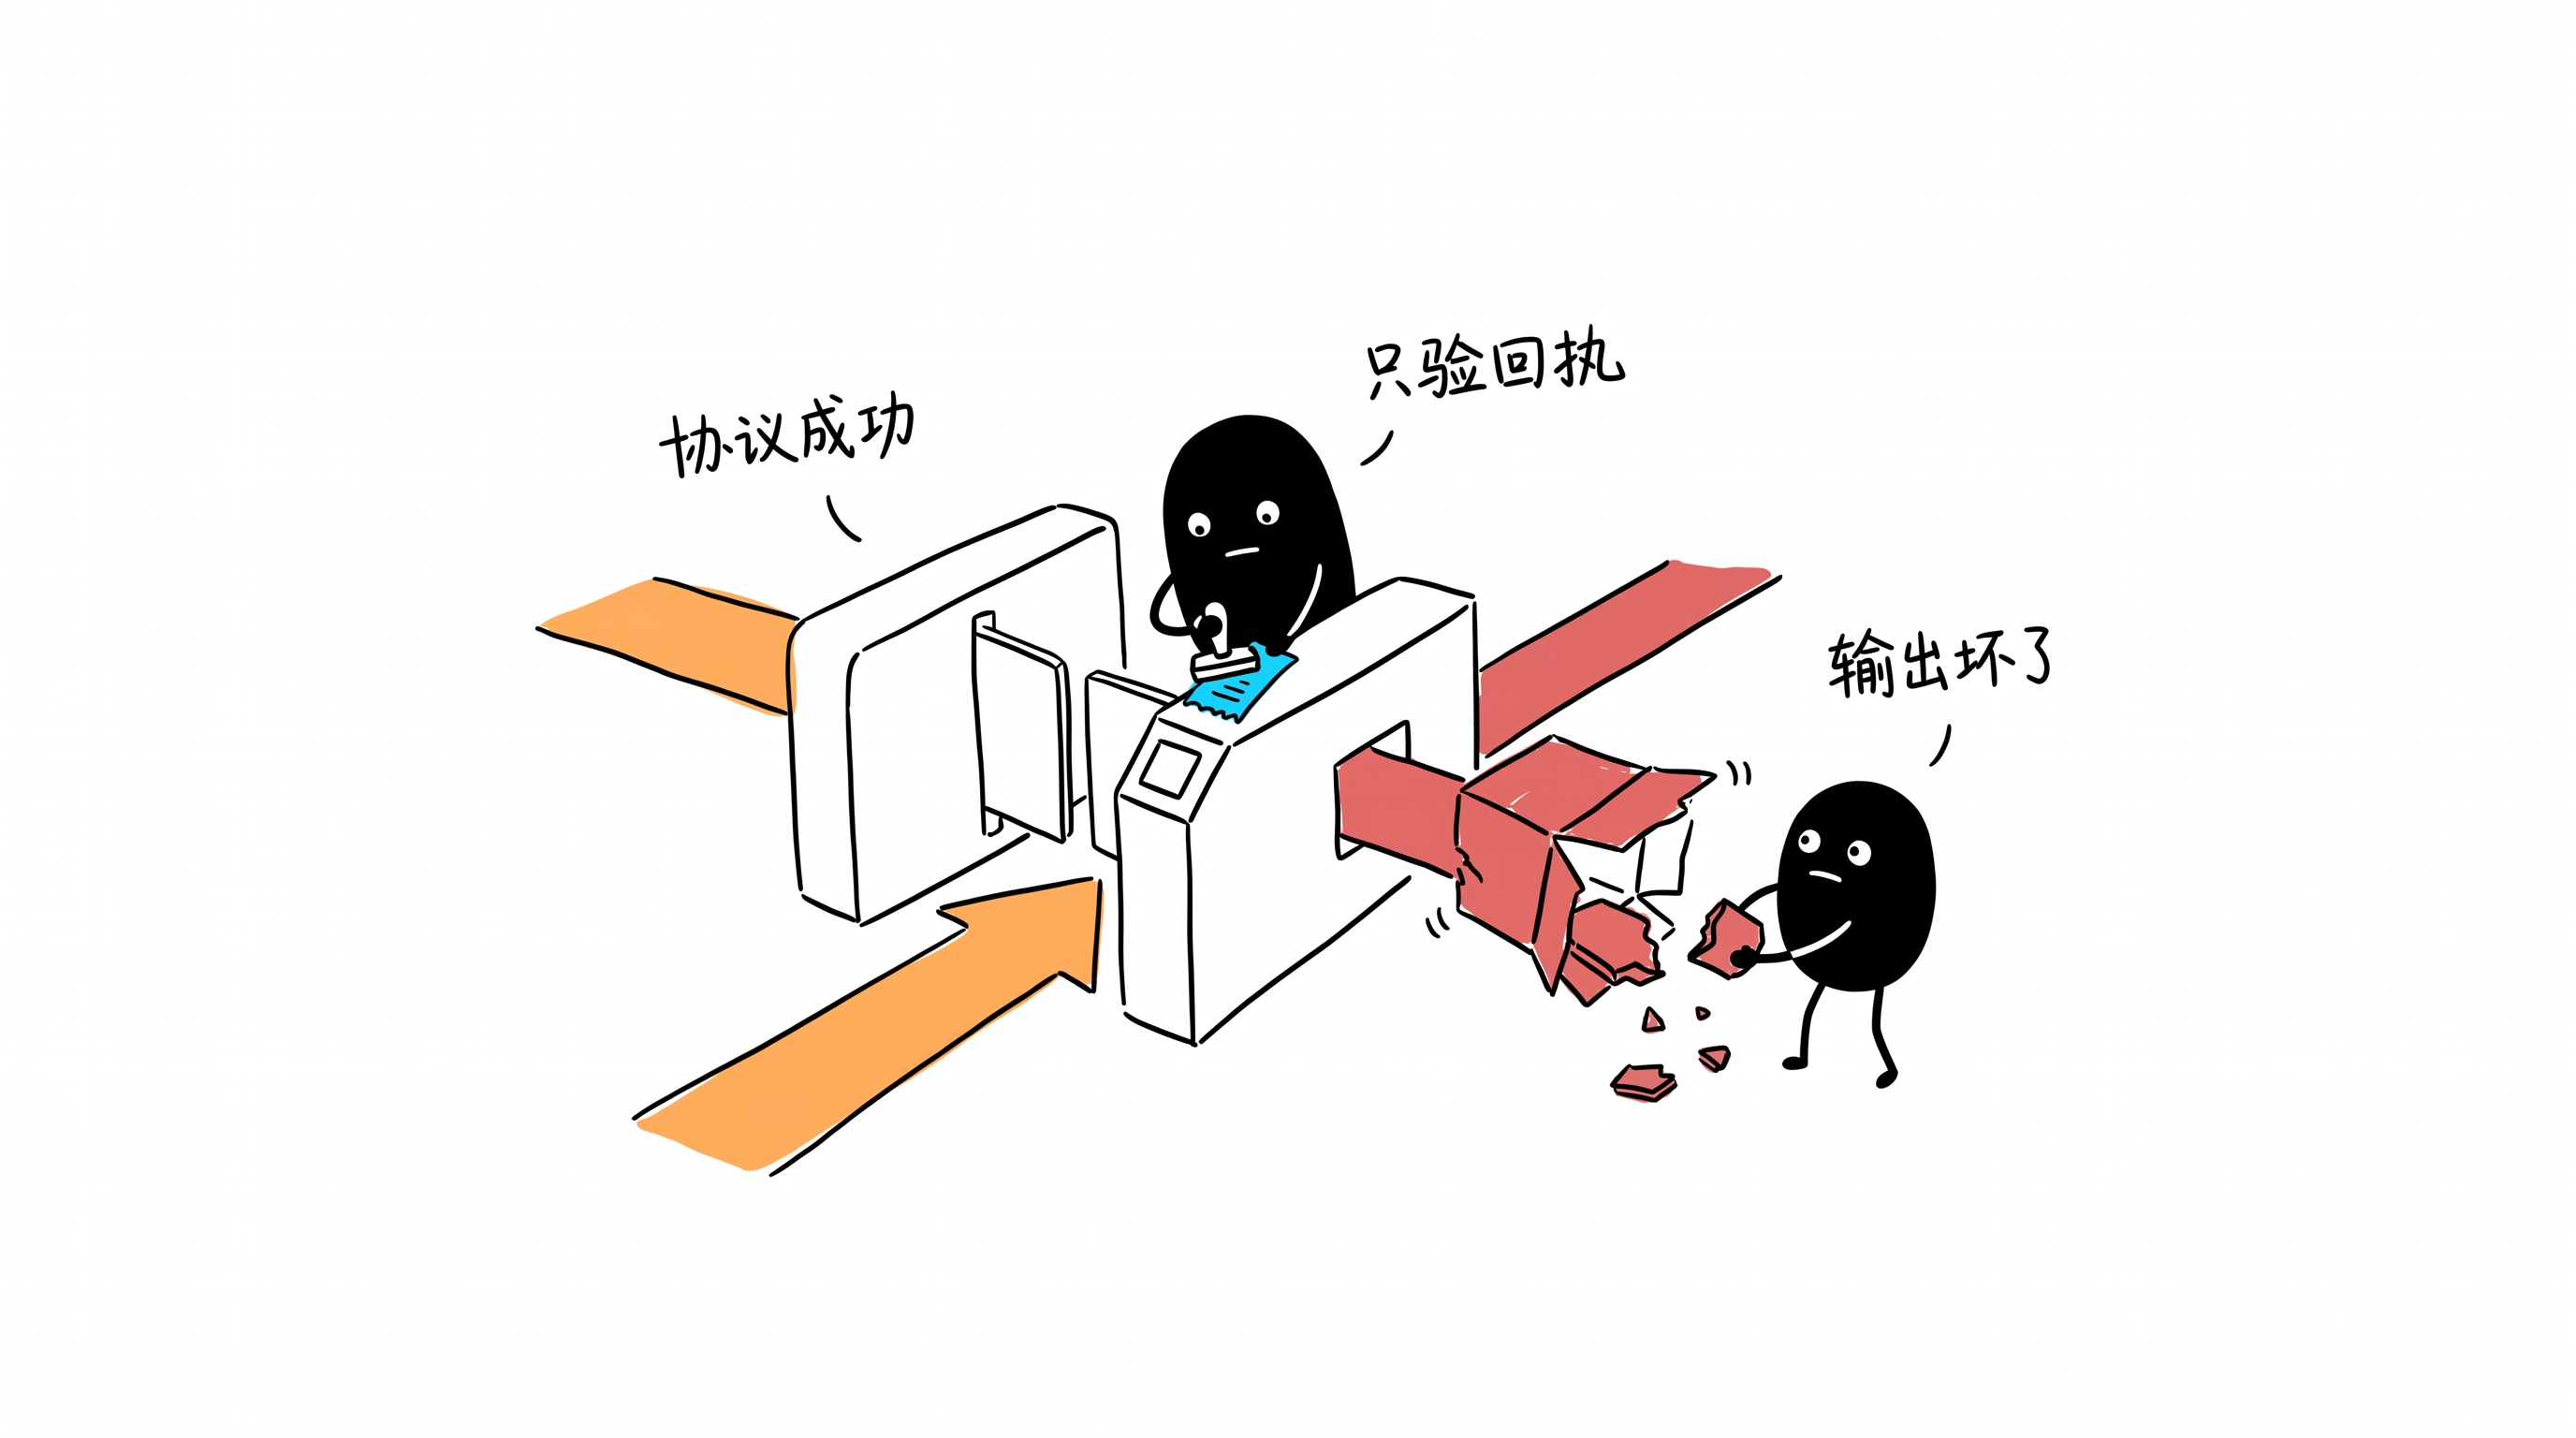
一次请求返回了完整 JSON,延迟也在 SLO 内,网关会判它成功;但模型输出可能只剩下一串 !!!!!。这不是假设题。7 月 14 日,vLLM 和 SGLang 发布的两个补丁,分别修复了会破坏 hidden state 或产生 NaN 的精度路径问题。
它们提醒我们:推理网关面对的不只是连接失败、超时和限流。服务“活着”,不代表模型还在正确推理。
同一天的两条补丁
北京时间 7 月 14 日 16:51,vLLM 发布 v0.25.1。这个 patch release 只有两项定向修复,其中一项针对 FlashInfer 的 allreduce + RMSNorm + static quantization 融合:当 activation 与 RMSNorm weight 的 dtype 不一致时,图模式仍可能被错误匹配,导致 hidden state 损坏,输出出现重复感叹号等异常。修复没有关闭整条优化路径,而是在融合前增加 dtype 一致性检查;同 dtype 继续走快路径,不兼容图退回安全路径。
八分钟前,SGLang 发布 v0.5.15.post1。其中 PR #31001 针对更具体的组合:GLM/DeepSeek NVFP4、modelopt_fp4 与 flashinfer_trtllm MoE backend。PR 记录显示,FP32 的 correction bias 被传给要求 bfloat16 的 kernel;在长上下文的特定路由条件下,expert weight 变成 NaN,继续传播到 logits,greedy decoding 最后退化为重复的 !。补丁恢复了该路径的 bfloat16 bias。
这两个问题不是同一个 bug,也不能据此断言 FP4、FlashInfer 或算子融合普遍不可靠。它们的共同点更值得网关团队关注:进程可以启动,请求可以走完整条链路,输出却已经失去语义。
为什么传统健康检查会漏掉
普通 L7 网关判断 upstream 健康,主要看连接、状态码、超时和延迟。推理网关还会观察 token 数、首 token 延迟、队列和显存。它们都重要,却主要回答“请求有没有完成”和“资源有没有过载”。
上述引擎缺陷发生在更深处:图融合选择、dtype contract、MoE routing、logits 与 decoding。只要 serving 层仍能序列化响应,外层网关就可能看到一次协议成功。这里的“HTTP 200 不等于健康”是工程判断,并非两个项目对具体 HTTP 状态码的测试结论;核心是协议可用性与语义正确性属于两套信号。
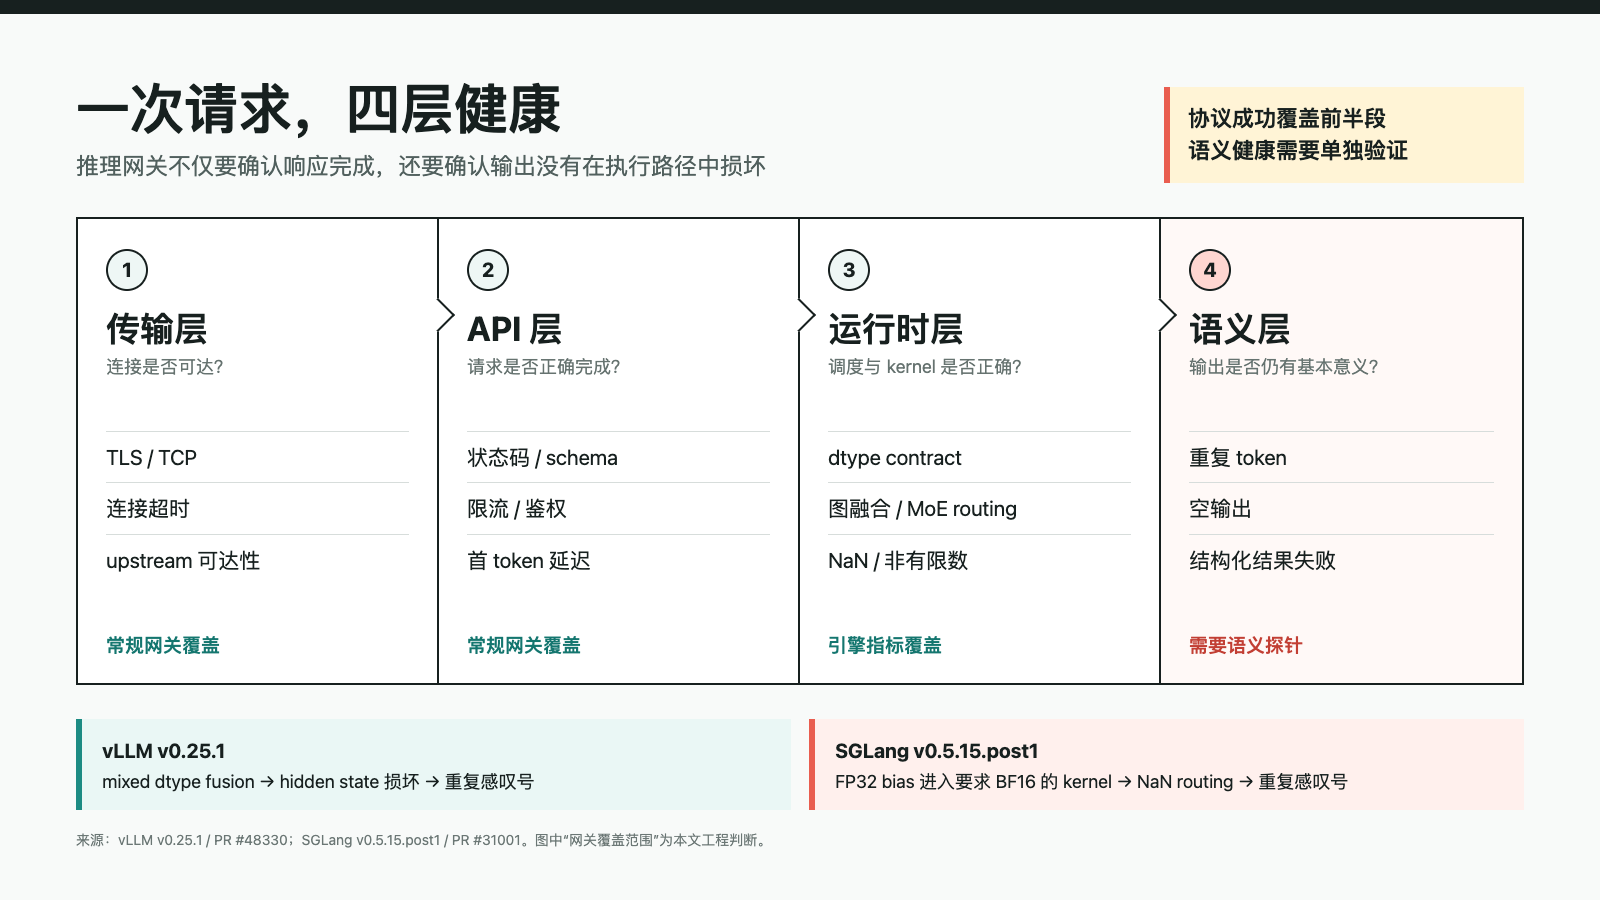
可以把一次推理拆成四层:传输层保证连接可达,API 层保证请求合法,运行时层保证调度和 kernel 执行,语义层判断结果是否仍有基本意义。传统网关覆盖前两层较好,推理引擎暴露第三层指标,而第四层往往无人负责。
从机制上看,vLLM 的问题发生在图优化阶段。pattern matcher 看见了可以融合的算子拓扑,却没有先证明输入和 weight 的 dtype 相容;新增的 _norm_input_weight_dtype_match,本质上是把一个隐含 contract 变成了进入快路径前的显式条件。SGLang 的问题则发生在 MoE 路由参数进入 kernel 的边界:上游保留 FP32,目标 kernel 要求 bfloat16,类型没有在接口处被校验,错误最终才在长上下文的路由计算中显现。
这也是为什么只看 GPU 利用率和进程日志仍不够。一次非法访存通常会让任务失败,监控很容易发现;数值仍可计算但已经污染的中间状态,却可能一路通过 decoding 和响应序列化。对客户端而言,两者一个是明确错误,另一个更像“模型突然变笨”,后者更容易被重试、缓存或继续分发,扩大影响范围。
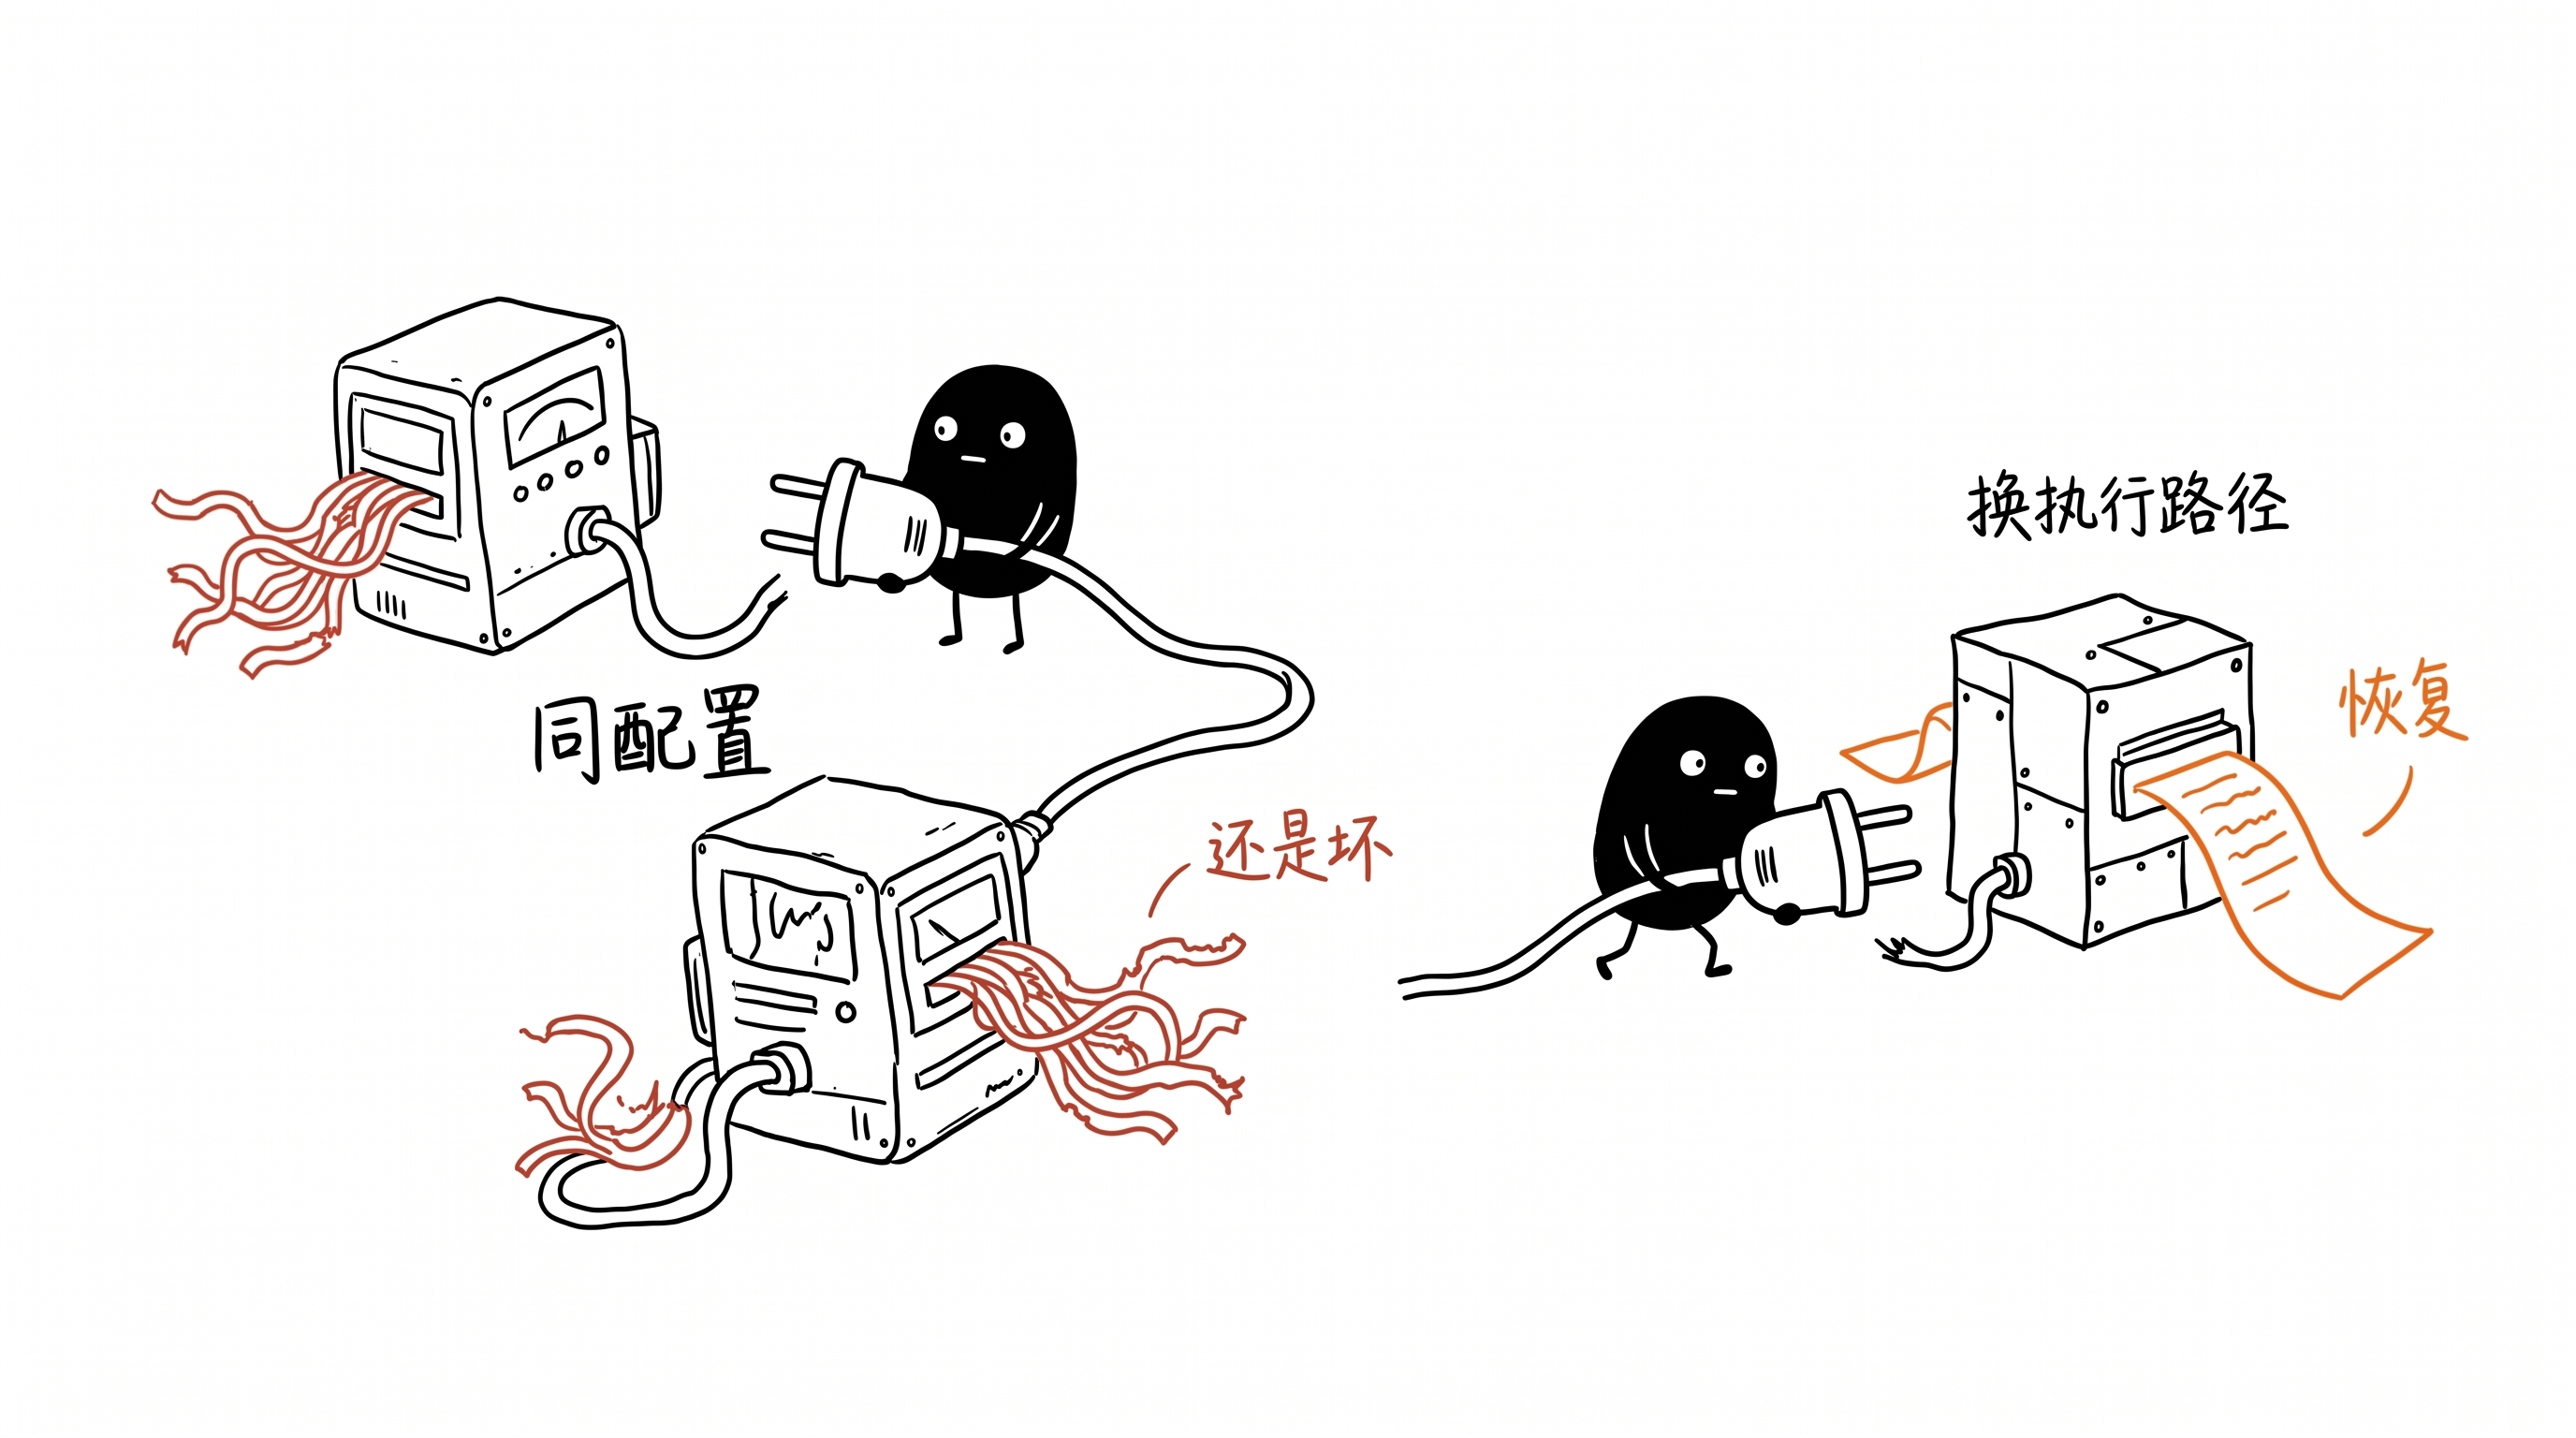
网关不需要理解每个 kernel,但必须知道哪些 endpoint 共享同一个执行条件。两台机器如果运行相同模型、引擎、量化和 backend,换机重试并没有跨越故障域。只有切换到经过验证的不同版本或不同执行路径,才算真正的 fallback。
语义健康不是“再做一次大模型评测”
在线语义探针不需要判断答案是否优美,更不该在热路径上再调用一个昂贵的 judge model。它要检测的是低成本、可重复的失效形态:输出是否被单一 token 占满,是否出现空响应,logprobs 是否为 null 或 NaN,结构化输出能否通过 schema,以及一组固定问题是否仍满足最小约束。
这里要区分三件事。语义健康检查输出有没有明显损坏;质量评测判断答案好不好;内容安全判断答案能不能被交付。三者可以共享采样和追踪体系,却不能共用一个模糊分数。健康信号适合秒级发现与自动排空,质量变化通常需要更长窗口和人工解释,安全策略则有独立的合规边界。混成一个指标,最终既难自动化,也难追责。
探针还必须覆盖路由维度。SGLang 的案例与长上下文、特定量化和 backend 组合相关;只用一句“你好”做 readiness probe,几乎没有机会触发问题。有效的探针矩阵至少要包含短/长上下文、关键模型、量化方式、推理引擎版本和 kernel backend,并将这些元数据带入网关的 endpoint 身份。
我的技术判断:网关应成为发布护栏
推理网关下一步最有价值的能力,不是再增加一种负载均衡算法,而是把引擎版本、运行配置和输出健康连成发布闭环。 两个同日补丁只是具体证据,不足以证明行业趋势;但它们已经说明,仅按实例和 HTTP 指标做流量治理存在可复现的盲区。
落地时可以先做四件事:
- 把
model + engine version + quantization + backend + context class视为一个可观测的 deployment unit,不要只记录模型名。 - 新版本先接固定比例的 canary 流量,同时运行短、长上下文语义探针;异常率与稳定版本对照,而不是只设一个绝对阈值。
- 将重复 token、空输出、schema 失败和非有限数计入 endpoint health;触发阈值后停止扩容新版本并自动排空,而不是在同一坏配置上重试。
- 预先验证 fallback。回退可以是旧引擎、另一 backend 或禁用特定融合,但不能在事故中临时猜测一条“安全路径”。
还需要给探针设置成本预算。固定探针可以在部署时完整运行,在线阶段则按 endpoint 分层抽样;长上下文探针不必跟随每次请求,却必须在版本、驱动、kernel 或量化配置变化后重新执行。结果要和 release identifier 一起保存,保证网关正在使用的健康结论对应当前二进制,而不是昨天的镜像。
控制面可以把结果收敛为三个简单状态:pass 允许继续放量,observe 保持 canary 并提高采样,quarantine 停止接收新流量。每次状态变化都应保留触发探针、endpoint 元数据和异常样本的引用,让值班工程师能从网关告警直接落到具体执行组合。这样自动化处理的是影响范围,人工判断处理的是根因和是否恢复。
对真实请求的在线抽样还要遵守数据边界。多数健康信号只需要统计重复率、结构是否合法和数值是否有限,不必保存完整 prompt 与 response;需要留样时,应沿用现有脱敏、权限和保留期策略。语义健康不能以扩大敏感数据面为代价。
语义探针也会误报,例如代码生成原本就可能输出大量重复符号。因此它适合做分模型基线、组合信号和发布阻断,不适合成为不透明的全局熔断器。网关负责发现异常和收敛影响范围,最终根因仍要回到引擎、kernel 与模型配置。
给网关团队的检查题
下一次升级 vLLM、SGLang 或底层 kernel 前,可以先问三个问题:我们的 canary 是否覆盖生产中的最长上下文和量化组合?网关能否区分“实例存活”与“输出退化”?发现异常后,流量会切到经过验证的不同执行路径,还是只换到另一台同配置机器?
如果答案仍是后者,推理网关拥有的是高可用转发,不是高可信推理。