「API 网关、AI 网关、推理网关、推理引擎分别有哪些可选项,谁主导?」这个问题一问出来就容易跑偏,因为这四个词在厂商宣传里几乎是混着用的:同一个二进制可以同时自称三种网关,而 Dynamo 这种明明是编排层的东西经常被算进推理引擎。
所以先画边界,再谈选型。
一、四层的边界
1 | |
要点是:这四层是职责划分,不是四个采购项。实际产品里第 2、3 层常常是同一个进程的不同功能集——Envoy Gateway 一个二进制就能同时扮演 API 网关、AI 网关和推理网关。自托管场景下把它们拆成四套独立组件,多半是过度设计。
二、API 网关:这一层已经分出胜负了
Gateway API 替代 Ingress 不再是趋势判断,而是既成事实。
推动它落地的不是技术优越性,是一次强制迁移:2025 年 11 月 11 日,SIG Network 宣布 ingress-nginx 于 2026 年 3 月退役——没有新版本、没有 bugfix、没有安全补丁。这个组件此前存在于大约一半的 K8s 集群里,所以过去半年整个生态被推着走完了迁移,ingress2gateway 也到了 1.0。
Gateway API 本体的节奏很稳:v1.4(2025-10)、v1.5(2026-02,大批 Experimental 转 Standard)、v1.6(2026-08,TCPRoute/UDPRoute 进 Standard)。
可选项按数据面分三类:
- Envoy 系:Envoy Gateway、Istio(ambient)、kgateway(原 Gloo,已捐给 CNCF)、Contour
- 独立数据面:Traefik、APISIX、Higress、Kong、NGINX Gateway Fabric
- eBPF:Cilium Gateway
自托管选型上,Envoy 是事实标准,落点集中在 Envoy Gateway 和 Istio。已经在跑 Istio 的集群没有理由再引入第二个数据面。Cilium Gateway 适合本来就用 Cilium 做 CNI、且网关需求简单的场景,能省掉一层独立代理。
方向上有一个值得注意的变化:网关和 mesh 的边界正在消失。Istio ambient 的 waypoint 本质就是集群内网关,1.30 的 TrafficExtension API 又把 Wasm/Lua 扩展统一成了一个 API。
三、AI 网关:唯一还在混战的一层
可选项很多:Envoy AI Gateway(Tetrate + Bloomberg)、kgateway AI Gateway、Higress、APISIX、Kong AI Gateway,加上非 K8s 原生但份额巨大的 LiteLLM,以及托管的 Portkey、Cloudflare、Vercel AI Gateway。
没有主导者。LiteLLM 靠 100+ provider 覆盖占了开发者心智,但它是个 Python 应用,不是 K8s 原生数据面。2026 年 3 月它遭遇了一次供应链投毒,后果被放大得很厉害——因为 AI 网关这个位置天然集中持有所有模型 API key 和云凭证,爆炸半径远大于普通代理。这件事之后,企业向 Envoy/Rust 系数据面迁移明显加速。
这是自托管选型里最需要想清楚的一层,判断标准不是功能列表,而是一个问题:这个进程要不要持有你所有的密钥?如果要,它的供应链和权限模型就得按基础设施的标准审,不能按工具的标准审。
方向上,这一层的能力集正在从「LLM 代理」扩到「agent 数据面」:MCP 工具级授权、A2A、token 配额与成本归因、guardrails、semantic cache。agentgateway(Solo.io 捐给 Linux Foundation,Rust 实现)是这个方向最纯粹的代表,它同时也是下一层推理网关标准的一个实现。
四、推理网关:标准已 GA,但大脑搬了家
这是四层里唯一有清晰标准收敛的:Gateway API Inference Extension(GIE)已经 GA,v1alpha2 正在废弃。
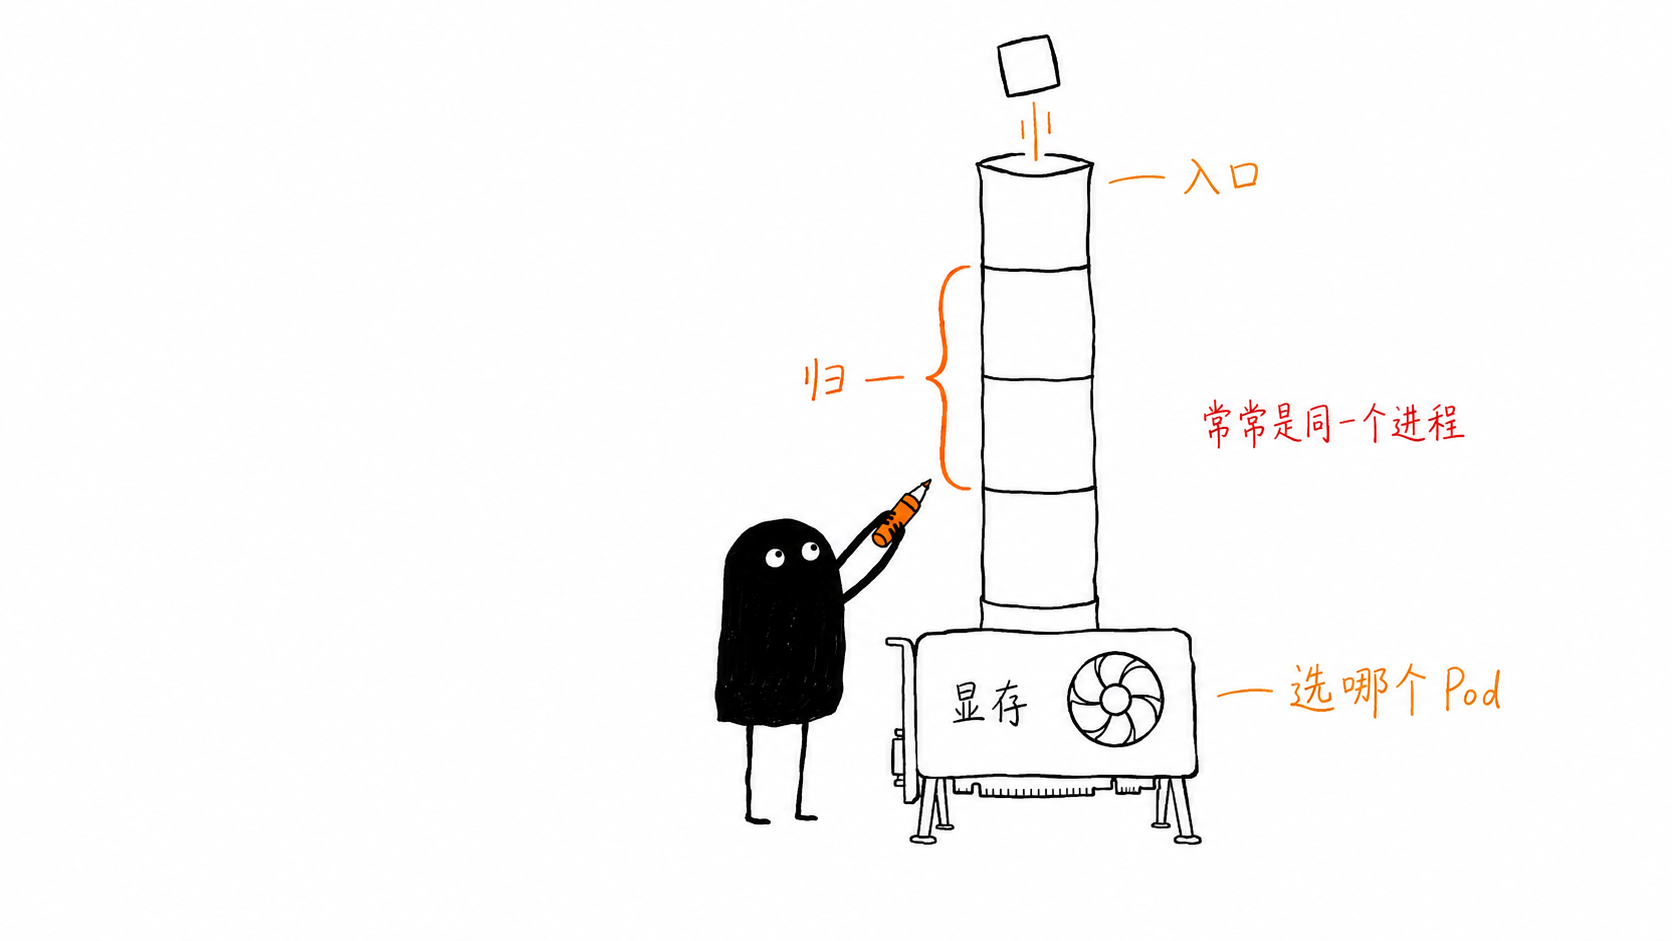
核心抽象是 InferencePool 加 Endpoint Picker(EPP,走 Envoy ext-proc),按模型服务器上报的真实信号——队列深度、KV cache 前缀命中、LoRA 适配器装载——来选 Pod,而不是轮询。
实现侧已经很齐:Envoy Gateway / Envoy AI Gateway、kgateway、Istio、agentgateway、GKE Inference Gateway(已支持多集群)、Azure Application Gateway for Containers,以及 NVIDIA Dynamo 的集成。
但有一个治理变化,选型时容易踩空:GIE 仓库现在只保留 InferencePool 和一个轻量 EPP。InferenceObjective、InferenceModelRewrite 和完整 EPP 已经迁到 llm-d/llm-d-router,Body Based Router 迁到 llm-d-inference-payload-processor,社区会也并入了 llm-d Router meeting。
翻译成一句话:标准接口留在 k8s-sigs,路由大脑落到了 llm-d。如果你按半年前的文档去 GIE 仓库找 EPP 的高级调度能力,会找不到。
官方 roadmap 上还没做完的部分值得先看一眼,因为它们决定你现在要不要自己补:prefix-cache 感知负载均衡、基于 LB 指标的 HPA、workload 优先级与公平性、异构加速器、PD 分离池独立伸缩。
五、推理引擎:先分清「引擎」和「编排层」
这一层最常见的错误是把两类东西放进同一张对比表。
真引擎(管 KV cache、batching、kernel):
- vLLM——PagedAttention,2026 年的默认答案,部署最广、硬件兼容性最好
- SGLang——RadixAttention,多轮对话、共享前缀、结构化输出场景更强;和 vLLM 既竞争也常共存
- TensorRT-LLM——NVIDIA 卡上的性能上限,已重构为 PyTorch 工作流,去掉了慢速 engine 编译步骤
- 端侧/单机:llama.cpp、Ollama、MLX;国内 LMDeploy、KTransformers
编排层(不是引擎,是把引擎变成多节点系统):
- NVIDIA Dynamo——Triton 的下一代,已 1.0,用 NIXL 做 KV 传输,与 DGX/HGX 耦合较紧
- llm-d——Red Hat + Google + IBM,K8s 原生,PD 分离,已进 CNCF sandbox
- AIBrix(字节,vLLM 生态)、vLLM production-stack(官方)、KServe、Ray Serve
引擎层 vLLM 是压倒性的;编排层是 Dynamo(NVIDIA 生态)和 llm-d(K8s/CNCF 生态)的双寡头竞争,还没定。
方向也很清楚:竞争焦点已经从「单卡 tokens/s」上移到分布式协调——PD 分离、KV cache 跨节点分层共享(LMCache、Mooncake、NIXL)、DRA 做 GPU 精细调度(K8s 1.34 stable)、LeaderWorkerSet 跑多机单模型。
六、顺带回答一个高频问题:容器还是裸金属
自托管场景几乎必然会问这个。答案是容器化,跑在裸金属节点上——不是二选一,是组合。
容器对 GPU 计算几乎无损耗,原因在驱动模型:nvidia.ko 在宿主机,容器内只有 CUDA userspace 库,计算路径是 ioctl 直达 /dev/nvidia* 加 DMA 到显存,中间没有拦截层。容器只是 namespace 加 cgroup,不是虚拟化。实测吞吐损耗在噪声范围内。
网上流传的「容器/K8s 有 8% 损耗」这类数字要警惕:那些测试把容器化、K8s 调度、CNI 网络、冷启动混在一起,得出的不是容器开销。
真正的代价在启动和拓扑,而且每一条都有确定解法:
/dev/shm默认 64MB。vLLM 张量并行用共享内存做进程间 IPC,默认值会直接启动失败或诡异 hang。Docker 加--shm-size=16g,K8s 挂emptyDir: {medium: Memory}到/dev/shm- 权重绝对不要打进镜像。推理镜像本身已经 10–20GB,70B fp16 权重另有 140GB。放 PVC 或本地 NVMe 缓存,safetensors 走 mmap,大规模用流式加载器(
--load-format runai_streamer) - 多机 NCCL 要能看见 IB/RoCE 网卡。需要 hostNetwork 或 RDMA device plugin,加
IPC_LOCKcapability,显式设NCCL_IB_HCA。配错的表现是「能跑但慢十倍」,不报错,很难查 - NUMA 亲和性。GPU、NIC、CPU 要落在同一 NUMA node,K8s 需要开
--cpu-manager-policy=static加 Topology Manager
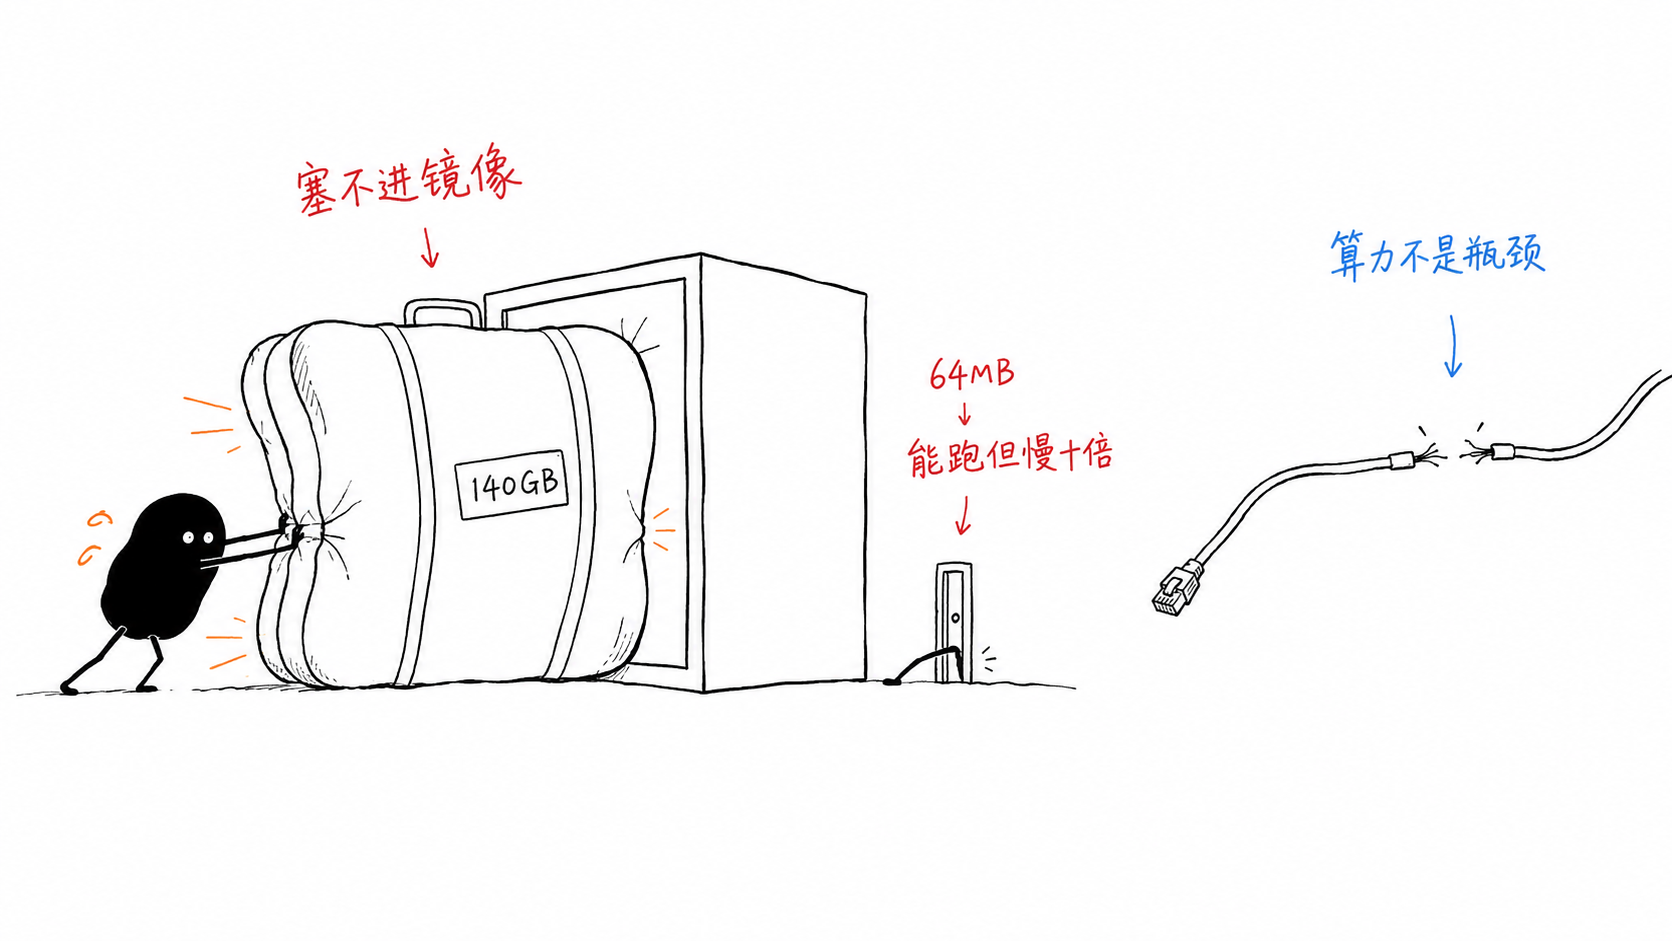
这四项做对,和裸金属直装的差距在测量噪声里;做错任何一项,损失是几倍量级——远大于「容器 vs 物理机」这个问题本身的影响。
驱动、toolkit、device plugin、DCGM、MIG 统一交给 NVIDIA GPU Operator 管,别手工维护版本矩阵。
裸金属直装还剩三个合理场景:性能调优和 kernel profiling(nsys/ncu 需要特权)、单机长期固定跑一个模型、改引擎源码时的本地迭代。
七、如果现在选
默认栈:
1 | |
每一层都在 CNCF / k8s-sigs 治理下,绑定风险最低。
三个变体:
- 已有 Istio:直接用 Istio 承接前三层,少维护一个数据面
- NVIDIA 重仓:把中间两层换成 Dynamo,接受与 DGX/HGX 的耦合,换取开箱的 PD 分离
- 不自建推理:只需要多供应商代理的话,AI 网关层用托管服务比自运维 LiteLLM 更划算,尤其在那次供应链事件之后
最后一点说明
上面关于「主导地位」的判断来自公开分析文章的综合,不是量化市占数据——这个领域没有可靠的份额统计。ingress-nginx EOL、Gateway API 版本节奏、GIE 的代码迁移这几件事是从官方来源核实过的,可以当事实用。容器计算开销近零这一点是从驱动架构推出来的,引用的实测数字来自第三方博客而非官方基准,量级可信,不必当精确值。