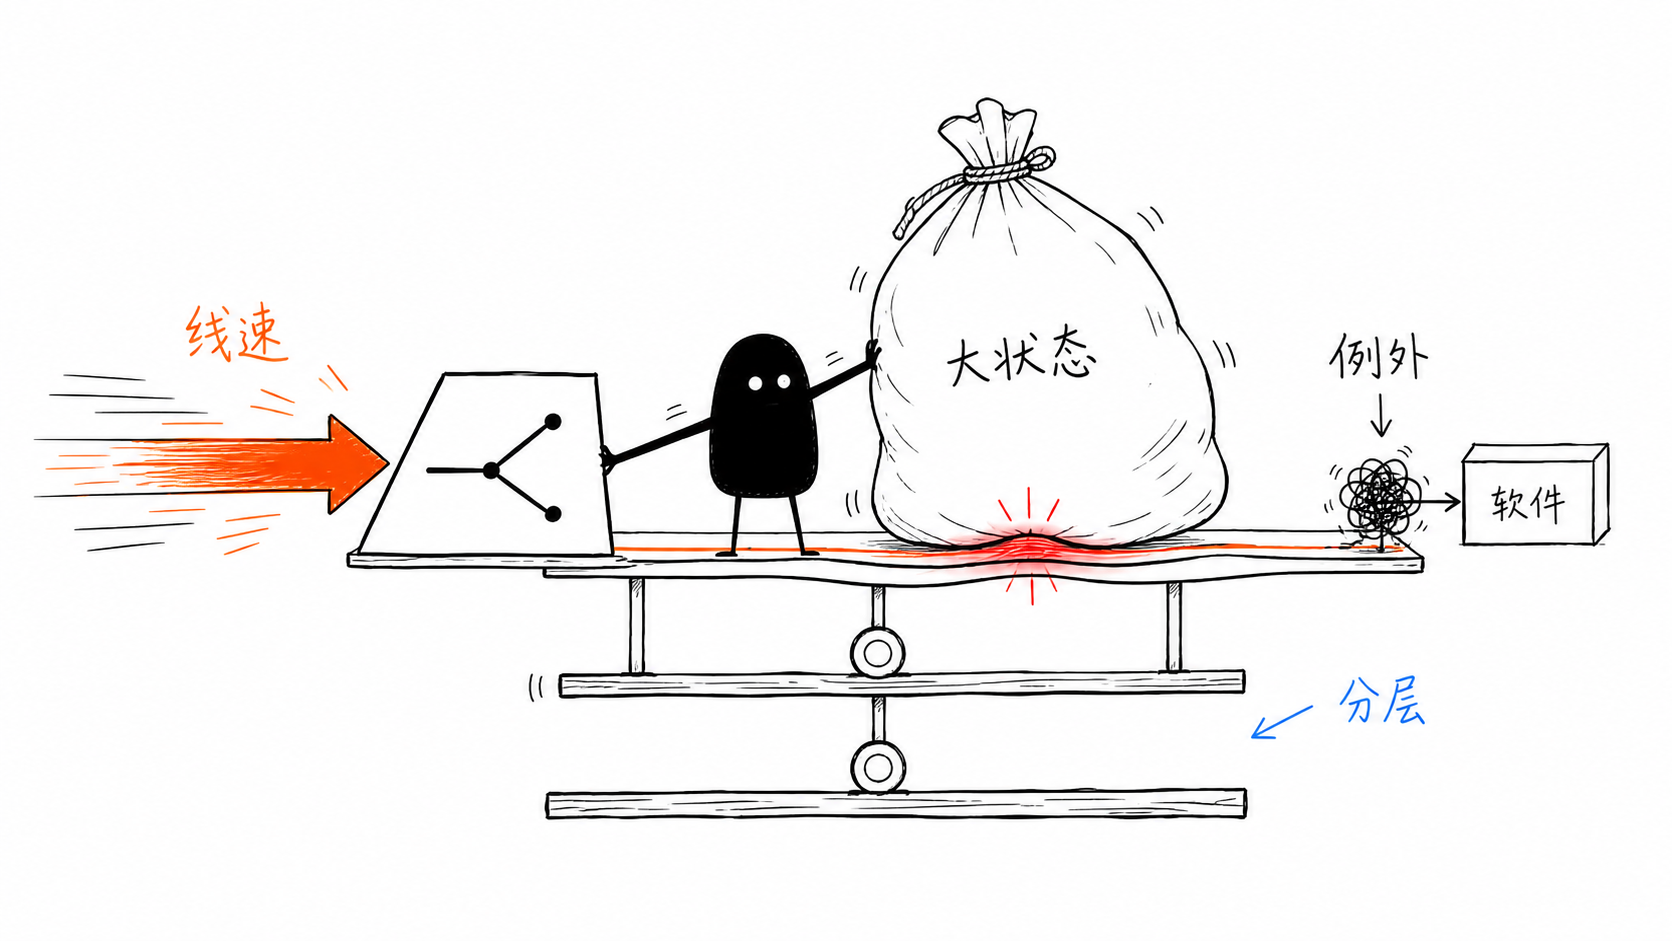
一台云网关同时遇到三种压力时,单一硬件很快会露出短板。流量要跑到 Tbps 级,租户隔离需要大量转发表,策略又在持续变化。交换 ASIC 擅长前两跳里的高速转发,却装不下所有状态。主机软件能处理复杂例外,CPU 又很难承担每个数据包。
SIGCOMM 2026 收录的 Gryphon,给出的答案是把这几件事拆开。它把 Intel Tofino 交换芯片、四块 AMD Pensando DPU 和 ARM 软件组织成一条三级数据路径。论文报告的设备线速为 1.6 Tbps,DPU 用片外 DDR4/5 DRAM 扩大状态容量,软件只接手硬件无法快速处理的少数情况。
我先对照了论文 PDF、arXiv HTML 和 SIGCOMM 的收录页面。最初我以为这会是一篇典型的 DPU 替代主机网关的文章,读完数据路径后发现重点在协作方式。DPU 没有把 Tofino 挪走,也没有把软件彻底清掉。
网关的瓶颈会随着硬件变化
Gryphon 之前,论文把网关演进分成两个阶段。
软件网关的状态容量大,功能也容易改,但论文给出的对比中,软件方案吞吐大约为 200 Gbps。流量倾斜时,长流可能集中到少数 CPU 核,热点会拖住整个节点。
后来采用 Tofino 的网关把吞吐提高到约 1600 Gbps,并保持微秒级转发延迟。问题变成了芯片内部的 SRAM 和 TCAM 不够用。VM 到物理主机的映射、租户策略和其他大表一旦挤进有限的片上资源,新增功能就会和已有转发逻辑争空间。
继续横向扩容看起来直接,代价却不小。论文的同口径估算显示,让软件方案达到 Tofino 的吞吐,大约需要 8 倍机架空间,功耗约为 8.89 倍,采购成本约为 6.67 倍。给 ASIC 增加节点来弥补状态容量,也会带来很高的每条目功耗和成本。
这就把网关问题从“选 ASIC 还是选软件”变成了“哪类工作应该放在哪一层”。
三条路径处理三类数据包
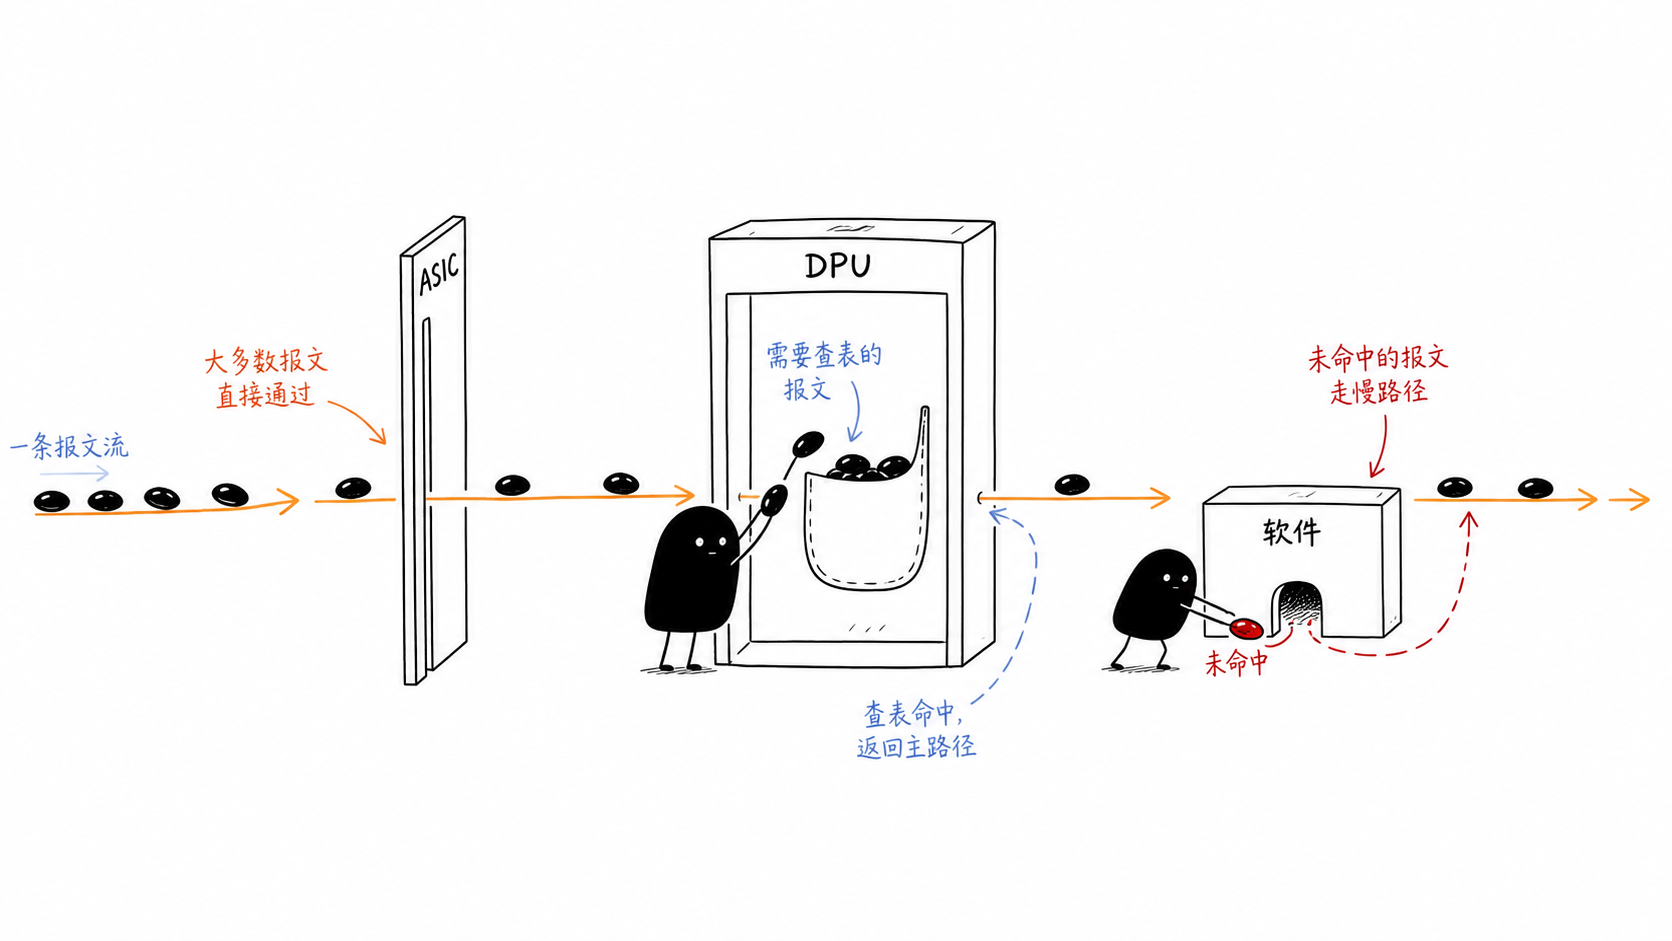
Gryphon 的核心是 Hierarchical Co-Offloading,也就是分层协同卸载。数据包先经过 Tofino 的 pre-DPU pipeline,只有确实需要额外状态或计算的流量才会被送进 DPU,之后再回到 Tofino 的 post-DPU pipeline。普通流量可以绕过 DPU,直接完成后续转发。
第一条是 switch-only path。跨地域、访问互联网或前往其他数据中心的流量,经过前置 Tofino 处理后直接绕过 DPU。这条路径保留了交换芯片的低延迟和线速能力。
第二条是 hybrid fast path。需要查询本地虚拟机映射的流量进入 DPU。DPU 先在片上 SRAM 中查找低延迟缓存,再访问 DDR4/5 DRAM 中的大容量状态。命中后,结果回到 Tofino 继续执行计量、路由、封装和校验等动作。
第三条是 software slow path。新流第一次到达、查询没有命中、版本已经过期,或者策略需要多步判断时,DPU 把数据包交给 ARM 核心上的 DPDK 程序。软件完成解析和规则安装后,后续同一流量可以回到硬件 fast path。
这个安排有一个很实用的含义。软件的成本主要由异常比例决定,而不是由总包速率决定。论文称,超过 99.9% 的流量被卸载到硬件 fast path。这个数字的价值不在于证明软件无关紧要,恰好相反,它说明软件仍然负责规则生成和例外处理,只是没有站在每个数据包的必经之路上。
关键工作发生在硬件之间
把 DPU 插入交换路径,不能只靠拉几根线。Gryphon 采用 folded Tofino pipeline,把四条管线串起来,并配置四块 DPU 以 ECMP 分担流量。这个 sandwich 结构把 DPU 放在同一条管线的入口和出口之间,论文报告的总线速仍为 1.6 Tbps。
互连本身也会产生开销。Gryphon 让 Tofino 先解析大表引用,只把压缩后的 1 到 3 字节索引交给 DPU,并把 DPU key 控制在 12 字节。论文还使用临时的精简报文格式,减少在内部链路上传递重复的以太网头和元数据。
控制面更新则采用版本号。规则被修改时,控制器增加版本,fast path 只做轻量检查。发现旧版本后,数据包进入 slow path,软件重新计算并安装新表项。这样做让 Tofino、DPU 和 DRAM 不必在每一次更新时都完成严格同步。
P4Bridge 负责把不同硬件呈现成一条逻辑流水线。控制面只操作逻辑表,系统再把它拆分、合并和映射到具体的物理表。对于网关开发者来说,这一层抽象很重要。DPU 和 ASIC 都能写 P4,并不意味着它们拥有相同的资源和微架构。
论文数据说明了什么
Gryphon 已在生产环境运行超过一年,部署在多个集群的数百个网关节点,覆盖五个可用区。论文给出的年度流量曲线峰值超过 1 Pbps。生产观测还显示,slow path 只承接极少比例的流量,这与分层设计的预期一致。
实验把活跃流表从 1K 扩展到 10M。Gryphon 和 Tofino 方案在整个范围内保持零丢包,软件方案在超过 5M 流后出现明显退化,峰值规模下丢包超过 5%。在 4M 流以内的稳定区域,Gryphon 相比软件方案平均延迟降低 68.7%,P99 延迟降低 79.3%,相对于只使用 Tofino 的设计额外增加约 8 微秒。
这些结果足以支持一个判断。DPU 的加入确实扩大了网关可以承载的状态范围,也把复杂功能从 ASIC 里移了出来。它仍然不能证明任何网关接入 DPU 后都能得到同样收益。论文的硬件组织、表项分布、流量特征和控制面实现都和部署环境有关。
我的判断
Gryphon 最值得借鉴的地方,是它把“硬件卸载”写成了一个有退路的层级系统。常见流量走 ASIC,较大的状态和可编程逻辑放进 DPU,真正的例外才进入软件。三层之间通过路径选择、元数据压缩、版本更新和统一表抽象连接起来。
这比单纯追求更快的芯片更接近网关的真实工作。网关长期面对的麻烦通常来自状态规模、租户隔离、策略变更和少量难以预料的例外。把所有逻辑压进 ASIC,更新会变慢。把所有逻辑留给软件,吞吐和尾延迟又会受影响。
对正在设计高性能网关的团队,我会先画出三张清单。哪些请求必须线速完成,哪些表需要 GB 级存储,哪些情况可以接受微秒级额外延迟。随后再决定硬件分层。若没有清楚的流量分类和 slow path 回填机制,采购 DPU 只会增加一段更难排查的链路。
论文公开材料能说明架构已经在一个大规模生产环境中工作,也能说明它在 10M 流压力下的表现。它没有公开完整 TCO、所有业务的 SLO 分布和跨硬件故障恢复细节。我的结论也停在这里。Gryphon 不是一块神奇的加速卡,它是一种把不同硬件的长处排列到同一条数据路径上的工程方法。
参考资料