先摆三个数。
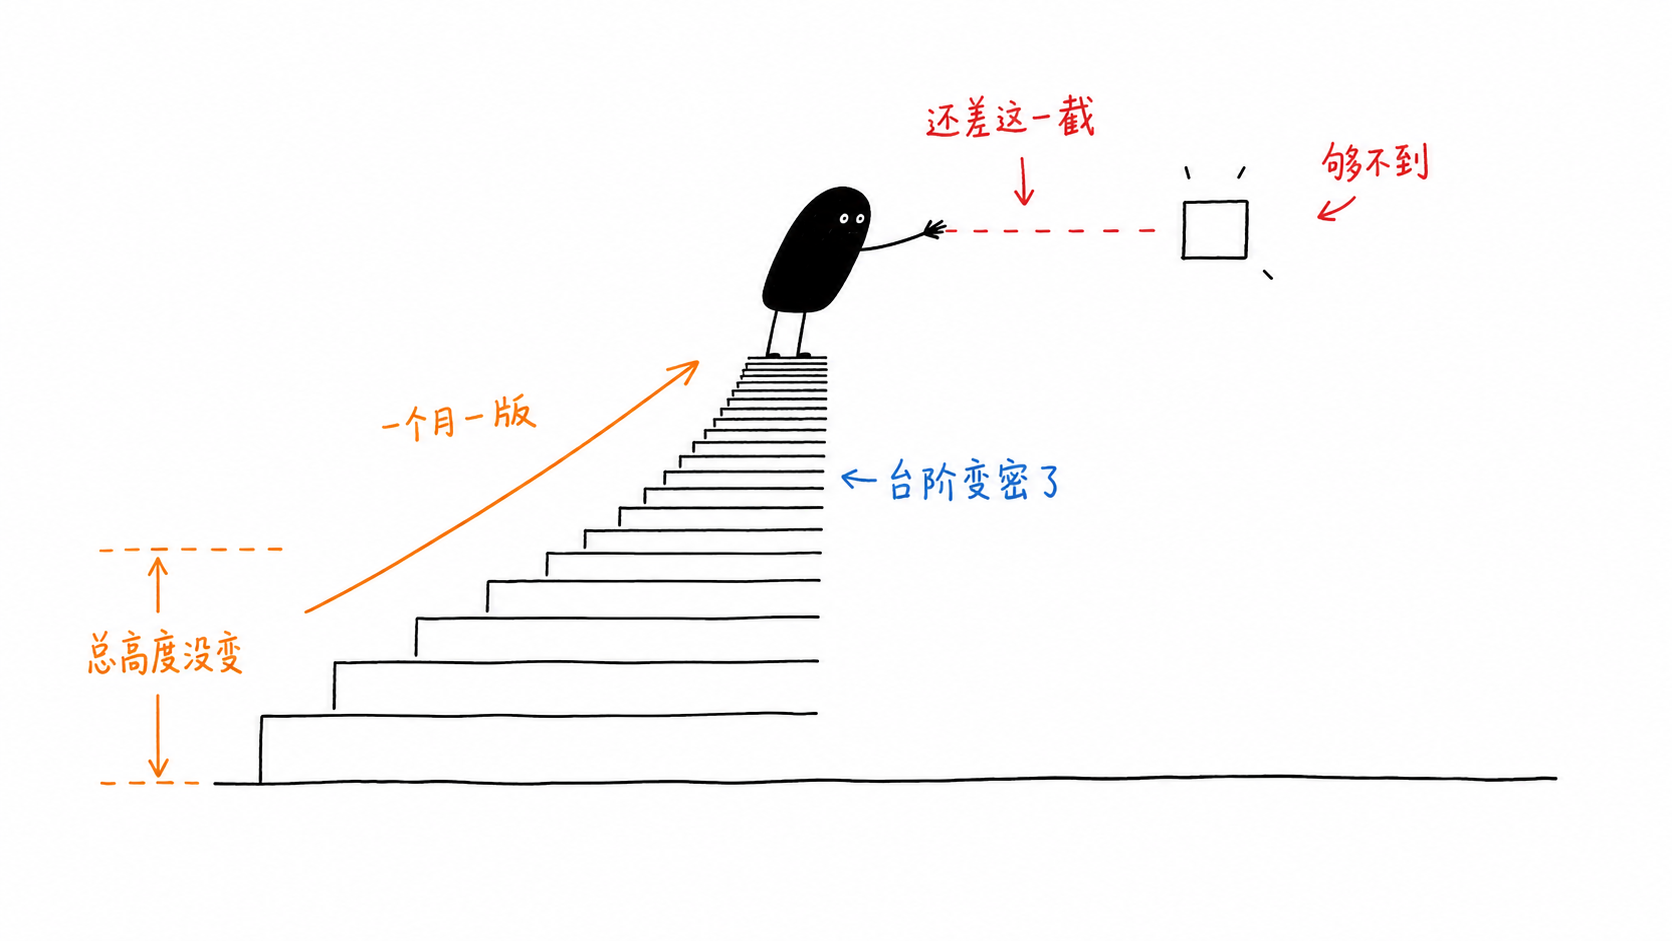
Anthropic 2026 年前 8 个月发了 8 次模型,244 天 8 次,平均 30.5 天一次;2025 年是约 61 天一次,2024 年是约 122 天一次——三年对折了两次。同一段时间里,Veracode 累计测了 150 多个大模型,AI 生成代码的语法正确率从 2023 年的约 50% 升到 超过 95%,安全通过率从约 55% 走到……约 55%。而 METR 在 2026 年 4 月测到的最强模型,能以 80% 成功率完成的任务长度是 185.9 分钟,也就是 3.1 小时。
这三个数放一起就是本文的全部论点:发版频率、coding 占比、coding 能力上限,是三条独立的曲线,被大多数讨论当成了一条。
一、发版频率:先定义你在数什么
Anthropic:三年对折两次,代价写在弃用页上
Anthropic 从不公开宣布”发布日期”这种结构化字段,但它的模型弃用页给了每个模型 “Tentative retirement date: Not sooner than X”。用两个已知锚点校准——claude-sonnet-4-5-20250929 的退役下限是 2026-09-29,claude-3-7-sonnet-20250219 实际在 2026-02-19 退役——规律是发布日 + 整 12 个月。倒推出来的时间线:
| 模型 | 倒推发布日 | 官方定位原文 |
|---|---|---|
| Fable 5.1 | 2026-09-01 | “For demanding reasoning and long-horizon agentic work” |
| Opus 5 | 2026-07-24 | “For complex agentic coding and enterprise work” |
| Sonnet 5 | 2026-06-30 | “The best combination of speed and intelligence” |
| Fable 5 | 2026-06-09 | — |
| Opus 4.8 | 2026-05-28 | — |
| Opus 4.7 | 2026-04-16 | — |
| Sonnet 4.6 | 2026-02-17 | — |
| Opus 4.6 | 2026-02-05 | — |
这是倒推值,不是官方公布的发布日,引用时必须这么写。两个第三方源独立印证了其中两个(Fable 5 = 2026-06-09、Opus 5 = 2026-07-24),我才敢用。
弃用页上有一句话值得整段抄下来:”Anthropic currently deprecates and retires models to ensure capacity for new model releases.” 它把发版频率和退役直接绑在一起了——发得快的代价是老模型必须腾容量。同一页还老实承认了三项代价:用户被迫迁移、研究者失去做对比研究的模型、以及”model retirement introduces safety- and model welfare-related risks”。现在模型寿命基本固定在 12 个月:Opus 4.1 是 2025-08-05 到 2026-08-05,Sonnet 3.7 是 2025-02-19 到 2026-02-19,都是整年。
Google:Flash 线跑到 3.7,Pro 线停在 3.1
这是本文最有说服力的一个反例,而且全部来自官方 changelog。
Gemini 3 Pro Preview 上线 2025-11-18,Gemini 3.1 Pro Preview 上线 2026-02-19。此后到今天(2026-09-02),Pro 线一个新版本都没有。同期 Flash 线:3 Flash Preview(2025-12-17)→ 3.1 Flash-Lite Preview(2026-03-03)→ 3.1 Flash-Lite GA(05-07)→ 3.5 Flash GA(05-19) → 3.6 Flash + 3.5 Flash-Lite GA(07-21) → 3.7 Flash GA(08-13)。3.7 Flash 的官方描述是 “most intelligent workhorse model yet for coding and agents“。
Gemini 3.5 Pro 原定 2026 年 6 月发(I/O 上宣布的),跳票了。Pichai 在 7 月 22 日的财报电话会上避开了这个话题,转去谈 Gemini 4,并说了两句很值得记的话:”We are creating a baseline on top of which you will see us rapidly iterate on subsequent model releases.” 以及 “picking up pace and releasing models almost at a monthly cadence is part of our road map”。提问的是 Barclays 的 Ross Sandler 和 JPMorgan 的 Douglas Anmuth,后者问的正是”发版频率对比竞争对手”。
延期原因据 Bloomberg 7 月 16 日报道,是coding 结果没达到对标 OpenAI 和 Anthropic 的内部目标(这条是二手,需标注)。如果这个报道成立,那它就是本文标题的最强证据:一家承诺”月度节奏”的公司,被 coding 这一项卡住了旗舰推理模型的发版。
顺手说清楚”频率”这个指标的坑
同一段 244 天里,Gemini 的发版次数可以是两个数:只数语言模型(Pro / Flash / Flash-Lite 的 preview 或 GA)约 6–7 次,约 35–40 天一次;把 image、video、TTS、embedding、robotics、transcribe、Gemma 全算上约 23 次,约 10.6 天一次。两个数都对,差 3.7 倍。所以看到任何”某家 X 天发一版”的说法,先问计数规则。本文统一只数语言模型的对外可用版本。
OpenAI:版本号最密,模型寿命最短
OpenAI 2026 年的语言模型序列是 GPT-5.3-Codex(2026-02-05)→ 5.4(03-05)→ 5.5(04-24 进 API)→ 5.6(06-26 限量预览、07-09 公开)→ 5.6-Cyber(08-10),约 46 天一次(这几个日期部分来自二手源,OpenAI 官网对 WebFetch 返回 403,我没能逐个从一手页面核实)。
真正能一手确认的是另一头:GPT-5.1 系列在 2026-03-11 从 ChatGPT 下线。GPT-5.1 是 2025 年 11 月发的,寿命不到 4 个月,是 Anthropic 那 12 个月的三分之一。o3 给了 90 天日落期,GPT-4.5 只给了 30 天。发版频率的另一面就是弃用速度,这一点两家的策略差异比发版间隔本身更大。
DeepSeek 在放慢,Qwen 在加速
这一对的分化很干净。DeepSeek 从 2024-05-06 到 2026-08-21 发了 17 次,总体平均间隔 52.3 天,但按年分是 2024 年 46.8 天 → 2025 年 48.6 天 → 2026 年 65.8 天,在放慢;期间还有一段 144 天的空窗(2025-12-01 → 2026-04-24),然后 22 天里连发 3 次。Qwen 同期 27 次,总体平均 33.8 天,按年分是 2024 年 75.7 天 → 2025 年 37.0 天 → 2026 年 25.8 天,在加速,光 2026 年就把 3.5 走到了 3.8。
DeepSeek-R2 至今没发,Qwen4 也没发。 两家把算力都投在了小版本号的迭代上,而不是下一代架构。
DeepSeek 自己在 V4-Pro 的材料里说落后前沿 “by approximately 3 to 6 months”,并且明确标注它的 agent 分数用的是 “the DeepSeek Harness minimal mode … with the max effort level”。这个自我标注比分数本身重要——同一份权重换 harness,分数能差 10–20 个百分点,后面还会提到。
二、coding 占了多少:三个口径,答案都不是”大部分”
口径一:产品分层
Anthropic 现在四个在售模型里,顶配 Opus 5 的官方一句话定位就是 “For complex agentic coding and enterprise work”,Fable 5.1 是 “long-horizon agentic work”。Google 3.7 Flash 是 “coding and agents”。OpenAI 的 GPT-5.2-Codex 是 “The most advanced agentic coding model for professional software engineering and defensive cybersecurity.”,GPT-5.6 的西语版发布说明里,Sol 的用途列表 “programación, investigación, ciencia, ciberseguridad, uso del ordenador” 把 programación 排在第一位。
四家的旗舰定位都用 coding 或 agentic 打头。这不是某次发布的卖点,是产品分层的主轴。
口径二:token
OpenRouter 的数据最直接:2026-02-06 前后,agentic token 首次超过人类 token(它自己的博文写 “around February 1, 2026, agentic tokens overtook human tokens”)。到 2026-08-10,agentic token 约 7.3 万亿,比 2 月的约 0.51 万亿涨了 14 倍;人类 token 约 1.4 万亿,同期只涨 2.8 倍。agent 现在烧的 token 是人类的约 5 倍,而单位成本差是 “about 15x more per request”。
但要注意:OpenRouter 只把流量分 Agentic / Mixed / Human 三类,在 API key 层面用一个 “7-signal weighted composite score” 判定,它从来没公开过”编程类别占多少 token”。它 SDK 文档里那个 categoryTokenShare: 0.48 的 “Code Generation” 是文档示例占位值,不是统计结果,看到有人引这个数就可以判定该文没做核实。
口径三:会话内部——这里有个反直觉的结论
Anthropic 2026-06-16 发了一份基于 约 40 万个交互式 Claude Code 会话、约 23.5 万人(2025-10 → 2026-04)的分析。在一个纯粹的编程工具里:
“About 56% of sessions consist of writing (25%), fixing (26%), or testing and orchestrating code (5%)”
coding 只占 56%。剩下 44% 是:操作软件 17%、规划或探索 14%、产出分析或文字 13%。
更值得注意的是七个月内的漂移方向:修坏代码 33% → 19%,操作软件 14% → 21%,写作与数据分析 约 10% → 20%(翻倍)。在一个 coding 工具内部,coding 占比是在下降的。
同一份报告给了分工的量化结论:”people make about 70% of the planning decisions but only 20% of the execution decisions”,一句话概括是 “People decide what to build, and the agent decides how to build it.”
另一份 2026-06-26 的报告补了两个对照数字:Claude.ai 聊天侧的代码与技术工作只占 “about a sixth”(约六分之一);而 Claude Code 侧 “54% are served by Opus, against 10% of chat and Cowork conversations”。顶配模型的用量高度集中在 coding 工具里——这解释了为什么各家的旗舰都拿 coding 定位,即便 coding 在总使用量里远不是大头。
至于”coding 占企业 AI 用量 51%”“Anthropic 在企业 coding 市场占 54%”这类数字,我查到的所有来源都没有公开方法论,且互相转抄。只能当方向性陈述,不能当硬数字。
三、上限在哪里:三个互不相干的测量传统,指向同一件事
METR 的时间跨度:中位数涨到 17 小时,可交付长度只有 3.1 小时
METR 的 benchmark_results_1_1.yaml(页面最后更新 2026-05-08)给每个模型两个数:p50 是”一半会成”的任务长度,p80 是”八成会成”的任务长度。单位分钟。
| 模型 | 发布日 | p50 | p80 | p50/p80 |
|---|---|---|---|---|
| gpt-4 | 2023-03-14 | 3.99 | 0.89 | 4.5× |
| claude-3.7-sonnet | 2025-02-24 | 60.39 | 12.09 | 5.0× |
| claude-4-opus | 2025-05-22 | 100.37 | 20.43 | 4.9× |
| claude-4.1-opus | 2025-08-05 | 100.47 | 23.46 | 4.3× |
| gpt-5 | 2025-08-07 | 203.01 | 38.31 | 5.3× |
| claude-opus-4.5 | 2025-11-24 | 292.99 | 49.43 | 5.9× |
| gpt-5.2 | 2025-12-11 | 352.25 | 66.00 | 5.3× |
| claude-opus-4.6 | 2026-02-05 | 718.81 | 69.87 | 10.3× |
| gpt-5.3-codex | 2026-02-05 | 349.53 | 54.74 | 6.4× |
| gemini-3.1-pro | 2026-02-19 | 384.15 | 89.80 | 4.3× |
| gpt-5.4 | 2026-03-05 | 341.74 | 53.88 | 6.3× |
| claude-mythos-preview | 2026-04-07 | 1044.78 | 185.91 | 5.6× |
从这张表能读出四件事,以下都是我自己在这份 yaml 上算的,不是 METR 的结论:
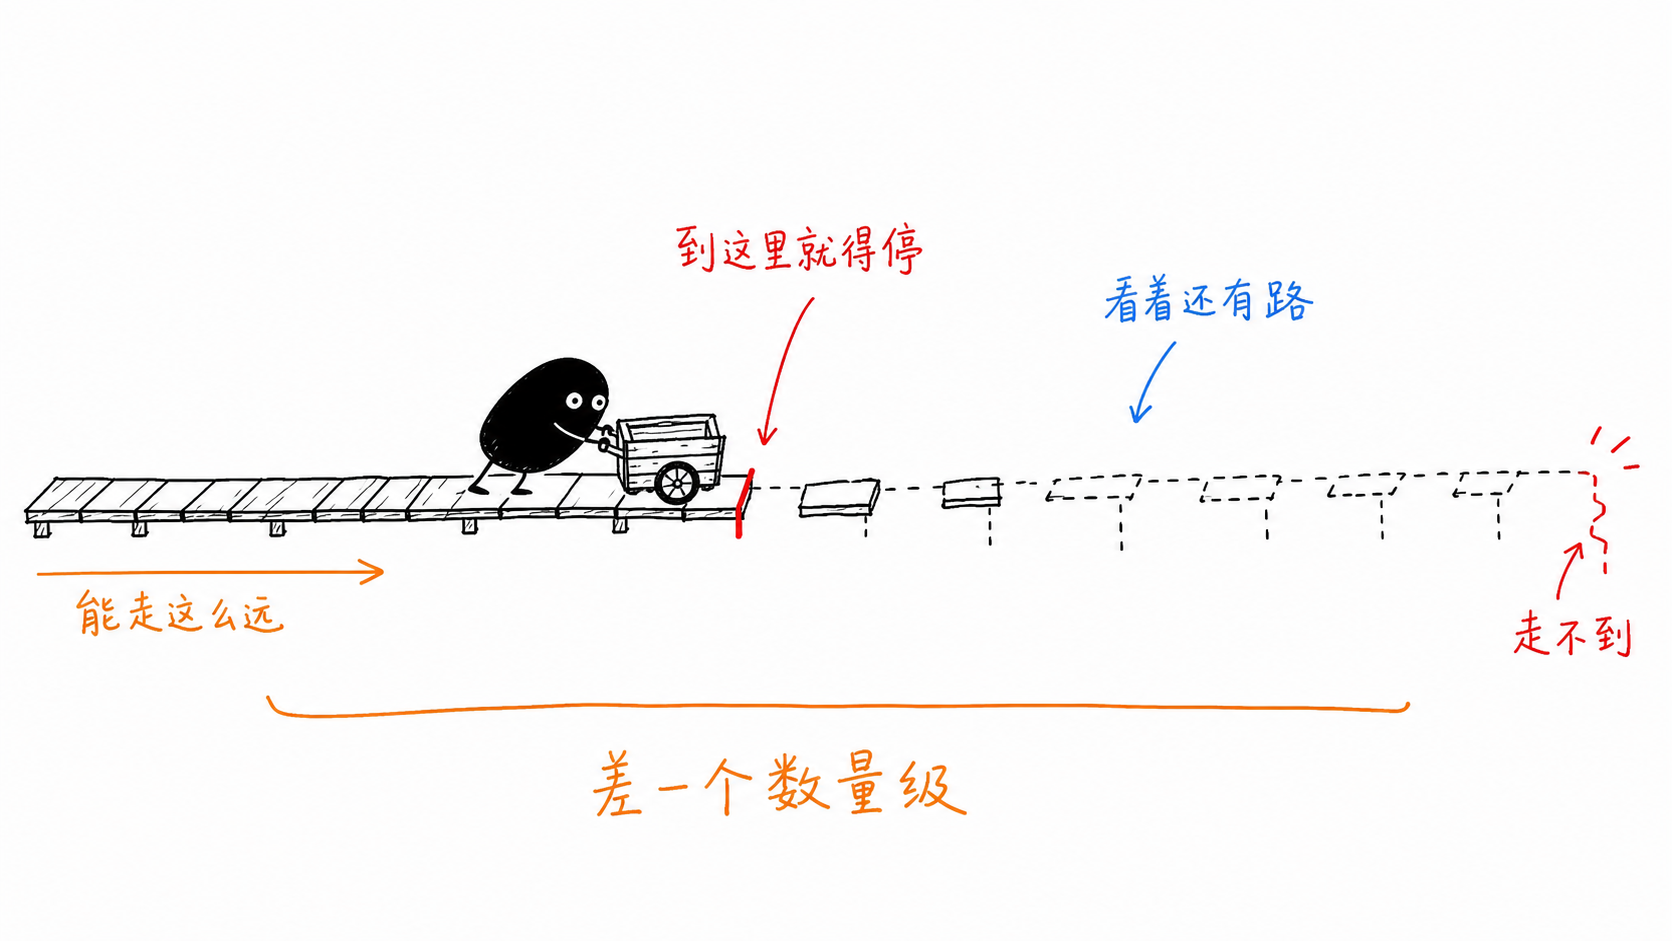
第一,80% 可靠度下的真实上限只有 3.1 小时。2026-04-07 那个 Mythos Preview(后来的 Fable 5)p50 是 1044.8 分钟(17.4 小时),但 p80 只有 185.9 分钟。到处被引用的”AI 已经能自主工作 17 小时”用的是 p50——那是”一半会失败”的长度,不是能交付的长度。
第二,p50/p80 的比值三年没收窄。2023 年 gpt-4 是 4.5×,2026 年 Mythos Preview 还是 5.6×,Opus 4.6 甚至到 10.3×。可靠度的代价恒定在一个数量级左右,没有随能力增长被摊薄。
第三,置信区间在顶部爆炸。Opus 4.6 的 p50 区间是 316.7–3633.8 分钟,跨 11.5 倍;Mythos Preview 是 508.9–3304.3。METR 自己在 2026-05-08 加了一句注:”Measurements above 16 hrs are unreliable with our current task suite.” 所以”12 小时”“17 小时”这类数字本身就不该当结论用。
第四,发版和能力不是同一条曲线,表里有两处硬证据。OpenAI 侧 gpt-5.2(352.2)→ gpt-5.3-codex(349.5)→ gpt-5.4(341.7),三次发布、四个月,p50 微降;Anthropic 侧 claude-4-opus(100.37)→ claude-4.1-opus(100.47),跨 75 天几乎零变化。
METR 自己的口径限制也要一起读:跨度衡量的是任务难度而不是自主运行时长;人类基线来自承包商完成时间的几何均值,METR 认为这”likely overestimate how long a human expert takes”;2 小时跨度的含义是”一个低上下文的人能做的量”,不是高上下文专业人士;在 90 分钟到 3 小时这个区间实测下来,GPT-5 大约三分之一的任务每次都成、三分之一每次都败。另外 METR 的立场很明确:它看不到 “evidence of the exponential growth in time horizon slowing down”。指数还在,只是那条指数描述的是 p50。
真实会话的成功率:专家也只有三成”可验证成功”
同一份 40 万会话的分析里有第二个天花板数字,而且是在真实工作而不是 benchmark 上测的:
- verified success(可验证成功):新手 15%,中级及以上 28–33%
- partial success(部分成功):新手 77%,其余 91–92%
- 会话中途遇到麻烦时,verified success 从 4%(新手)到 15%(专家)
- “19% of sessions where the user appears to be a novice end abandoned, against 5-7% for everyone else”
专业度能把成功率从 15% 抬到 33%,然后就抬不上去了。顺带一个反常识的数字:软件类职业的 verified success 约 30%,其他职业约 26%,而且 “every one of the ten largest occupations in our dataset lands within seven points of software engineers”,管理类职业甚至略高于软件类。这套工具的收益不是软件工程师独占的,同时它的失败率也不是。
Veracode:语法从 50% 到 95%,安全从 55% 到 55%
这是我见到的最硬的横截面证据。Veracode 2026-03-24 的报告用 80 个编码任务、4 种语言、4 类 CWE,不加安全提示直接跑自家 SAST,累计评测了 150 多个大模型,自称是 “the most comprehensive longitudinal study of AI code security available”。结论一句话:
“Two years of ‘revolutionary’ model releases have moved the security needle from approximately 55% to… approximately 55%.”
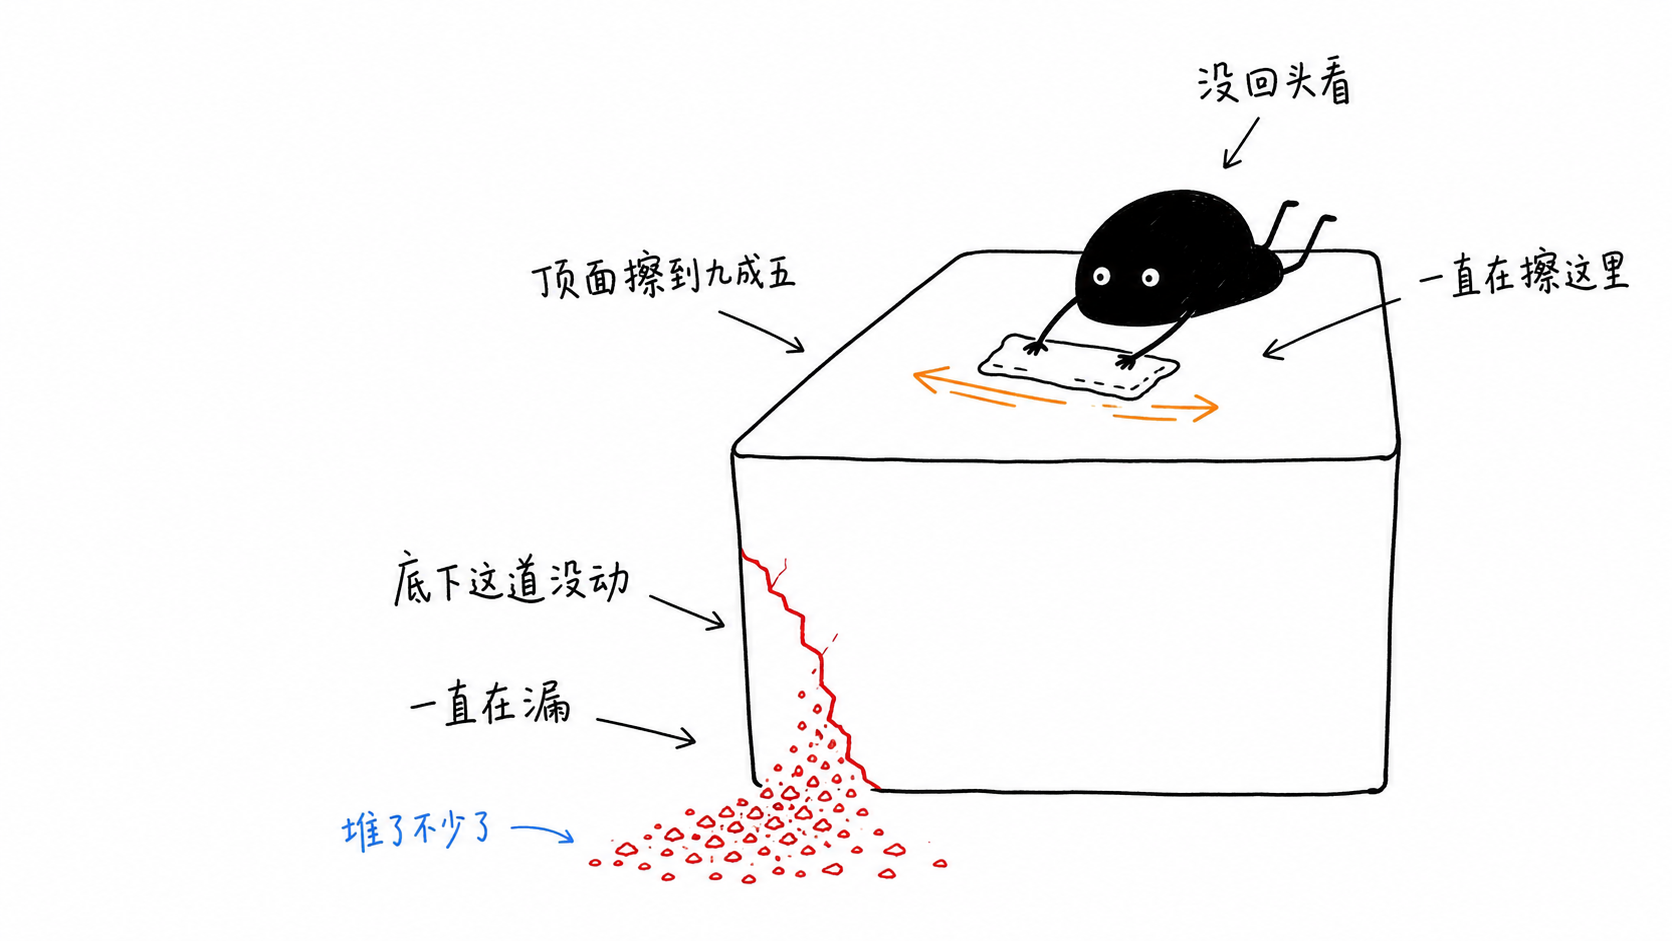
同期语法正确率从 2023 年的约 50% 升到 超过 95%。Veracode 的判断是 “The gap between ‘code that works’ and ‘code that works securely’ isn’t just persisting; it’s widening.”
失败的分布不是随机的,这是最关键的部分:
- 强项:不安全加密 CWE-327 86%、SQL 注入 CWE-89 82%
- 弱项:XSS CWE-80 15%、日志注入 CWE-117 13%
通过的都是局部模式识别就能解决的类别,失败的都是需要跨函数跟踪数据流的类别。而且按 10 月版报告的说法,XSS 和日志注入上 “models generally perform very poorly and appear to be getting worse.”
分语言同理:Python 62%、C# 58%、JavaScript 57%、Java 29%,Veracode 归因于训练语料里过时 Java 占比过高。
换更大更新的模型有用吗?基本没有。模型规模对安全表现 “only a very small effect”,20B 到 400B 都聚在 55% 附近;GPT-5.1 / 5.2 与 GPT-4.1 在误差范围内;Claude 4.5 / 4.6 在安全性上与更早版本持平。唯一的例外是 GPT-5 系列开长推理能到 70–72%,Veracode 认为是推理过程起了内部 review 的作用——但那仍然是约三分之一的失败率,而且它证明的恰好是”多花推理”而不是”换新版本”。
benchmark 侧:OpenAI 亲手废掉了自己造的尺子
2026 年 2 月,OpenAI 发文《Why SWE-bench Verified no longer measures frontier coding capabilities》,明确停止用它评估前沿能力。SWE-bench Verified 是 OpenAI 自己在 2024 年 8 月发布的。理由里那个数字很说明问题:过去 6 个月,准确率只从 74.9% 提升到 80.9%。污染原因它写得也直白,benchmark 和仓库 “both open source and broadly used and discussed, which makes avoiding contamination difficult for model developers”,另一篇姊妹文章直接说它 “no longer provided meaningful signal”。
继任者是 Scale AI 的 SWE-bench Pro,1,865 个长时程任务,覆盖公开 / held-out / 商业代码库,自称 “contamination-resistant testbed”。俄亥俄州立的 Yu Su 对这轮换代的评价是:”Every benchmark has its shelf life.”
四、两个流传很广的数字,需要纠正
“AI 让开发者慢 19%”——METR 自己推翻了,但替代结论跨过零
2025 年那个 RCT 结论(任务耗时 +19%,CI +2%~+39%)传播极广。METR 在 2026-02-24 发了更新:第二轮 57 人、143 个仓库、800+ 任务,开发者经验中位数 10 年。
| 队列 | 点估计 | 95% CI |
|---|---|---|
| 2025 早期原研究 | +19%(变慢) | +2% ~ +39% |
| 2025 晚期,10 位回访者 | −18%(加速) | −38% ~ +9% |
| 2025 晚期,新招募者 | −4%(加速) | −15% ~ +9% |
两个新结果的置信区间都跨过零,既证不出加速也证不出减速。所以正确的表述不是”从慢 19% 变成快 18%”,而是”原来那个负结论不再成立,但新结论在统计上和零无法区分”。
真正有意思的是 METR 为什么放弃这个实验设计。招募不到人了:越来越多开发者 “would not want to do 50% of their work without AI”;已入组的人里 “30% to 50% of developers told us that they were choosing not to submit some tasks”。有一位开发者干脆”没有完成任何一个被分配到禁用 AI 组的任务”。两个方向的选择偏差都剔掉了收益最高的人和最高的任务,所以 METR 把自己的估计当下限而不是最佳估计,并且自评 “our data is only very weak evidence for the size of this increase”。
一句原始回复很能说明这个设计已经走不通了:”my head’s going to explode if I try to do too much the old fashioned way”。当对照组本身不可招募时,RCT 这条路就断了——这也是为什么后面很难再有一个干净的因果数字。
“某模型 SWE-bench 95% 登顶”——榜上 100 条里 99 条是自报
这条我没能从一手源核实,所以只说它的定性部分:这类榜单的分数绝大多数是厂商自报,同一份权重换成标准化 harness,分数能差 10–20 个百分点。前面 DeepSeek 主动标注自己用 “the DeepSeek Harness minimal mode … with the max effort level”,是少见的诚实做法。看 coding 分数先看 harness,再看是谁跑的。
五、采用度和信任度正在背离
Google DORA 2025(近 5,000 名从业者):90% 在工作中用 AI,比上一年 +14 个百分点;超过 80% 认为提升了生产力。
Stack Overflow 2025(2025-12-29 发布):84% 在用或计划用(上年 76%),但信任其准确性的只有 29%,从 2024 年的 40% 掉下来;主动不信任的 46% 超过信任的 33%,只有 3% 报告”高度信任”;66% 说要花时间修”几乎对但不完全对”的代码。
用的人在涨,信的人在跌。这两条曲线的交叉点就是本文讲的天花板在真实工程里的样子:模型能把 95% 的代码写对,剩下 5% 的定位成本没降,而信任是按最坏情况定价的。
代码质量侧还有一批数字指向同一个方向,但都是二手、我未能直接核实(原页 403):GitClear 2026 年的报告称 commit 内复制粘贴 +41%、代码块重复 +81%、错误屏蔽构造 +47%、两周内 churn +15%;它更早的 2021→2024 研究(2.11 亿行)称重复代码块增至 8 倍、重构下降 60%、churn 从约 3.3% 升到 5.7%。另有一个开放数据集(429 个 AI 生成项目、2,160 万行)称 14% 泄露了密钥或硬编码凭据。方向一致,精度不可信,别拿去做决策。
我的判断
一、发版频率已经和能力增长解耦,而且开始反向指示。30.5 天一版这个节奏不可能由预训练突破驱动——三年对折两次的曲线跟算力和数据的增长曲线不是一个形状。它更像是把后训练、工具使用、harness 调优这些增量拆成小版本连续出货。反过来看 Google:Pro 线冻了 6 个多月,据报道正是因为 coding 没达标。冻结的那条线才是能力线,跑得快的那条线是产品线。
二、天花板的位置不在”能做多难的任务”,而在”能不能不用回头检查”。三个互不相干的测量传统给出的是同一个形状:METR 的 p50 三年涨了 260 倍而 p50/p80 的比值一动不动;Anthropic 自己 40 万会话里专家的可验证成功率停在三成;Veracode 四年 150 多个模型的安全通过率停在 55%。中位能力在指数增长,尾部可靠性在原地。所有”AI 能自主干 N 小时”的说法,把 N 换成 p80 的数就都缩水到三小时级。
三、失败集中在需要跨函数追踪状态的地方,这不是规模能解决的。Veracode 的分类别数据是本文最有诊断价值的一段:局部模式(加密选型、SQL 拼接)通过率 82–86%,需要数据流跟踪的(XSS、日志注入)13–15%,而且在变差。这和 METR”任务越长成功率掉得越快”、和 Anthropic”遇到麻烦后专家也只有 15%”是同一个现象的三个侧面——上下文里的隐式状态越多,模型越不行,而这恰好是真实代码库区别于 benchmark 的核心特征。
四、coding 是产品分层的主轴,但不是用量的大头,这两件事同时成立。顶配模型 54% 的用量在 coding 工具里,所以旗舰必须拿 coding 定位;但 coding 工具内部 coding 只占 56%,还在往操作软件和写作分析漂。“coding 占比”这个问题问的其实是三个不同的分母,混用会得到从六分之一到 51% 的任何答案。
五、给工程实践的结论只有一条:把 review 预算按 p80 定,不要按 p50 定。多花推理(GPT-5 长推理把安全通过率从 55% 抬到 70–72%)比换新版本更有效;把任务切到 3 小时以内比让 agent 跑 17 小时更有效;对 XSS、日志注入、以及任何需要跨文件追数据流的改动,Veracode 那句 “the human security review remains irreplaceable” 目前没有被任何数据推翻。
值得盯的几个日期和信号
- Gemini 3.5 Pro 或 Gemini 4 的实际发布时间。Gemini 4 已确认在预训练(2026-07-21 公告尾部)。Pro 线一旦解冻,就能验证”卡住的是 coding”这个报道;继续冻着则更说明问题。
- METR 什么时候补上 Opus 4.7 / 5、GPT-5.5 / 5.6、Grok 4.3 的跨度数据。现在 yaml 里最新的一条是 2026-04-07,五个月没更新,而这期间各家发了十几次。
- p80 有没有第一次跨过 8 小时。这是”能不能不回头检查一个工作日”的临界点。p50 破 16 小时按 METR 自己的注是不可信测量,别当信号。
- Veracode 下一版(预计秋季)的安全通过率有没有离开 45–55% 区间。四年没动过,任何一次显著位移都是真突破。
- 有没有出现第三方标准化 harness 的公认榜单。只要分数还是厂商自报,10–20 个百分点的 harness 差就足以让任何跨厂商比较失效。
- Anthropic 的 12 个月寿命会不会随着 30 天节奏继续缩短。弃用页那句 “to ensure capacity for new model releases” 说明这两个数是同一个约束下的两端。
本文所有数字的性质已在正文逐条标注。一手源:Anthropic 模型总览页与弃用页(2026-09-02 实测)、Anthropic Economic Index(2026-06-16 / 06-26)、METR benchmark_results_1_1.yaml 与 2026-02-24 uplift update、Veracode(2026-03-24)、Google Gemini API changelog、OpenRouter 官方 blog、Stack Overflow 2025 调查。Anthropic 的发布日期全部为按官方退役承诺倒推;Bloomberg 关于 Gemini 延期原因、GitClear 的质量数字、以及收入与市场份额相关数字均为二手,正文已标注。